目录
常见原理
架构
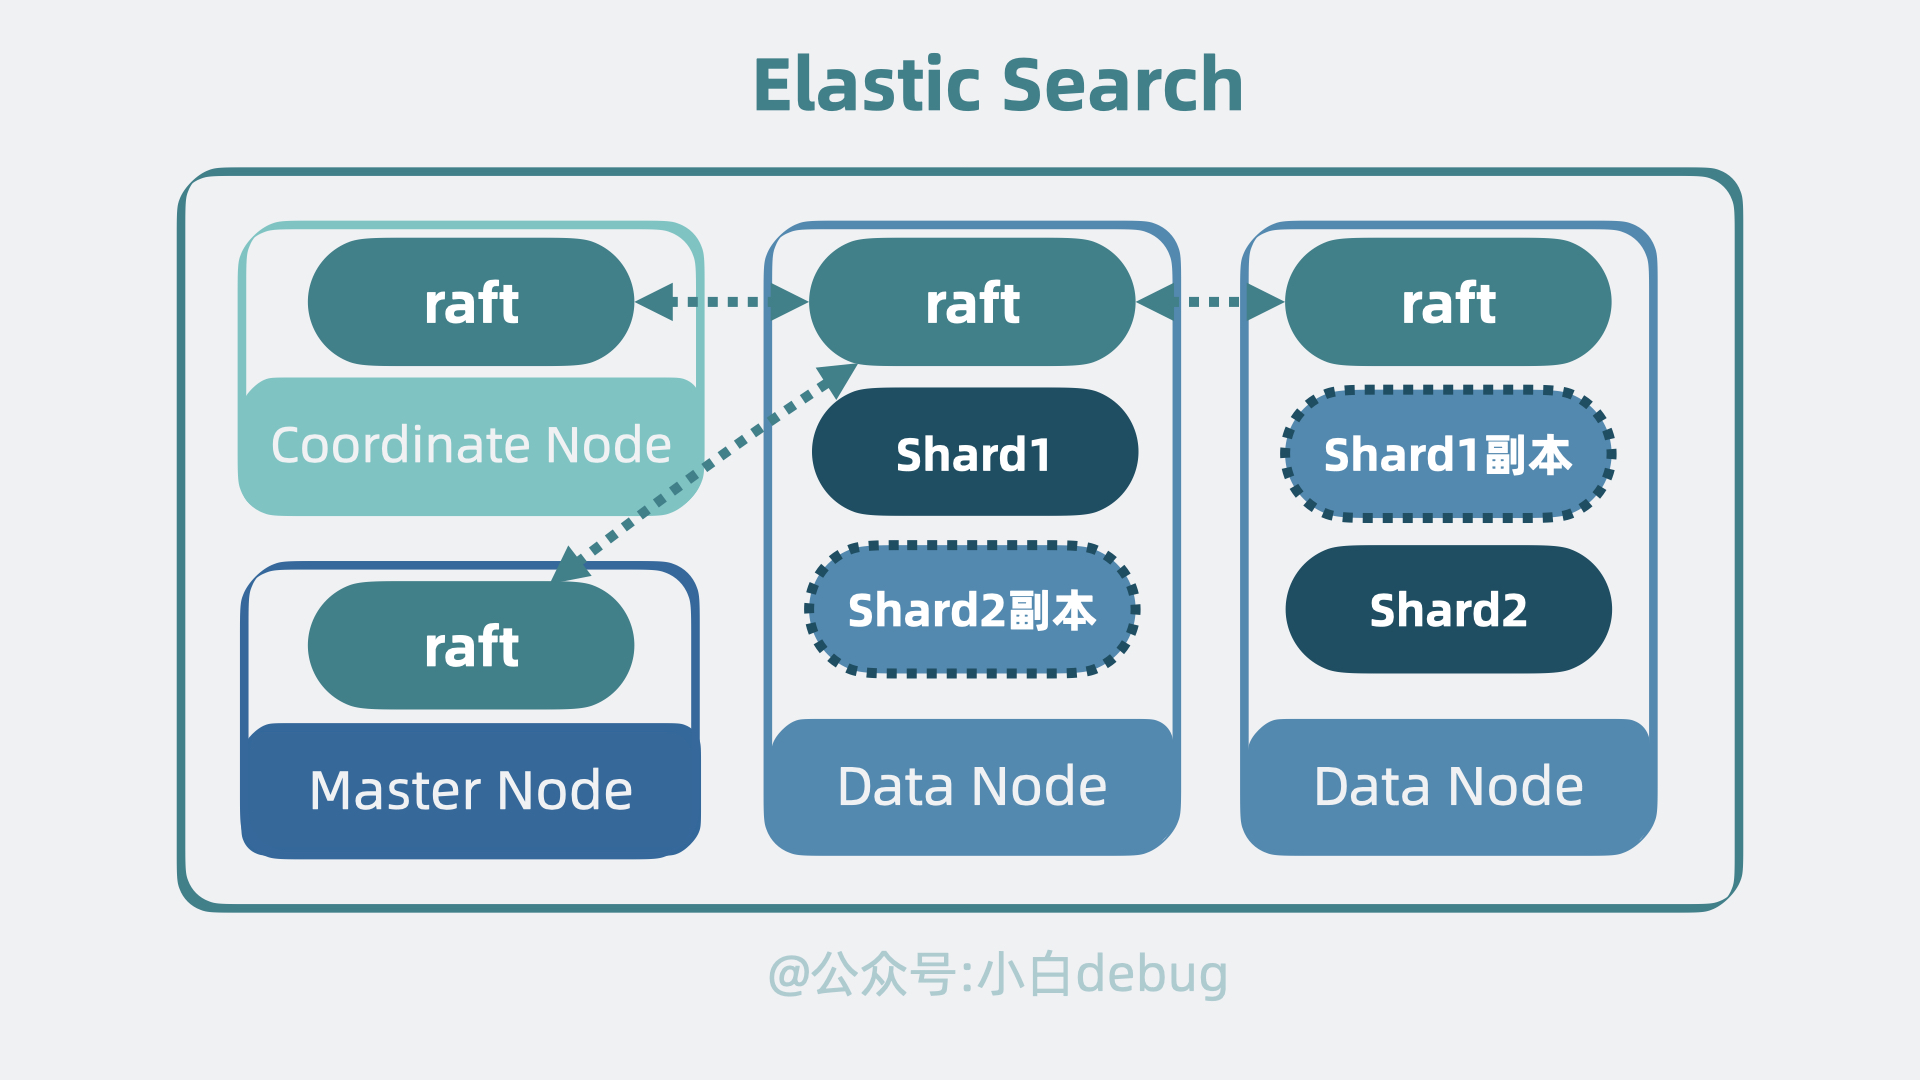
查询
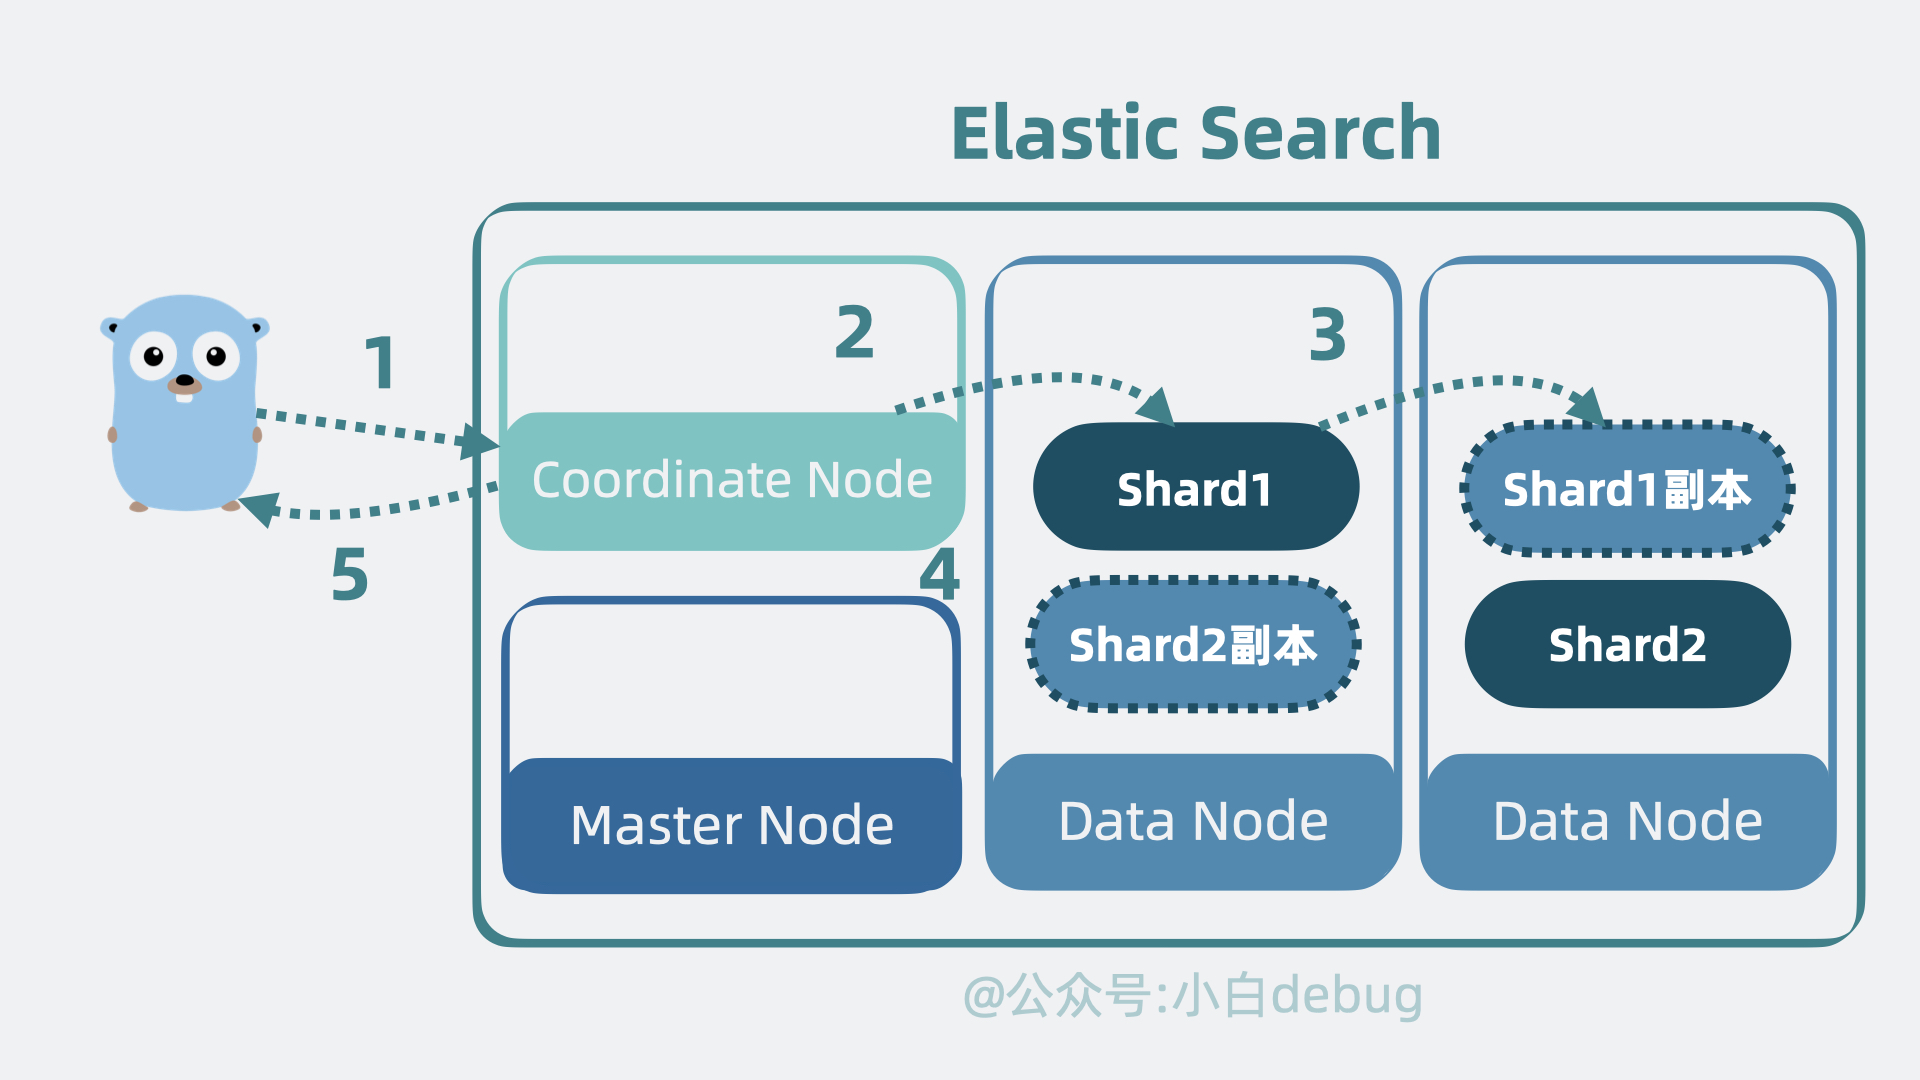
- 当客户端应用发起搜索请求,请求会先发到集群中的协调节点。
- 协调节点根据 index name 的信息,可以了解到 index name 被分为了几个 分片,以及这些分片 分散哪个数据节点上,将请求转发到这些数据节点的 分片 上面。
- 搜索请求到达分片后,分片 底层的 lucene 库会并发搜索多个 segment,利用每个 segment 内部的倒排索引获取到对应文档 id,并结合 doc values 获得排序信息。分片将结果聚合返回给协调节点。
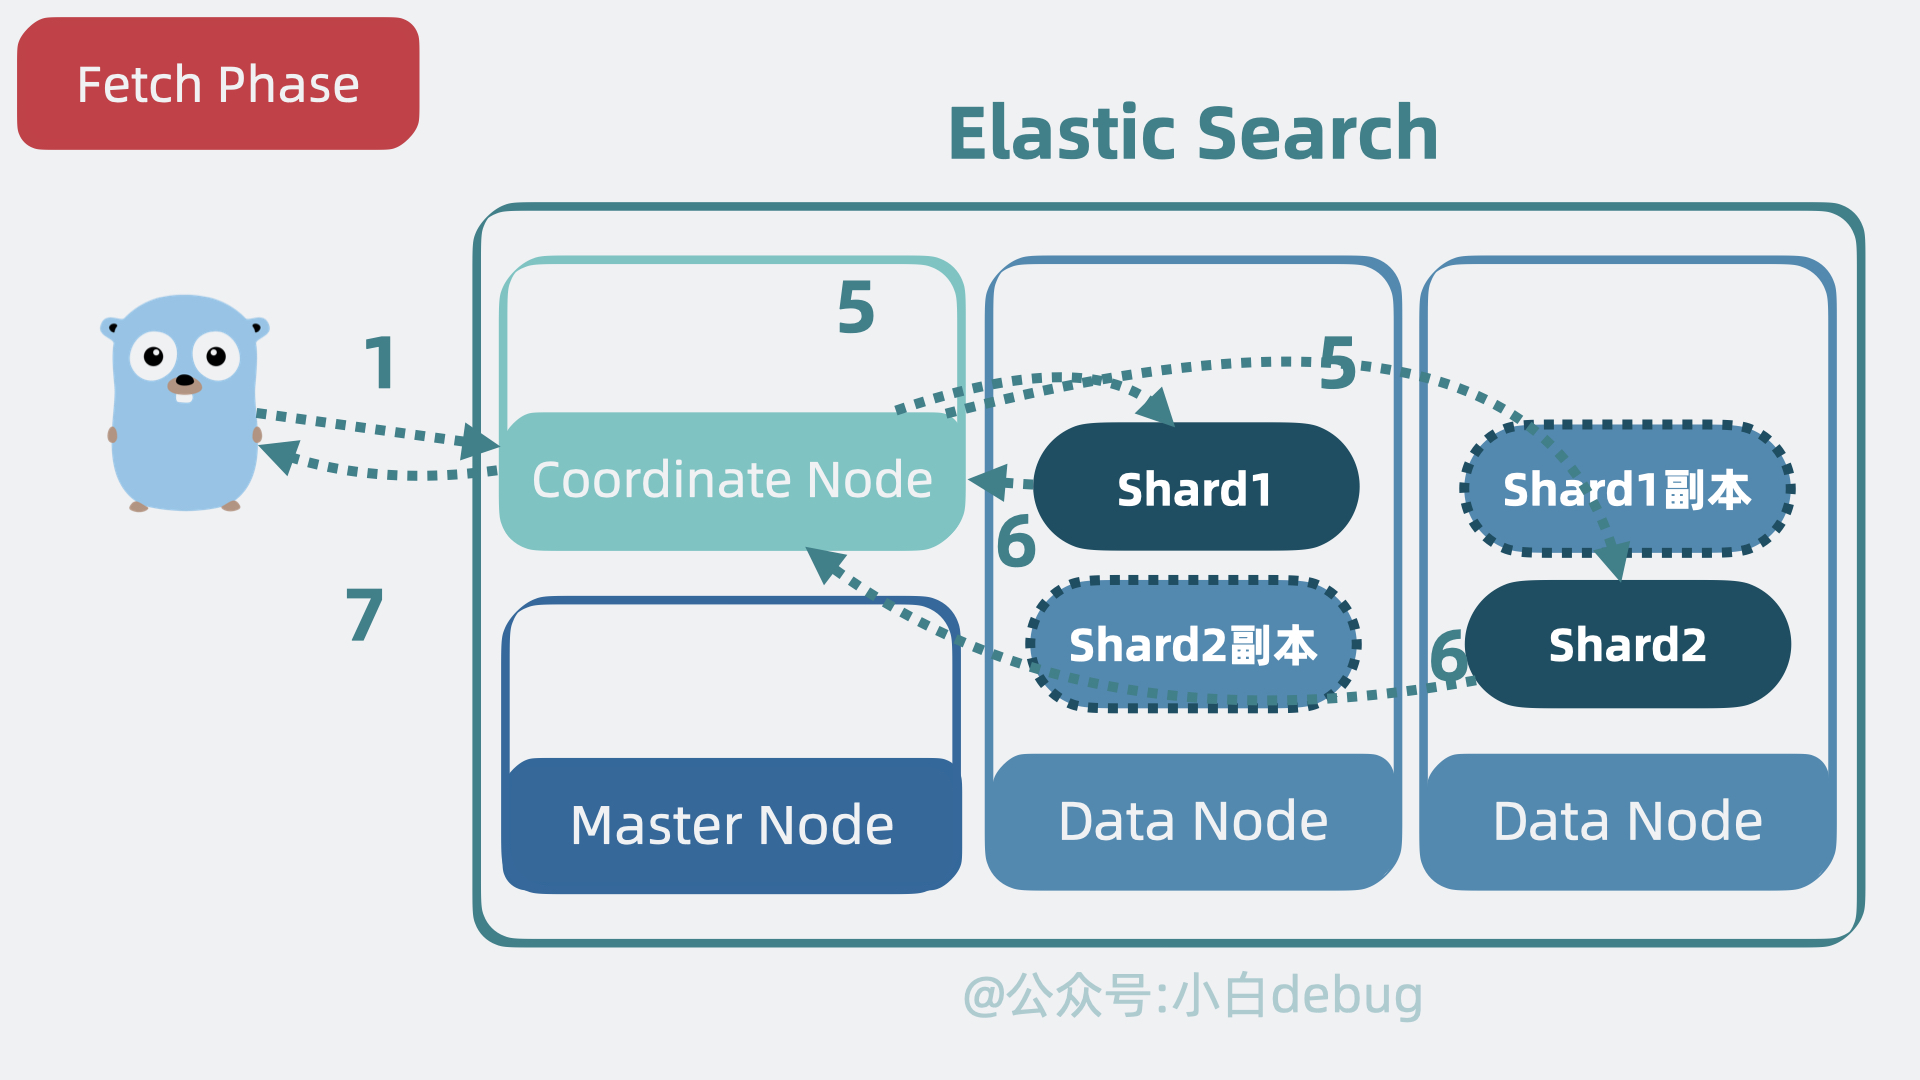
- 协调节点对多个分片中拿到的数据进行一次排序聚合,舍弃大部分不需要的数据
- 协调节点再次拿着文档 id 请求数据节点里的 分片,分片 底层的 lucene 库会从 segment 内的 Stored Fields 中取出完整文档内容,并返回给协调节点。
- 协调节点最终将数据结果返回给客户端。完成整个搜索过程。
数据建模(快速版)
segment基本组成(快速版)
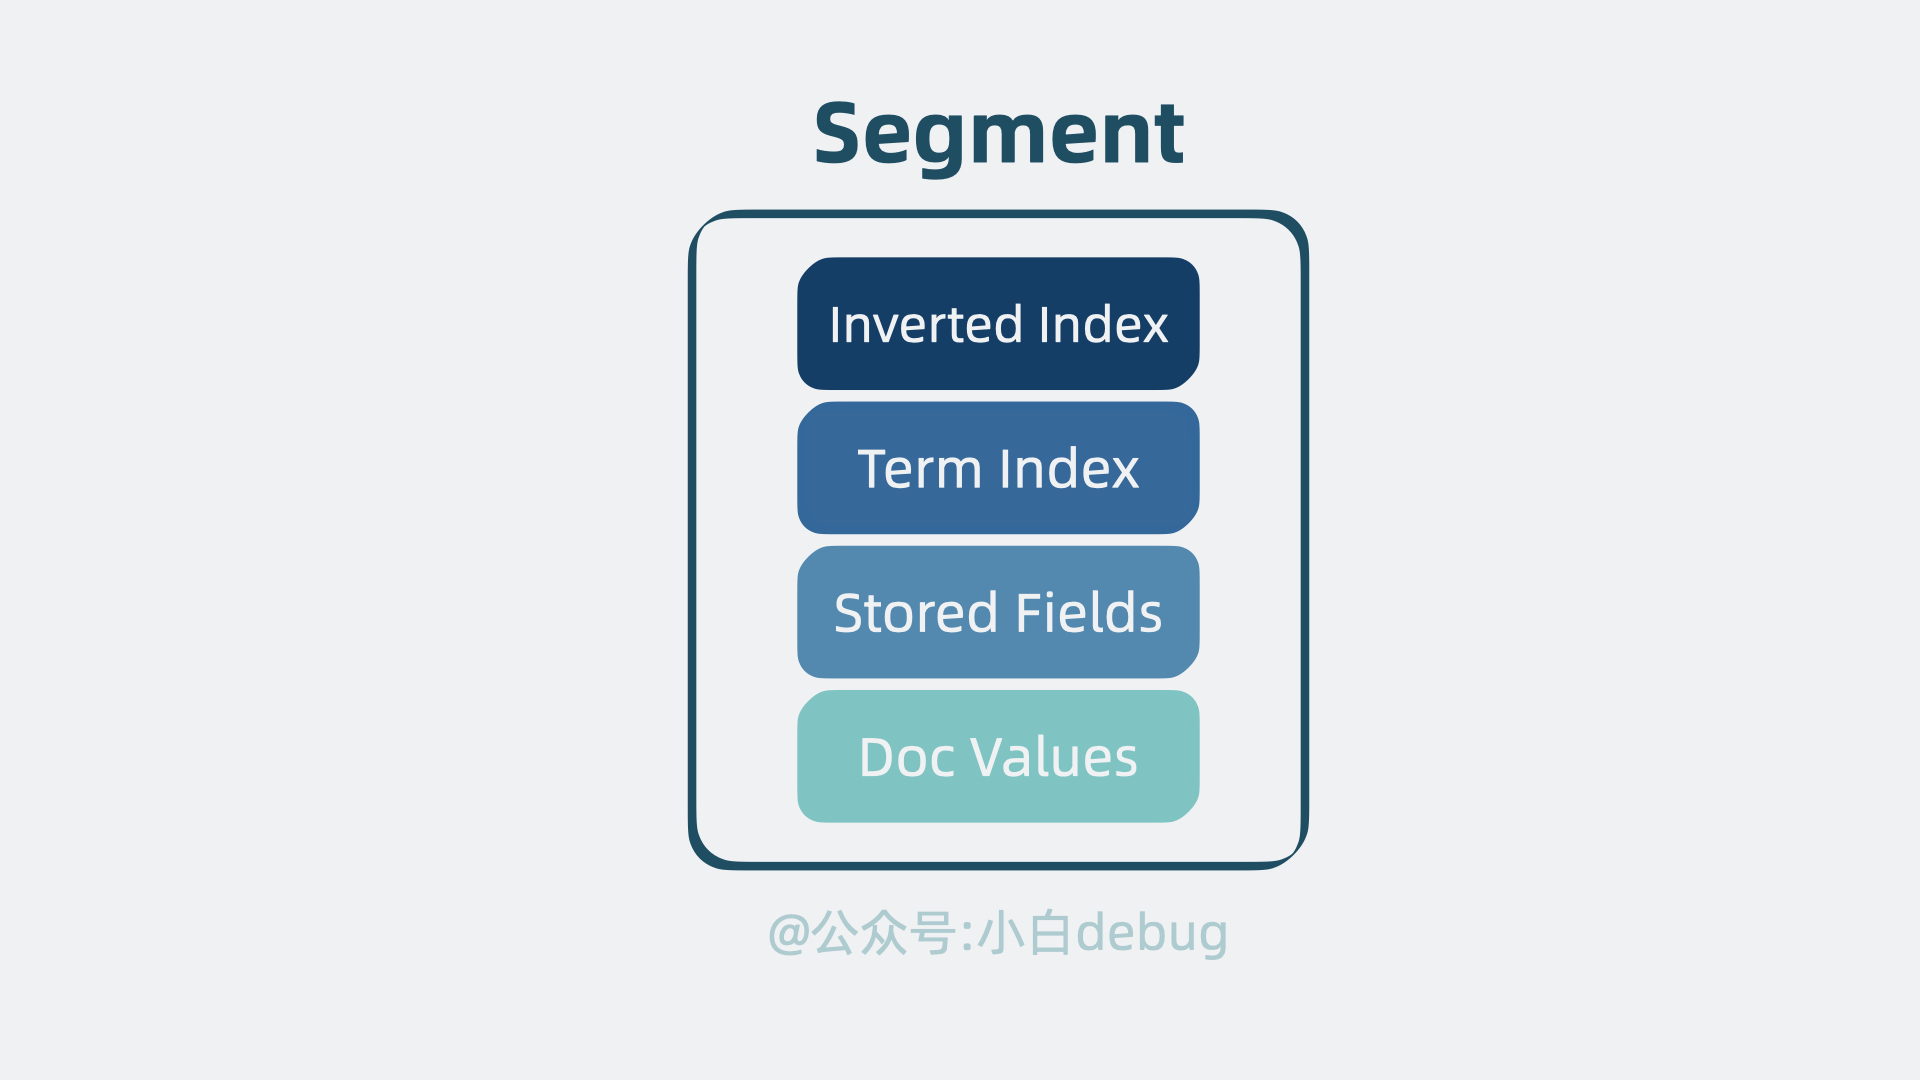
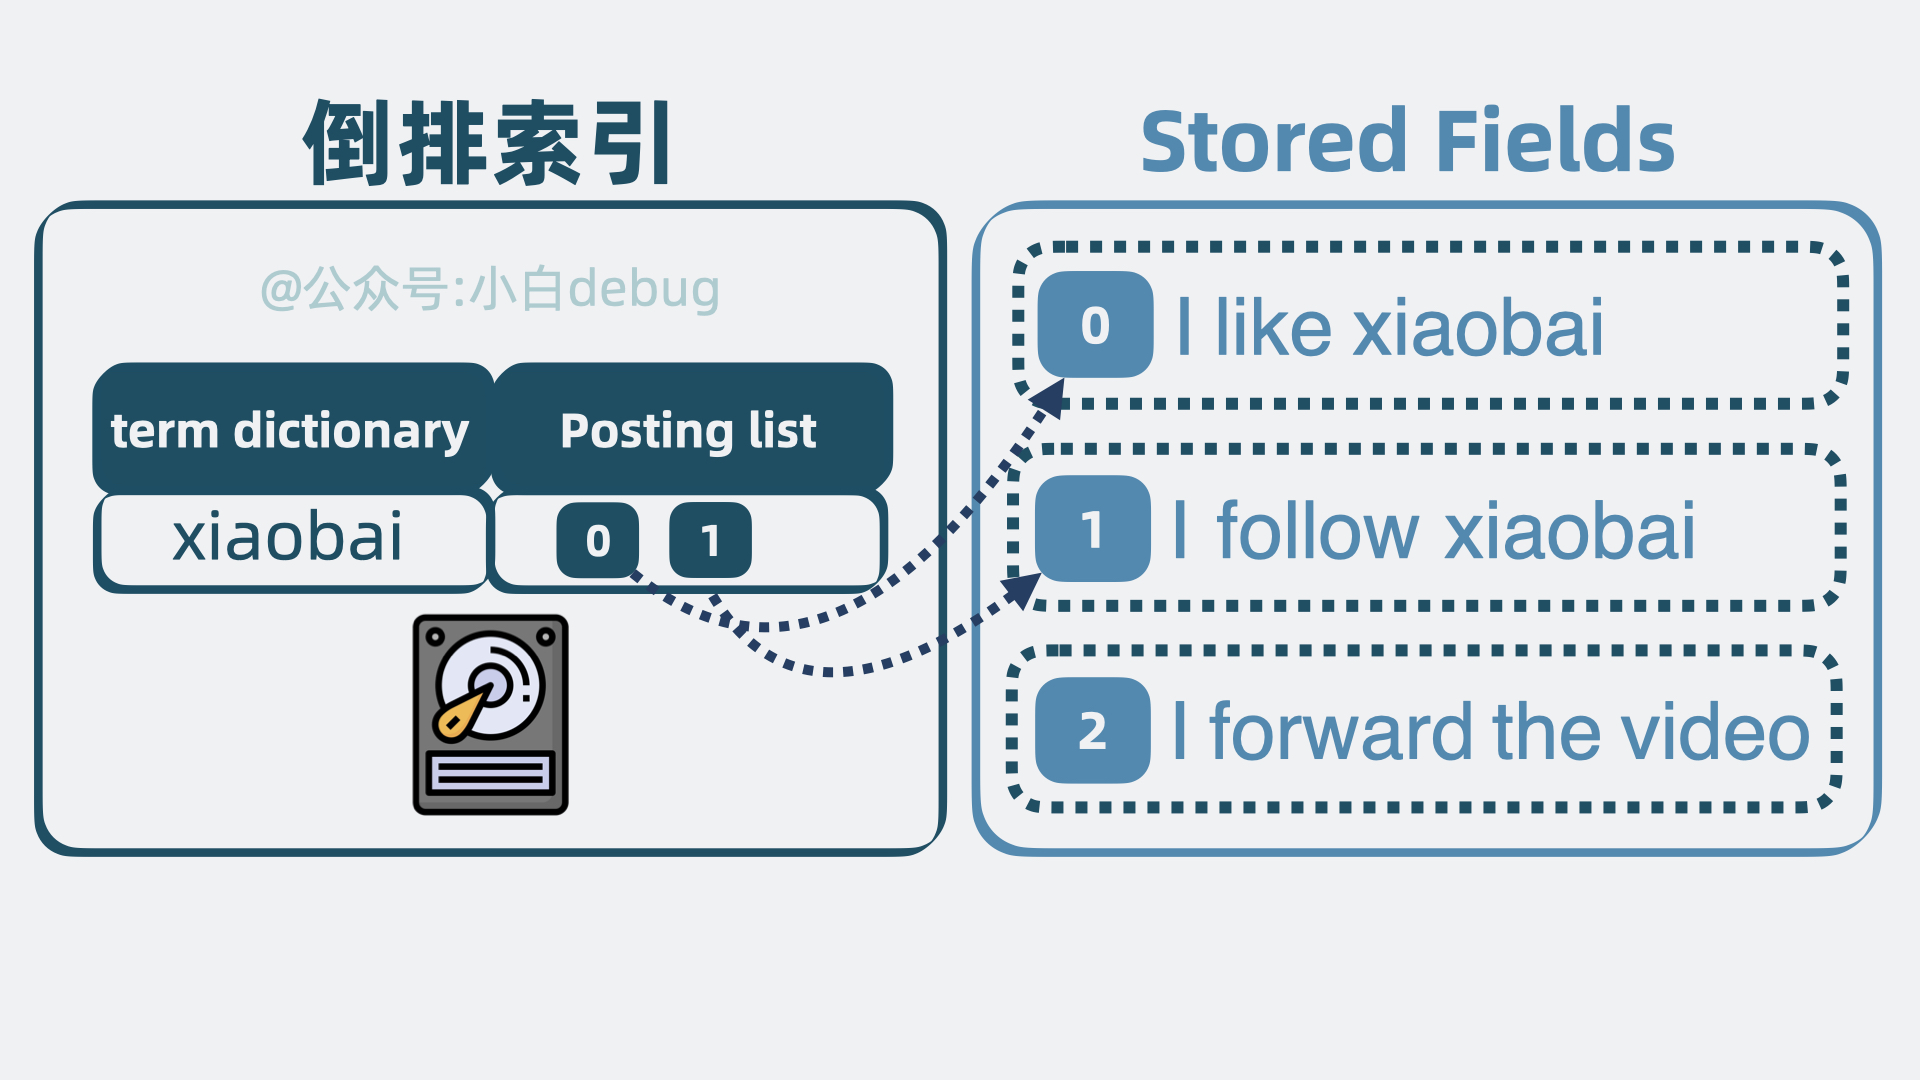
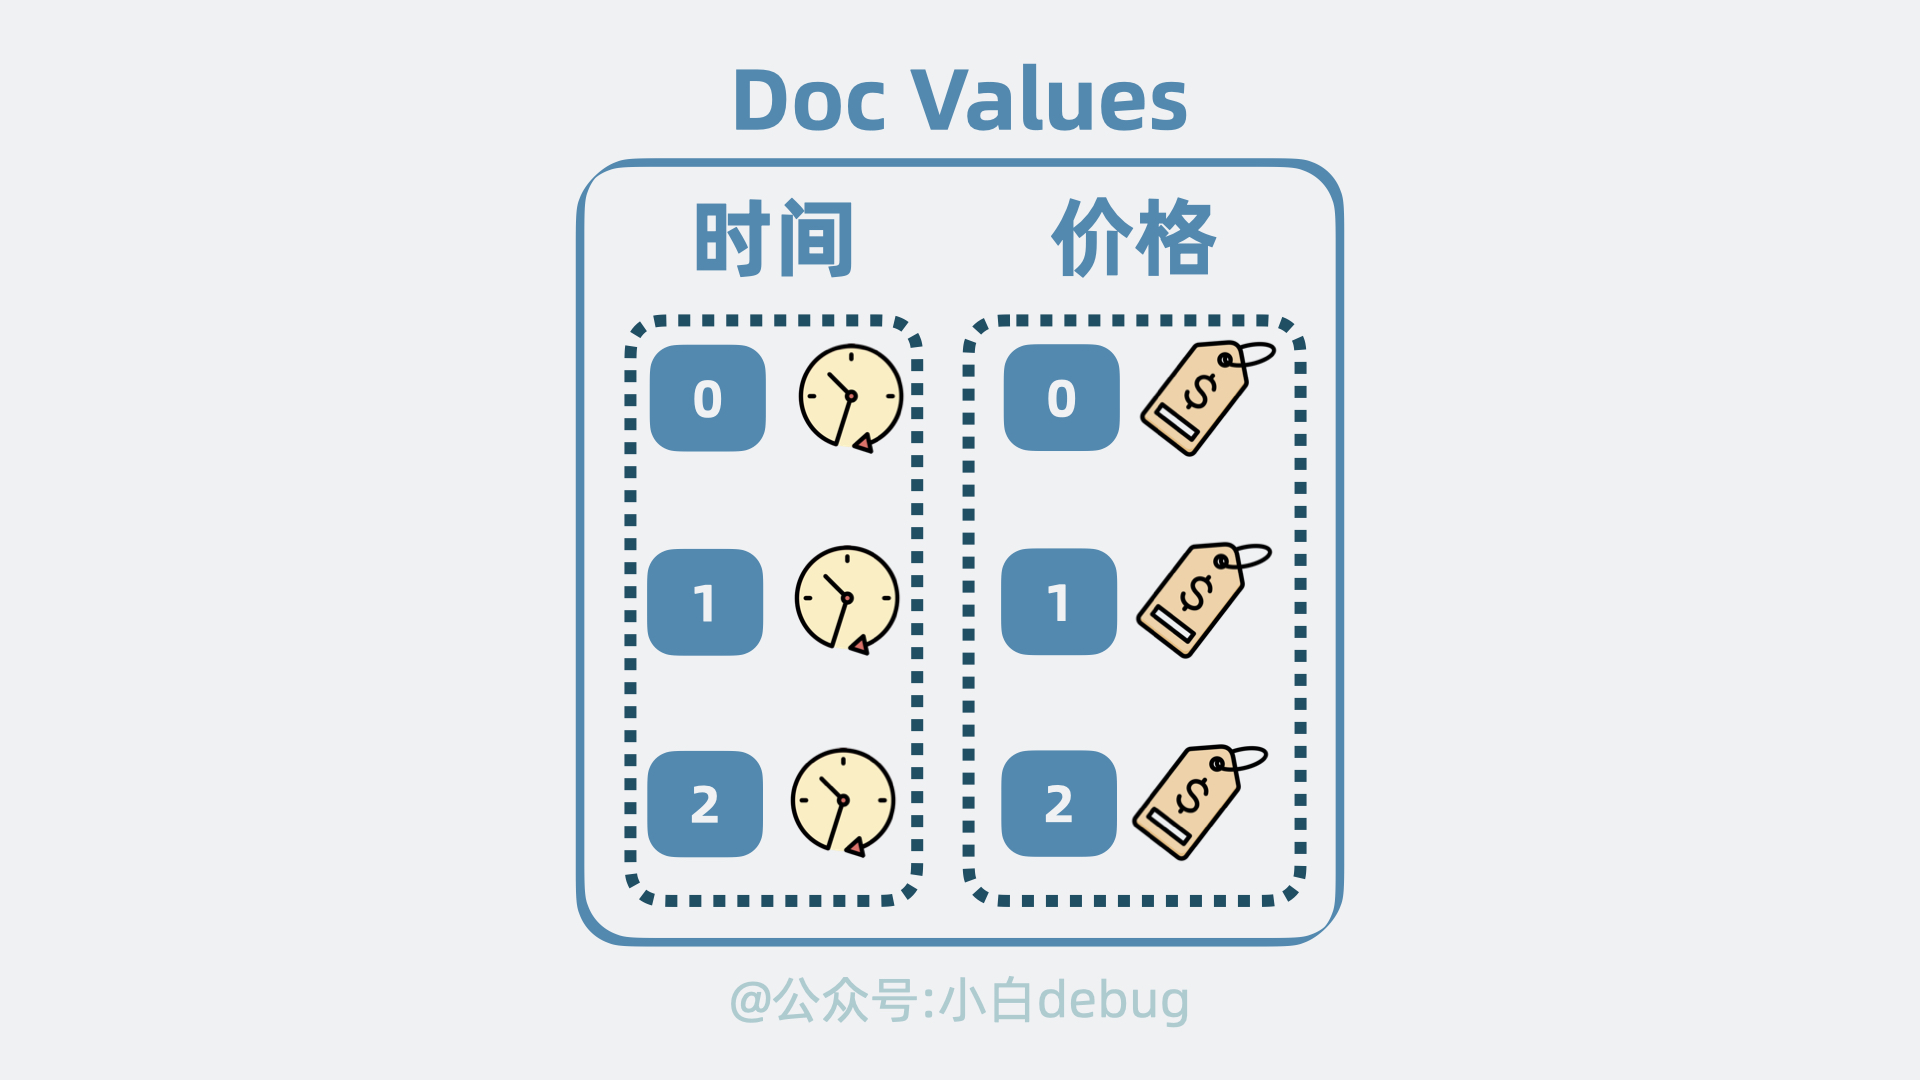
倒排索引用于搜索,Term Index 用于加速搜索,Stored Fields 用于存放文档的原始信息,以及 Doc Values 用于排序和聚合。这些结构共同组成了一个复合文件,也就是所谓的"segment", 它是一个具备完整搜索功能的最小单元
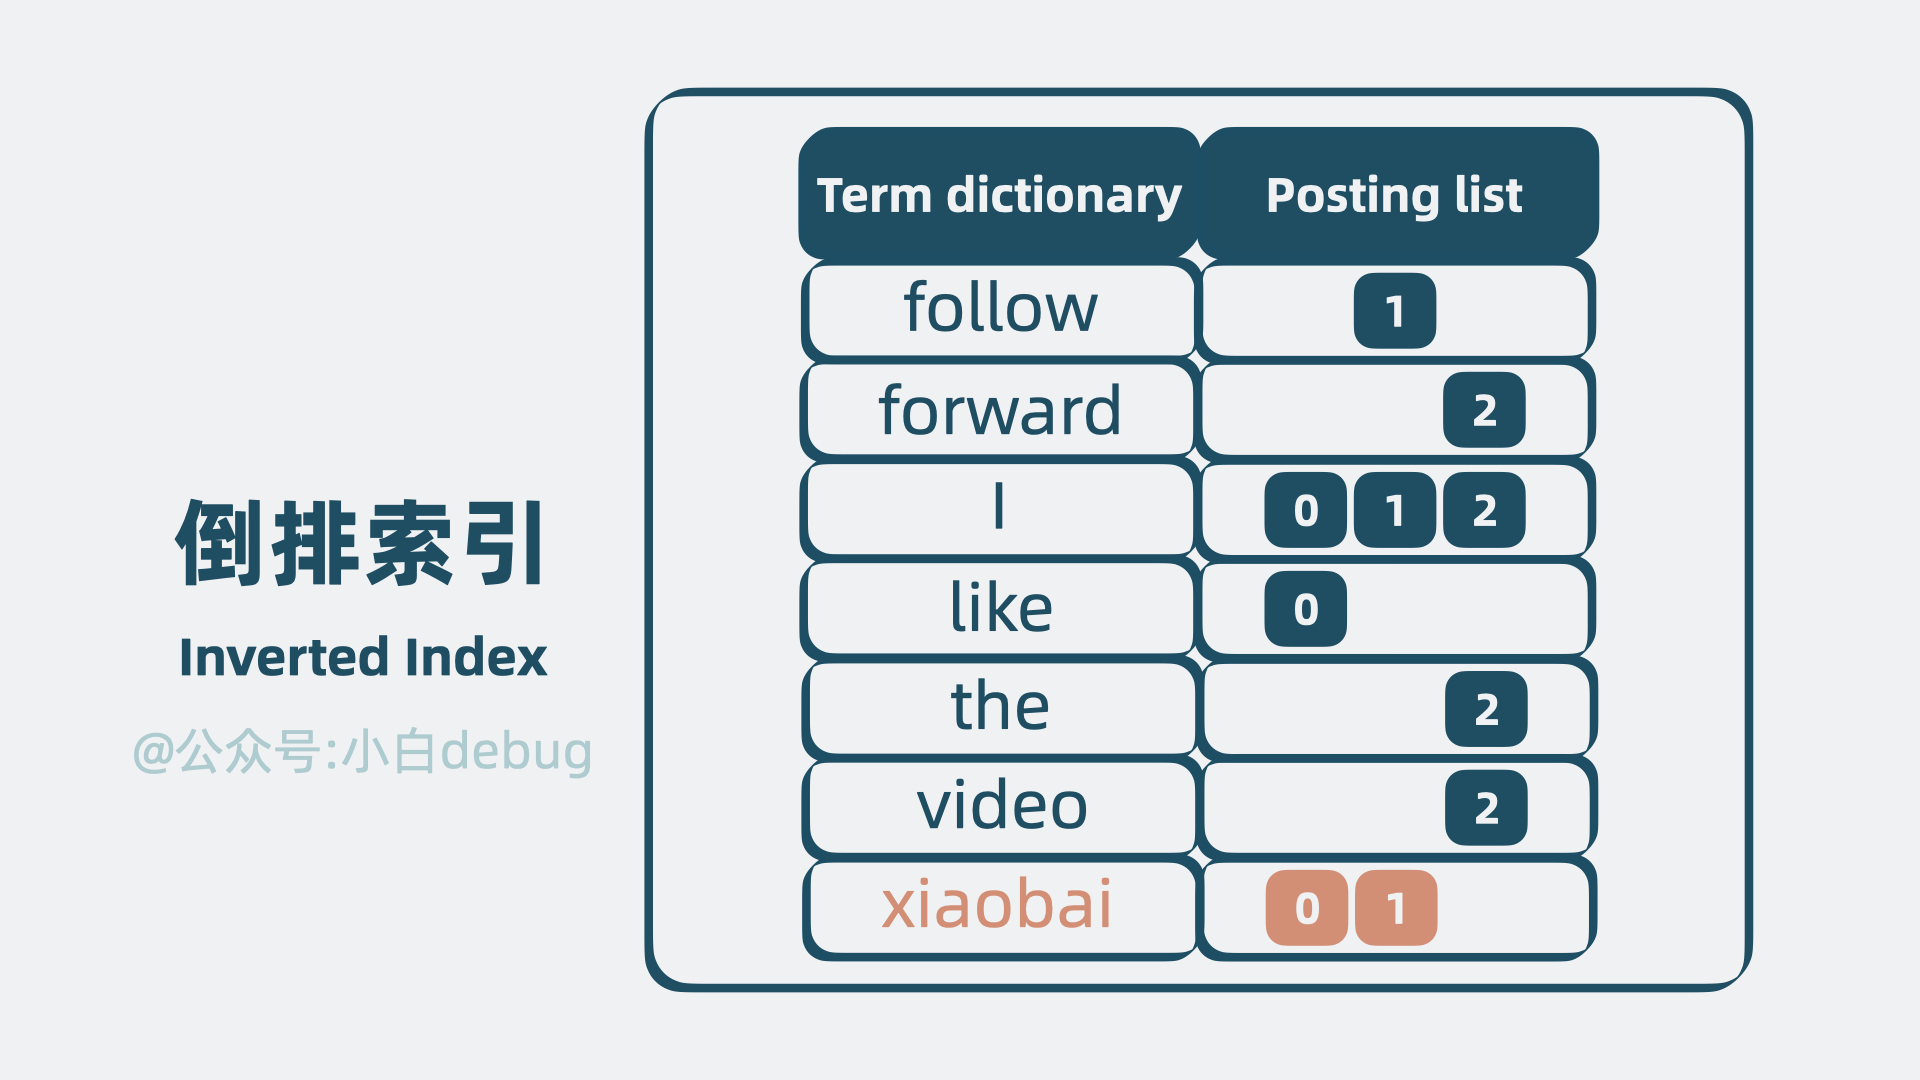
倒排索引(Inverted Index)
分词后的每部分,我们称为一个词项,也就是 term。记录词项和文本 id 的关系
词项按字典序从小到大排序,查找可以进行二分,即Term Dictionary
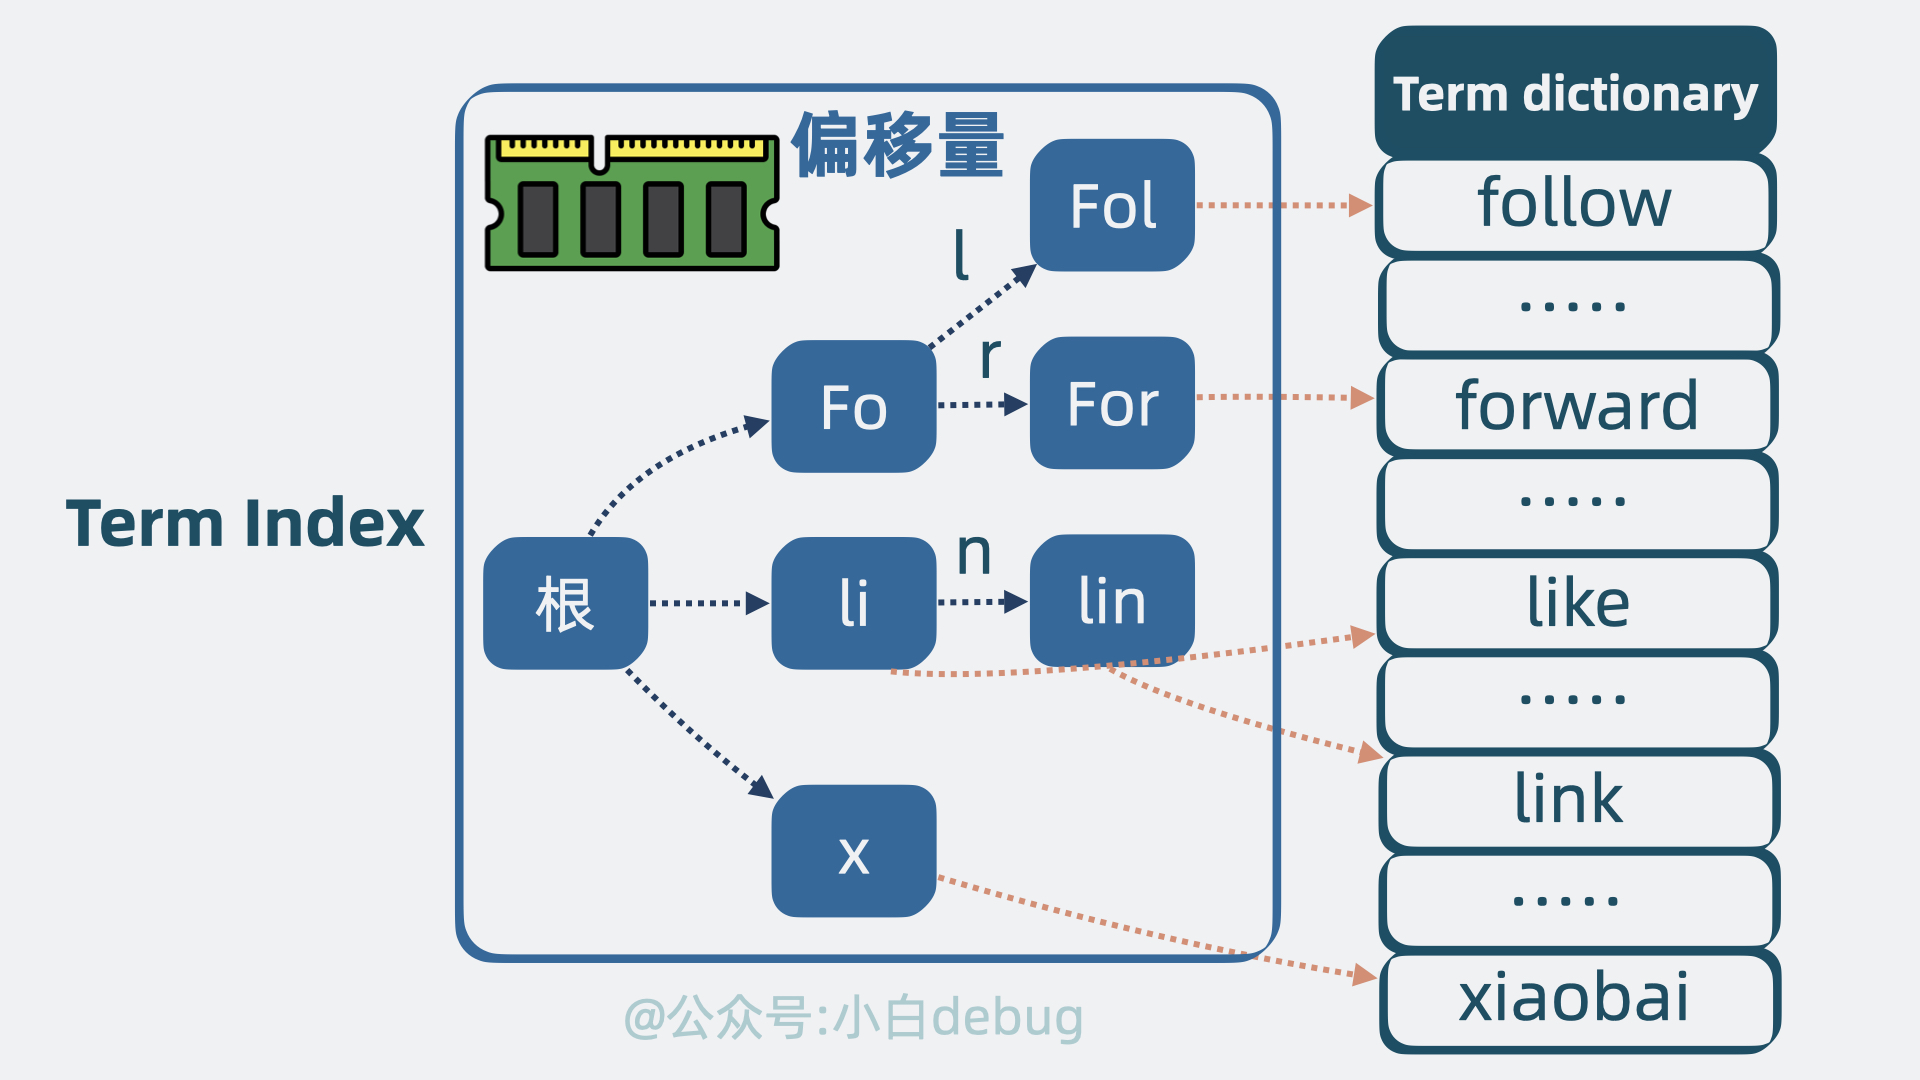
前缀索引**(Term Index)**
Term Dictionary 数据量很大,放内存并不现实,因此必须放在磁盘中。但查询磁盘是个较慢的过程。
将 Term Dictionary 的部分词项提取出来,用这些 词项 的前缀信息,构建出一个精简的目录树
目录树的节点中存放这些词项在磁盘中的偏移量,也就是指向磁盘中的位置。这个目录树结构,体积小,适合放内存中,它就是所谓的 Term Index。可以用它来加速搜索
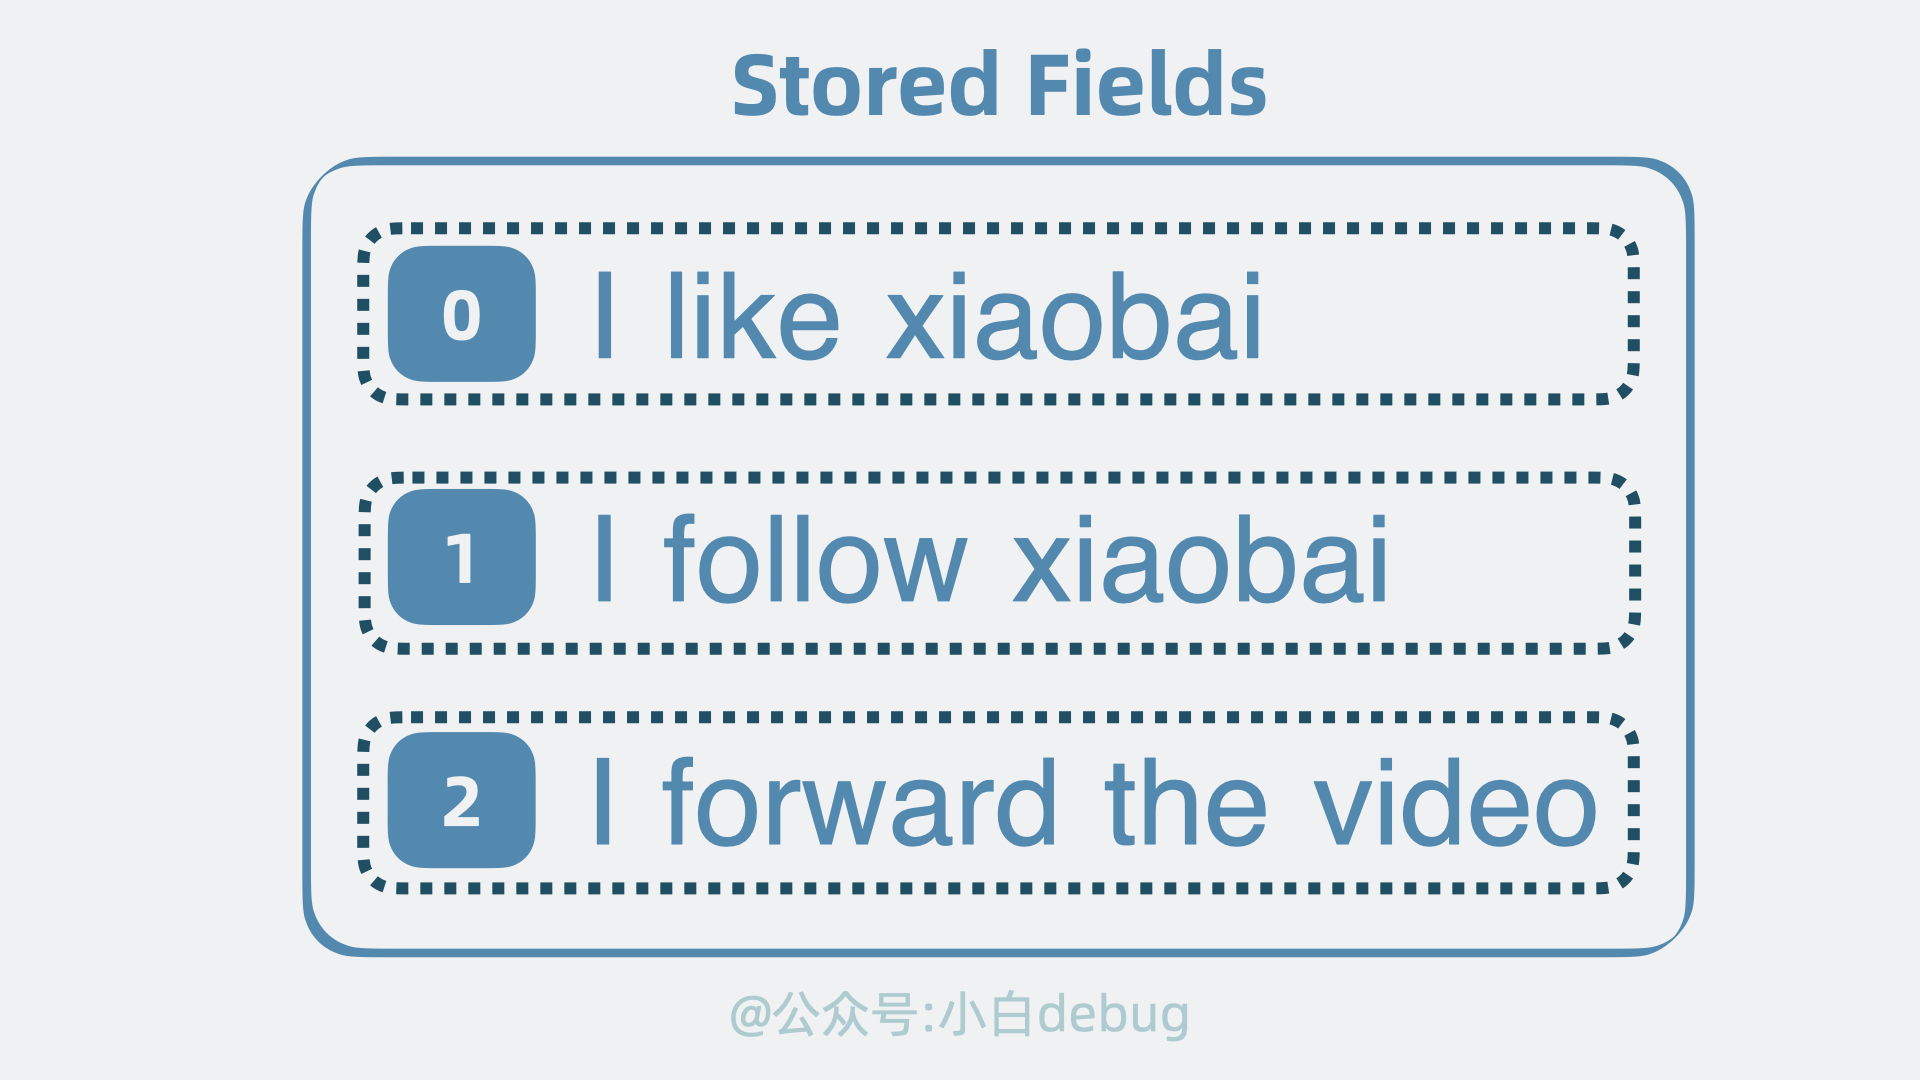
行式存储(Stored Fields)
倒排索引,搜索到的是文档 id,我们还需要拿着这个 id 找到文档内容本身,才能返回给用户。
因此还需要有个地方,存放完整的文档内容,它就是 Stored Fields(行式存储)
(Doc Values)
有了 id,我们就能从 Stored Fields 中取出文档内容。
再构造一个列式存储结构,将散落在各个文档的某个字段,集中存放,当我们想对某个字段排序的时候,就只需要将这些集中存放的字段一次性读取出来,就能做到针对性地进行排序。这个列式存储结构,就是所谓的 Doc Values
segment合并
分词
Elasticsearch不支持的场景
读写有一定延时,写入的数据,最快1s中能被检索到。
默认的刷新频率设置是1秒,也就是说文档从Index请求到对外可见能够被搜到,最少要1秒钟,强制的,你的网络和CPU再快也不行。这么做是Lucene为了提高写操作的吞吐量而做出的延迟牺牲,当然这个设置是可以手动调整的,但是并不建议你去动它,会极大地影响搜索性能。不同的应用对实时性的定义并不一样,这取决于你的需求。
系统设计数据库选型考量
- 如果信息获取及分析的能力是你的首要需求,那么无疑Elasticsearch是一个好的选择。
- 如果你的数据并不频繁的update操作,也没有事务性操作,那么完全可以用Elasticsearch替代其他存储。
- 实时性要求高的场景,需要结合ACID特性的数据库和Elasticsearch结合使用。
- 创建的每个Elasticsearch索引都应该由符合ACID的数据存储支持。
- 数据库应该是真实的最终来源,从中填充索引。
- 如果异常情况发生(节点丢失,中断或误操作 )导致丢失了索引,您将能够完全恢复它。
- 一般的用法是另外的数据库比如NOSQL里面有一份,然后实时同步到ES,这样一个用于键值查询,一个用于各种其他查询。 如果ES升级了之类的,比如数据结构变了,那么老版本数据可以不要,直接NOSQL再导入一份到新版本,还可以恢复。
- logstash的同步插件如logstash_input_jdbc 不支持同步删除操作,建议改为更新操作加标记flag,或者通过业务逻辑实现同步删除操作。
核心操作:
不支持事务,如前所述。
No comments yet.