目录
ES从使用到原理
FP 遇到典型 ES 问题有哪些,分哪些类别,归纳出需要回答/关注的一些问题
多少规模数据,使用多少内存、CPU是合理的。(拿 FP/RIO 来举例)
查询:流程、影响(对负载)、如何分析
异常恢复
常见的一些问题排查方案:比如健康检查、慢查询、资源异常
背景
Elasticsearch(ES)是基于Apache Lucene的开源搜索引擎。它提供了一个分布式、实时的全文搜索和分析引擎,构建在Lucene库之上,同时还提供了更多的功能和工具来简化搜索应用的开发和管理。
了解其架构、存储方式、查询链路会有利于我们优化相关的CRUD操作,提高FP的性能。
这里将淡化分布式相关的概念,强调单机上的链路以及性能。
下面将从下面几个概念进行调研
核心概念
查询与分析
数据存储与管理
集群管理与优化
这里我们整理一下当前工单中遇到过的一些和ES相关的问题,以及当初的解决方案
1. 线上问题分类
FP使用问题(bug) 占 40 %
启动失败 占 35 %
2. 线上问题分析
| 细分类型 |
需求量描述 |
计算公式 |
示例计算 |
依据 |
|
|---|---|---|---|---|---|
| 磁盘空间 |
|||||
| 原始数据量 |
每天生成的数据量 |
20GB * 365天 |
7300GB |
||
| 索引开销 |
索引开销(假设20%) |
7300GB * 0.2 |
1460GB |
通常,索引开销大约在原始数据量的10%到20%之间 |
|
| 副本数 |
副本数(假设1个副本) |
(7300GB + 1460GB) * (1 + 1) |
17520GB |
||
| 总磁盘空间 |
原始数据量 + 索引开销 + 副本数 |
7300GB * (1 + 0.2) * (1 + 1) |
17520GB |
||
| 内存 |
|||||
| 堆内存 |
每个节点的堆内存 |
推荐总内存的一半,但不超过32GB |
31GB |
ES不建议为JVM配置超过32GB的内存,超过32GB时,Java内存指针压缩失效,浪费一些内存,降低了CPU性能,GC压力也较大。因此推荐设置为31GB: -Xmx31g -Xms31g 确保堆内存最小值(Xms)与最大值(Xmx)大小相同,防止程序在运行时动态改变堆内存大小,这是很耗系统资源的过程。 |
|
| 操作系统缓存 |
操作系统缓存需等于或多于堆内存 |
堆内存 * 1 |
31GB |
搜索操作很依赖对系统cache的命中,标准的建议是把50%的可用内存作为ES的堆内存,为Lucene保留剩下的50%,用作系统cache。 |
|
| 总内存 |
每个节点总内存 |
堆内存 * 2 |
62GB |
||
| CPU |
|||||
| 单节点CPU数 |
每个节点的虚拟CPU |
4到8个vCPU |
假设3个节点,每个节点4到8个vCPU |
小型集群推荐 节点数:3个 vCPU/节点:4个 总vCPU数:12个 |
|
| 总CPU |
总节点数 |
节点数 * (4到8个vCPU) |
3个节点 * (4到8个vCPU) = 12到24个vCPU |
Tips:关于Java指针压缩
| Bash 在 Java 中,所有的对象都分配在堆上,并通过一个指针进行引用。 普通对象指针(OOP)指向这些对象,通常为 CPU 字长 的大小:32 位或 64 位,取决于你的处理器。指针引用的就是这个 OOP 值的字节位置。 对于 32 位的系统,意味着堆内存大小最大为 4 GB。对于 64 位的系统, 可以使用更大的内存,但是 64 位的指针意味着更大的浪费,因为你的指针本身大了。更糟糕的是, 更大的指针在主内存和各级缓存(例如 LLC,L1 等)之间移动数据的时候,会占用更多的带宽。 Java 使用一个叫作 内存指针压缩(compressed oops)的技术来解决这个问题。 它的指针不再表示对象在内存中的精确位置,而是表示 偏移量 。这意味着 32 位的指针可以引用 40 亿个 对象 , 而不是 40 亿个字节。最终, 也就是说堆内存增长到 32 GB 的物理内存,也可以用 32 位的指针表示。 一旦你越过那个神奇的 ~32 GB 的边界,指针就会切回普通对象的指针。 每个对象的指针都变长了,就会使用更多的 CPU 内存带宽,也就是说你实际上失去了更多的内存。事实上,当内存到达 40–50 GB 的时候,有效内存才相当于使用内存对象指针压缩技术时候的 32 GB 内存。 这段描述的意思就是说:即便你有足够的内存,也尽量不要 超过 32 GB。因为它浪费了内存,降低了 CPU 的性能,还要让 GC 应对大内存。 |
|---|
备注
磁盘空间需求:根据数据增长情况进行预估,注意考虑索引开销和副本数。
内存需求:堆内存设置为总内存的一半,操作系统缓存也需要足够的内存。
CPU需求:根据节点数和并发量进行合理分配,通常每个节点4到8个vCPU。
2. FP怎么评估(TODO)
3. AIOS怎么评估(TODO)
核心概念
ES的核心概念。
| 索引(Index): 存储、管理和查询文档的地方,相当于数据库中的表。 类型(Type): Elasticsearch 6.x 及以前版本中的分类概念,从 7.x 开始废弃。 文档(Document): 存储的数据单元,是一个 JSON 对象,相当于数据库表中的一行。 节点(Node): 运行 Elasticsearch 实例的基本单元,可以有多种角色。 集群(Cluster): 由多个节点组成的集合,协同工作来存储数据和处理请求。 分片(Shard): 索引的基本存储单元,分为主分片和副本分片。 副本(Replica): 主分片的复制,用于提高数据的可用性和查询性能。 |
|---|
1. 节点(Node)与集群(Cluster)
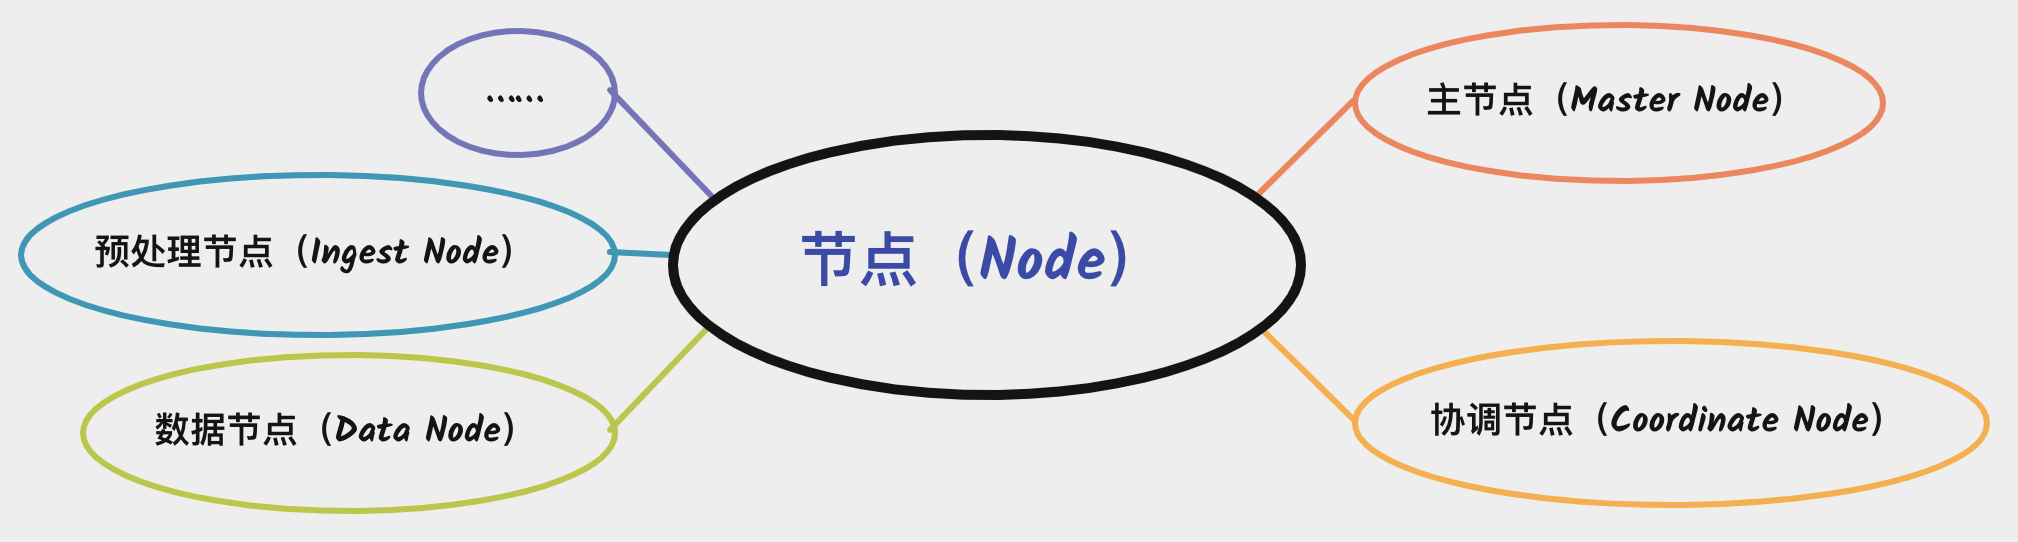
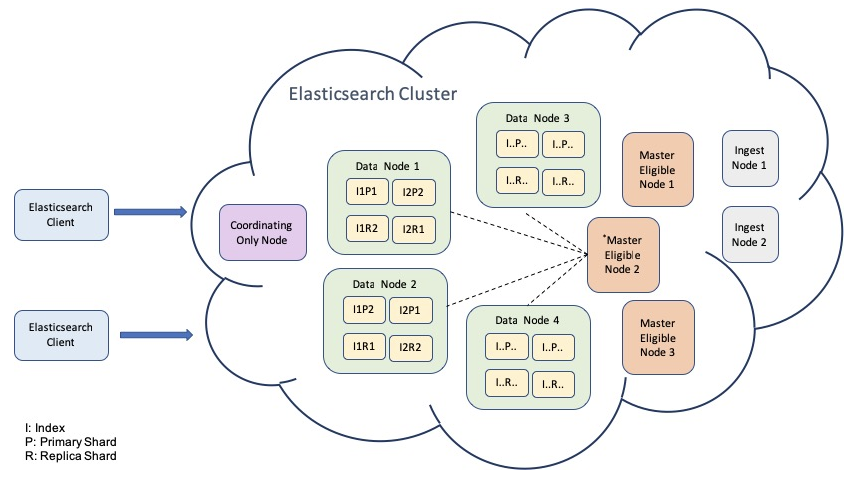
集群是有多个节点组成的,在上图中可以看到集群中有多个不同种类型的节点。
节点是一个Elasticsearch的实例,本质上是一个Java进程。
每个节点上面都保存着集群的状态信息,包括所有的节点信息、所有的索引和相关的Mapping、Setting信息和分片的路由信息等。
节点按照角色可以划分为主节点、数据节点、协调节点和预处理节点等
| 节点类型 |
职责与功能 |
|---|---|
| 主节点 |
管理集群状态信息,包括处理创建、删除索引等请求。 负责维护和更新集群状态,包括分片路由信息,决定分片被分配到哪个节点。 是唯一能够修改集群状态信息的节点,负责将更改同步给其他节点。 |
| 协调节点 |
接收客户端的请求,并将请求路由到合适的节点。 负责汇集来自不同节点的结果,将结果汇总返回给客户端。 |
| 数据节点 |
保存实际的数据。 解决水平扩展和数据单点问题,增加数据节点可以增加存储容量和分担负载。 执行实际的数据读写操作。 |
| 预处理节点 |
数据前置处理转换的节点,支持 pipeline 管道设置。 可以对数据进行过滤、转换等操作,为数据处理提供灵活性和扩展性。 可以在数据传输前对数据进行加工处理,满足不同的业务需求。 |
在小型 Elasticsearch 集群中,为了节省资源,可以让主节点兼具数据节点的角色,即在主节点上保存实际的数据。在某些场景下,也可以让协调节点兼具数据节点的角色,即让协调节点保存实际的数据。
在我们的fp部署目录中middlewares/elasticsearch/config/es_config.yaml定义了我们使用es的一些配置
下面这个是我在44.58上调用健康检查接口拿到的集群状态信息
| JSON curl -X GET "http://10.102.178.118:9200/_cluster/health?pretty" { "cluster_name" : "elasticsearch", "status" : "green", "timed_out" : false, "number_of_nodes" : 3, "number_of_data_nodes" : 3, "active_primary_shards" : 1, "active_shards" : 2, "relocating_shards" : 0, "initializing_shards" : 0, "unassigned_shards" : 0, "delayed_unassigned_shards" : 0, "number_of_pending_tasks" : 0, "number_of_in_flight_fetch" : 0, "task_max_waiting_in_queue_millis" : 0, "active_shards_percent_as_number" : 100.0 } |
|---|
含义整理如下:从绿色的表格中可以看出我们的部署方式是1个master&data + 2个data节点
| 字段 |
值 |
描述 |
|---|---|---|
| cluster_name |
elasticsearch |
Elasticsearch 集群的名称。 |
| status |
green |
集群的健康状态。可能的值包括:green(绿色)、yellow(黄色)、red(红色)。 |
| timed_out |
false |
指示请求是否在完成之前超时。 |
| number_of_nodes |
3 |
集群中节点的总数。 |
| number_of_data_nodes |
3 |
集群中数据节点的数量。 |
| active_primary_shards |
1 |
活动的主分片数量。 |
| active_shards |
2 |
活动分片的总数(包括主分片和副本分片)。 |
| relocating_shards |
0 |
当前正在重新定位的分片数量。 |
| initializing_shards |
0 |
当前正在初始化的分片数量。 |
| unassigned_shards |
0 |
未分配的分片数量。 |
| delayed_unassigned_shards |
0 |
延迟未分配的分片数量。 |
| number_of_pending_tasks |
0 |
集群中挂起的任务数量。 |
| number_of_in_flight_fetch |
0 |
索引数据提取任务的数量。 |
| task_max_waiting_in_queue_millis |
0 |
在队列中等待的任务的最长等待时间(毫秒)。 |
| active_shards_percent_as_number |
100.0 |
活动分片的百分比。 |
有兴趣的可以再观察一下curl -X GET "http://10.102.178.118:9200/_nodes"可以获取到详细的nodes信息.这里贴一下拿到的json数据:
[该类型的内容暂不支持下载]
从roles字段可以看出3个节点的role信息分别为
| master节点 |
data节点 |
备注 |
|---|---|---|
| [ "ingest", "master", "data", "ml" ] |
[ "ingest", "data", "ml" ] |
都具备预处理、存储和索引数据、以及机器学习的功能 |
2. 分片(Shard)与副本(Replica)
分片
定义: 分片是 Elasticsearch 中索引的基本存储单元,一个索引可以被拆分成多个分片。
类型: 分片有两种类型:主分片(Primary Shard)和副本分片(Replica Shard)。
配置: 分片数量在索引创建时指定,主分片数量创建后不可更改。
分配: Elasticsearch 会自动将分片分配到集群中的不同节点上,以均衡负载和提高可用性。
副本
定义: 副本是主分片的复制,用于提高数据的可用性和容错能力。
数量: 每个主分片可以有多个副本分片,副本数量可以在索引创建后动态调整。
角色: 副本不仅在主分片失效时接管工作,还可以分担查询负载,提升查询性能。
简单来说,一个表太大了可能会降低查询效率,所以需要分成多个shard,可以支持并行查询以及存储的扩展伸缩(数据越多分片越多)
出于容灾的考虑,一个shard又得做多个副本。
这里给出一个分片、节点、集群的关系
| SQL graph LR subgraph Elasticsearch_Cluster A[Node 1] B[Node 2] C[Node 3] end subgraph Index D[Primary Shard 1] E[Primary Shard 2] F[Replica Shard 1] G[Replica Shard 2] end D --> A E --> B F --> C G --> A |
|---|
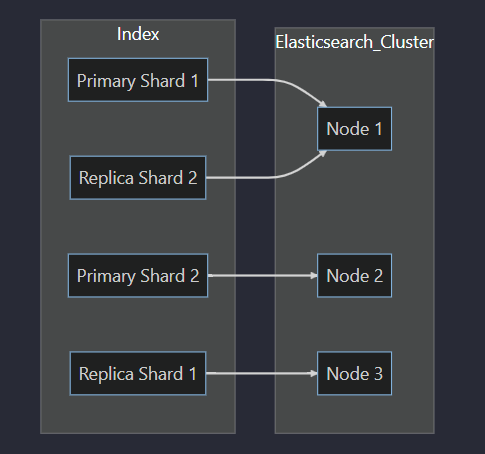
主分片 1 存储在 Node 1,主分片 2 存储在 Node 2。这符合 Elasticsearch 的默认行为,即每个主分片都会存储在不同的节点上,以提高数据的容错性和性能。
副本分片 1 存储在 Node 3,副本分片 2 存储在 Node 1。这里的副本分片会根据你的配置和集群状态动态分配到不同的节点上,以提供数据的冗余备份。
针对于某个具体的index,我们可以这样查询分片个数以及在node上的分布
| SQL curl -X GET "http://10.110.192.50:9200/_cat/indices?v" health status index uuid pri rep docs.count docs.deleted store.size pri.store.size green open track_meta19864 X3YLAIUbTs6qh9hbXVf67Q 3 0 16 0 123.6kb 123.6kb green open repository 8lj1oObOT4K2VwJvO8rrLg 1 1 2 0 19.1kb 9.5kb |
|---|
pri:表示主分片的数量。
rep:表示副本分片的数量。
docs.count:表示索引中文档的数量。
docs.deleted:表示已删除的文档数量。
store.size:表示索引占用的存储空间大小。
pri.store.size:表示主分片占用的存储空间大小。
这里我们可以观察出track_meta19864 这个index,有 3 个主分片,没有副本分片。
| SQL curl -X GET "http://10.110.192.50:9200/_cat/shards/track_meta19864?v" index shard prirep state docs store ip node track_meta19864 2 p STARTED 8 61.7kb 18.240.0.80 elasticsearch-es-es-data-1 track_meta19864 1 p STARTED 2 20.6kb 18.240.0.81 elasticsearch-es-es-master-0 track_meta19864 0 p STARTED 6 41.3kb 18.240.0.82 elasticsearch-es-es-data-0 |
|---|
这里我们可以观察出track_meta_19864 这个index的3个分片分别分布在3个node上。
侧面说明如果某个node挂了,那么我们的路人数据能检索到的数据就会少1/3。
另外使用_cluster/allocation/explain可以用于解释为什么某个分片(shard)没有被分配到某个节点或集群中的任何节点上
3. 索引(Index)、类型(Type)、文档(Document)
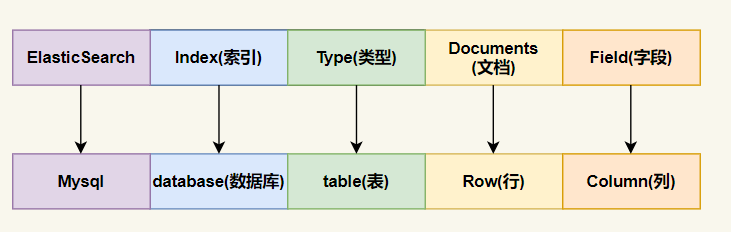
索引(Index)
定义: 索引是 Elasticsearch 中存储、管理和查询文档的地方。可以把索引看作是一个数据库中的表。
结构: 每个索引包含多个类型(在 Elasticsearch 6.x 及以前版本)和文档。
创建: 索引在创建时定义映射(Mapping)和设置(Settings)。映射定义了字段类型和字段属性,而设置包括分片和副本的数量等配置。
命名: 索引名称必须是小写,不能包含空格和一些特殊字符。
类型(Type)
定义: 类型是 Elasticsearch 6.x 及以前版本中的概念,用于将索引内的文档分类。类型相当于数据库表中的列族。
结构: 每个类型包含多个文档。不同类型可以有不同的字段。
废弃: 从 Elasticsearch 7.x 开始,类型概念被废弃,一个索引中只能包含一个类型,以简化数据模型和避免冲突。
文档(Document)
定义: 文档是 Elasticsearch 中存储的数据单元,相当于数据库表中的一行。每个文档是一个 JSON 对象。
结构: 文档包含多个字段,每个字段都有数据类型,如字符串、数字、日期等。
唯一标识: 每个文档有一个唯一的 _id 字段,作为其唯一标识符。
这里只需要关心索引在创建时定义映射(Mapping)和设置(Settings),这里关系到CRUD的性能,具体定义在:http://gitlab.yitu-inc.com/ficus/product/face_platform/-/blob/release/2.3.4/eng/deploy/middlewares/elasticsearch/action/init.py
这里就存放着track_meta_mapping,为一个es的索引模板,用于定义索引的配置和映射。
这里我们放一下简化的mapping
| JSON track_meta_mapping = """ { "settings": { "number_of_shards": %d, "number_of_replicas": 0, "index" : { "sort.field" : "timestamp", "sort.order" : "desc" , "translog.durability" : "async", "translog.sync_interval" : "30s", "refresh_interval" : "2s" } }, "mappings": { "dynamic": false, "_source": { "enabled": true }, "properties" : { "id" : { "type" : "keyword" }, "camera_id" : { "type" : "keyword" }, ... } } } """ |
|---|
| 参数 |
描述 |
|
|---|---|---|
| index_patterns |
["track_meta *"] |
指定了适用于该模板的索引名称模式,这里指定了所有以 track_meta 开头的索引都会应用这个模板。 |
| settings |
指定了索引的设置,包括主要的配置参数 |
|
| - number_of_shards |
根据代码中的动态填充 |
索引的主分片数量 |
| - number_of_replicas |
0(表示没有副本分片) |
索引的副本分片数量 |
| - index.sort.field |
"timestamp" |
索引的默认排序字段和排序顺序 |
| - index.sort.order |
"desc" |
指定了事务日志的持久性和同步间隔 index.translog.durability:默认是request,每个请求都落盘;设置成async,可异步写入 index.translog.sync_interval:默认5s,不能小于100ms |
| - translog.durability |
"async" |
索引的刷新间隔,控制了新写入数据对搜索的可见性 |
| - translog.sync_interval |
"30s" |
指定了索引的映射,定义了索引中字段的类型和属性 |
| - refresh_interval |
"2s" |
表示禁用动态映射,即不允许自动创建新字段 |
| mappings |
设置为 true,表示启用 _source 字段,允许存储文档的原始 JSON 内容。 |
|
| - dynamic |
false |
定义了索引中的字段和其属性,比如 id 和 camera_id,它们的类型都是 keyword,表示这些字段是关键字类型,通常用于精确匹配和聚合操作。 |
| - _source.enabled |
true |
|
| - properties |
||
| - id |
类型:keyword |
|
| - camera_id |
类型:keyword |
|
| - ... |
其他字段及其属性 |
这里有几个参数translog、refresh_interval在后续讲到分片具体实现细节时会涉及到。
4. ES和Lucene之间的关系
其实就是就是单机到分布式的扩展
基于关系:
Elasticsearch 是在 Lucene 基础上构建的搜索引擎。它利用 Lucene 的核心功能,并添加了分布式特性、RESTful API、数据聚合能力等功能。
功能扩展:
Elasticsearch 在 Lucene 的基础上提供了更高级的搜索和分析功能,例如集群管理、索引管理、数据复制、故障转移等功能。
易用性:
Elasticsearch 提供了更友好的 RESTful API 和 JSON 格式的交互方式,使得开发者更容易使用和集成 Elasticsearch 进行搜索应用的开发。
分布式特性:
Elasticsearch 强调分布式搜索与分析,通过水平扩展来处理大规模数据,并提供高可用性、容错性等功能。Lucene 作为其搜索核心,支持单机搜索。
5. 内部模块
| Plain Text Cluster --> allocation | | V V Discovery <-- gateway | / | V V V Indices HTTP Transport \ / Engine |
|---|
| 模块名称 |
功能描述 |
|---|---|
| ClusterCluster |
- 管理集群状态,发布新生成的集群状态到所有节点 - 触发分片分配,决策分配到哪个节点 - 迁移分片保持数据平衡 |
| allocation |
- 封装分片分配功能和策略 - 主分片和副分片的分配 - 处理创建新索引和集群完全重启等过程 |
| Discovery |
- 负责发现集群中的节点,选举主节点 - 对节点加入或退出进行相应行动 |
| gateway |
- 持久化存储Master广播下来的集群状态数据 - 在集群完全重启时恢复这些数据 |
| Indices |
- 全局级索引设置管理 - 索引数据恢复功能 - 主分片和副分片恢复在集群启动阶段实现 |
| HTTP |
- 允许通过 JSON over HTTP 访问 ES 的 API - 完全异步通信,解决 C10k 问题 |
| Transport |
- 集群内节点间的内部通信模块 - 使用 TCP 通信,维持 TCP 长连接 |
| Engine |
- 封装对 Lucene 的操作和 translog 的调用 - 提供一个分片读写操作的最终提供者 |
查询/写入与分析
1. 一条查询请求的链路
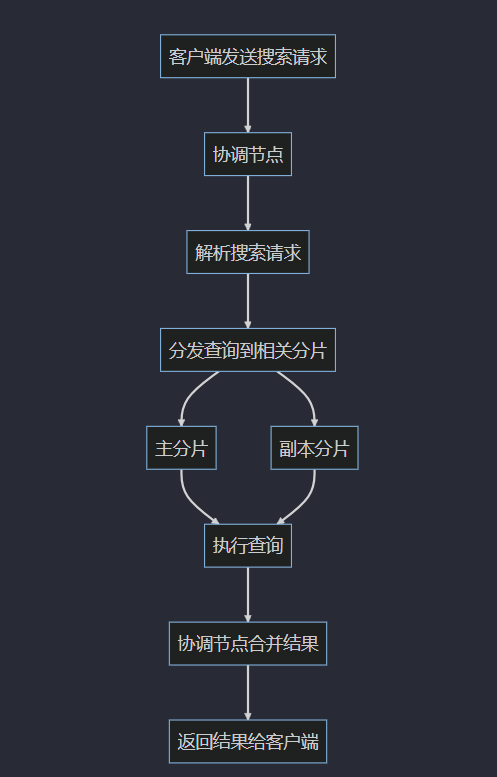
搜索请求链路
搜索请求步骤:
客户端发送请求: 客户端通过REST API发送搜索请求到集群中的任意一个节点(称为协调节点)。
协调节点解析请求: 协调节点解析搜索请求,将其转化为Lucene查询。
分发查询到分片: 协调节点将查询请求分发到相关的主分片和副本分片上。
分片执行查询: 每个分片在本地执行查询,将结果返回给协调节点。
协调节点合并结果: 协调节点收集并合并所有分片的查询结果。
返回结果给客户端: 协调节点将最终结果返回给客户端。
搜索请求流程图:
| JSON flowchart TD A[客户端发送搜索请求] --> B[协调节点] B --> C[解析搜索请求] C --> D[分发查询到相关分片] D --> E1[主分片] D --> E2[副本分片] E1 --> F[执行查询] E2 --> F[执行查询] F --> G[协调节点合并结果] G --> H[返回结果给客户端] |
|---|
2. 一条写入请求的链路
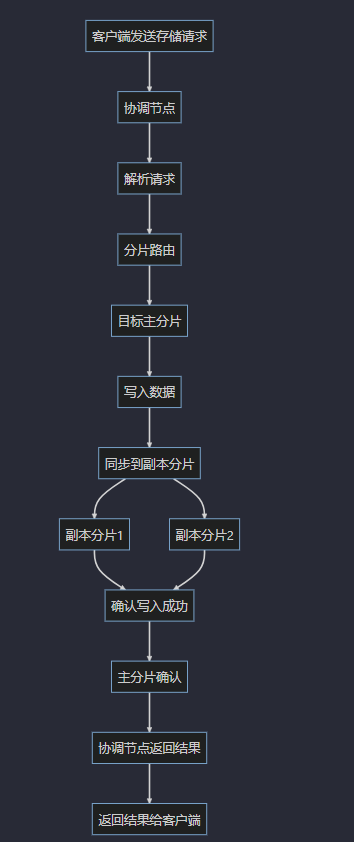
存储请求步骤:
客户端发送请求: 客户端通过REST API发送存储请求(例如索引文档请求)到集群中的任意一个节点(称为协调节点)。
协调节点解析请求: 协调节点解析请求并确定目标索引。
分片路由: 协调节点使用路由算法确定请求应发送到哪个主分片。
写入主分片: 请求被转发到目标主分片,主分片执行写入操作。
同步到副本分片: 主分片成功写入后,将变更同步到所有副本分片。
确认写入成功: 当所有副本分片确认写入成功后,主分片返回成功信息给协调节点。
返回结果给客户端: 协调节点将成功信息返回给客户端。
| JSON flowchart TD A[客户端发送存储请求] --> B[协调节点] B --> C[解析请求] C --> D[分片路由] D --> E[目标主分片] E --> F[写入数据] F --> G[同步到副本分片] G --> H1[副本分片1] G --> H2[副本分片2] H1 --> I[确认写入成功] H2 --> I[确认写入成功] I --> J[主分片确认] J --> K[协调节点返回结果] K --> L[返回结果给客户端] |
|---|
3. Elasticsearch 分片内部执行逻辑
从上面我们可以窥探查询链路,那么具体到某个分片,内部的查询/写入逻辑又是如何的?
| JSON flowchart TD subgraph Write_Operation A[文档索引请求] --> B[路由到主分片] B --> C[分析器分词] C --> D[写入内存缓冲区] D --> E[内存缓冲区刷新] E --> F[生成新的段文件] F --> G[段文件写入磁盘] G --> H[合并段文件] end subgraph Query_Operation I[查询请求] --> J[解析查询] J --> K[分片搜索线程池] K --> L[段文件读取] L --> M[内存缓存] M --> N[执行查询] N --> O[返回查询结果] end |
|---|
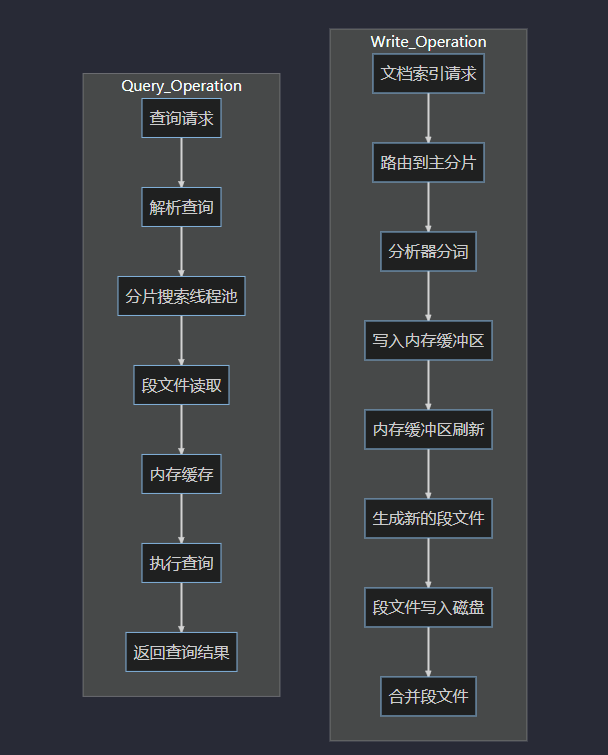
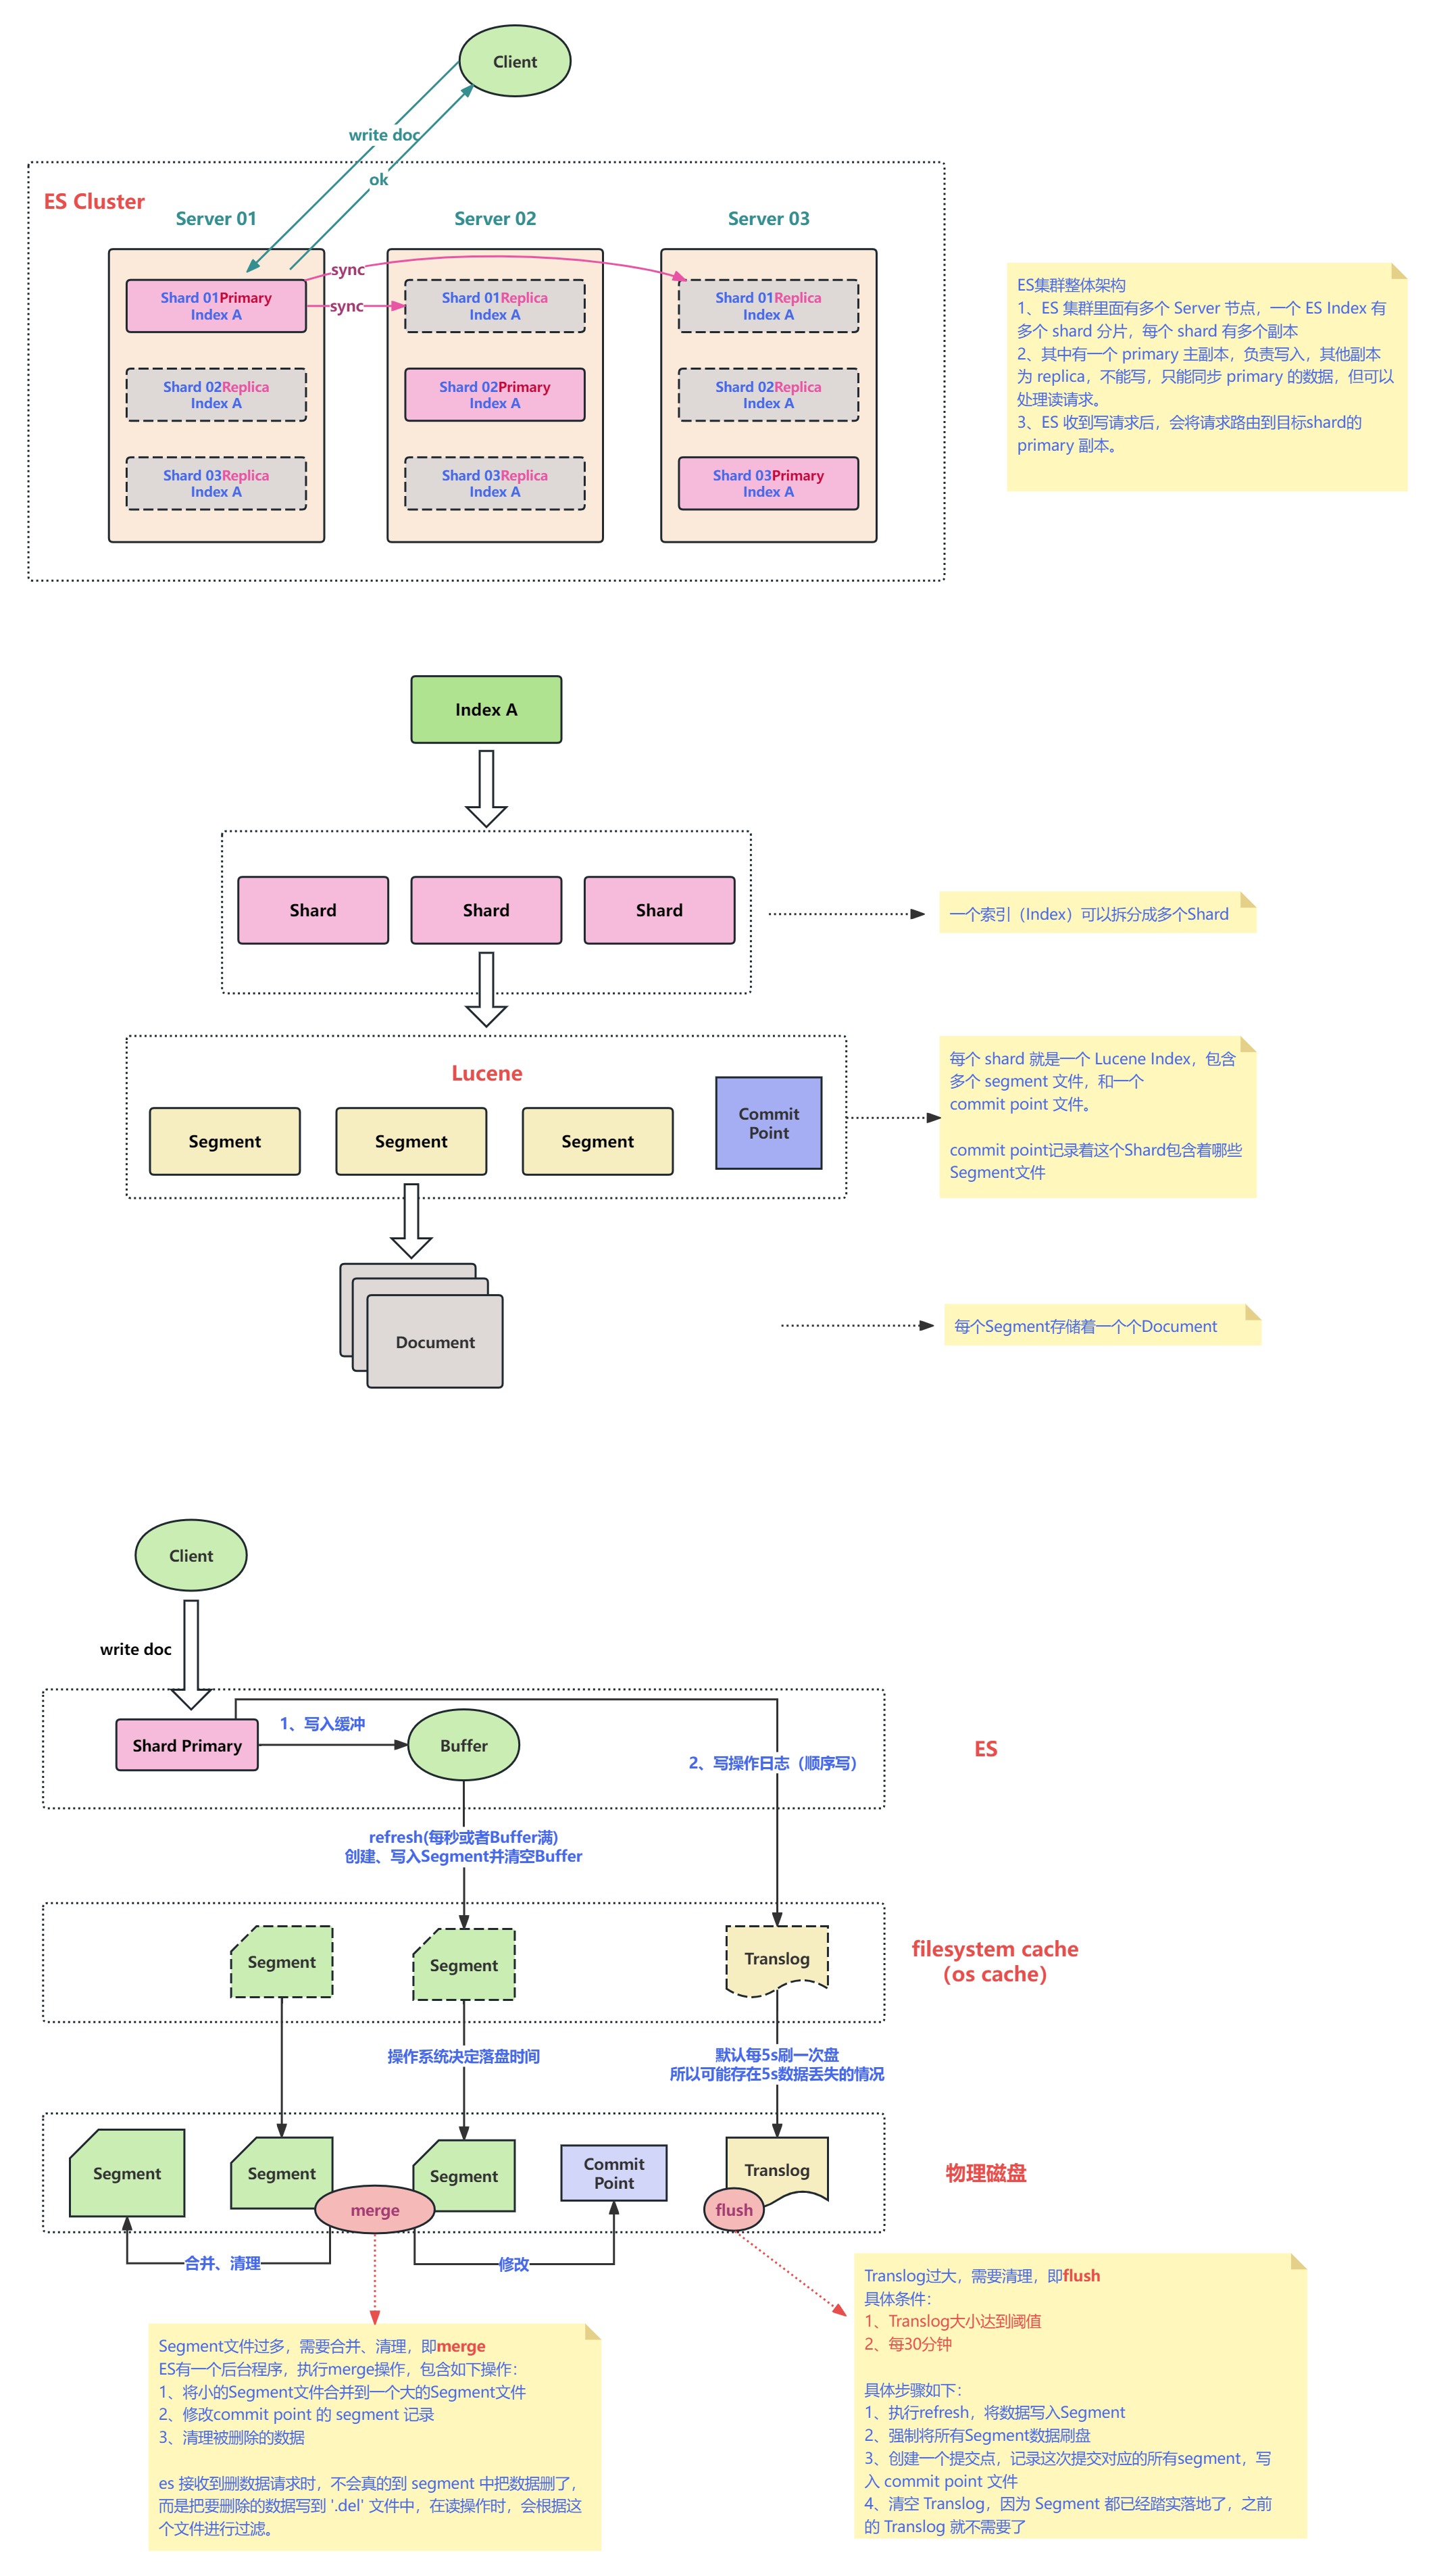
默认情况下ES每秒钟进行一次Refresh操作,将Index Buffer中的index刷新到文件系统缓存,在文件系统缓存中,是以Segment进行存储的,而且是可以被搜索到的,这就是ES实现近实时搜索:文档的更改无法立即被搜索到,但是在一定时间会变得可见。
按照时间频率触发,默认情况是每 1 秒触发 1 次 Refresh,可通过index.refresh_interval 设置;FP这边设置的是2s
手动调用调用Refresh API。
Merge触发的情况有2种:
手动调用_forcemerge API主动触发。
Flush操作是将Segment从文件系统缓存写入到磁盘进行持久化,在执行 Flush 的时候会依次执行下面操作:
记录 Commit Point
删除translog
3.2 查询逻辑
经济基础决定上层建筑,ES的分片存储决定了搜索机制。
搜索需要遍历分片所有的Lucene分段,因此合并Lucene分段对搜索性能有好处。
ES的读取分为GET和Search两种操作,这两种读取操作有较大的差异
| 操作类型 |
描述 |
实现方式 |
影响因素和特点 |
case |
|---|---|---|---|---|
| GET/MGET |
通过指定三元组(index、 type、_id)直接获取文档内容 |
实时读取,依赖于translog(5.x之前)或refresh机制(5.x之后) |
实时性高,对写入速度有负面影响 |
|
| Search |
根据关键词从倒排索引中获取内容,不需要指定文档ID |
倒排索引 |
需要复杂的查询模型,可能命中多个文档 |
| JSON GET /my_index/_ mget { "docs": [ { "_id": "1" }, { "_id": "2" } ] } |
|---|
| JSON GET /my_index/_ search { "query": { "match": { "field1": "value1" } } } |
|---|
| 操作类型 |
描述 |
实现方式 |
影响因素和特点 |
|---|---|---|---|
| GET/MGET |
通过指定三元组(index、 type、_id)直接获取文档内容。这些操作是针对单个或多个已知ID的文档的精确查询。 |
在Elasticsearch 5.x之前,依赖于translog实现实时读取。在5.x及之后的版本中,依赖于refresh机制。默认情况下,GET API是实时的,这意味着文档写入后可以立刻读取。 |
由于GET和MGET是实时操作,它们对系统的写入速度有负面影响,因为每次写入后必须刷新以确保数据可被实时读取。GET操作仅能对单个文档进行处理,指定的三元组唯一确定文档。 |
| Search |
根据关键词从倒排索引中获取内容。搜索操作不需要指定文档ID,而是根据查询条件在倒排索引中查找匹配的文档。搜索操作支持复杂的查询模型,允许在多个字段上进行关键词搜索、过滤和聚合。 |
搜索操作使用倒排索引进行查找,这种方式允许在大量文档中快速查找匹配关键词的文档。 |
搜索操作的复杂性高于GET,因为搜索需要处理和解析查询条件,并在倒排索引中查找匹配文档。搜索操作可能命中多个文档,因此搜索的性能和结果质量与查询模型和索引结构密切相关。 |
| 实时性比较 |
GET/MGET操作默认是实时的,这意味着写入文档后可以立即读取。但这种实时性仅限于GET和MGET操作,不包括搜索操作。 |
GET/MGET操作在5.x之前通过translog实现实时性,在5.x及之后通过refresh机制实现。 |
Search操作不是实时的,写入后的文档在下一次refresh之前不可见。这意味着写入操作和搜索操作之间存在一定的延迟。 |
| 写入速度影响 |
GET/MGET的实时读取特性对系统的写入速度有负面影响。因为为了确保文档可以实时读取,系统在写入后需要进行刷新操作。 |
写入后需要刷新以保证GET/MGET的实时性。 |
实时读取的要求会对写入性能产生负面影响,因为每次写入后都需要进行refresh操作。搜索操作对写入速度的影响较小,因为搜索不需要实时性,每次refresh后文档才会对搜索可见。 |
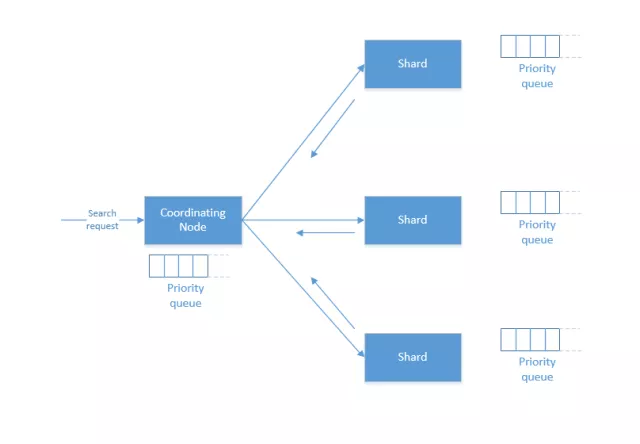
用户发出搜索请求到达ES节点。节点收到请求后,会以协调节点(Coordinating Node)的身份,在6个主副分片中随机选择3个分片,发送查询请求。
在数据节点响应query请求的时候已经完成了Query慢查询的日志统计、查询结果的打分、纠错和聚合
Coordinating节点将Query阶段从每个分片获取的排序的文档id列表重新进行排序,选取 From 到 From+size 个文档的id。以multi get请求的方式,到相应的分片获取详细的文档数据。
Query-then-Fetch存在问题分为两方面,一个是性能问题,一个是相关性算分问题。
Elasticsearch数据是分片存储的,数据分布在多台机器上。有这样一个场景,如何获取前1000个文档?当获取从990-1000的文档时候,会在每个分片上面都先获取1000个文档,然后再由协调节点聚合所有分片的结果在排序选取前1000个文档。
3.2.2 关于score计算
ES中的数据可以分为两类:精确值和全文。
· 精确值,比如日期和用户id、IP地址等。
· 全文,指文本内容,比如一条日志,或者邮件的内容。
这两种类型的数据在查询时是不同的:对精确值的比较是二进制的,查询要么匹配,要么不匹配;全文内容的查询无法给出“有”还是“没有”的结果,它只能找到结果是“看起来像”你要查询的东西,因此把查询结果按相似度排序,评分越高,相似度越大。
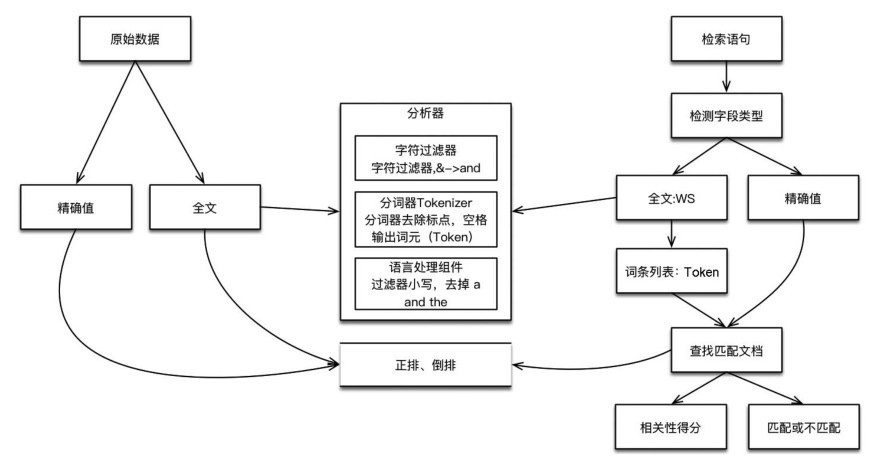
如果是全文数据,则对文本内容进行分析,这项工作在 ES 中由分析器实现。对上一步得到的Token做一些和语言相关的处理,例如,转为小写,以及将单词转换为词根的形式。语言处理组件输出的结果称为词(Term)。
分析完毕后,将分析器输出的词(Term)传递给索引组件,生成倒排和正排索引,再存储到文件系统中。
ES中正排索引(forward index)和倒排索引(inverted index)是两种不同的索引结构:
正排索引(forward index):
正排索引是文档到词项的映射,也可以理解为将文档按照顺序进行索引。每个文档包含了一个或多个词项及其相关信息,如位置、频率等。
在搜索时,需要通过正排索引来定位文档,然后再进行进一步处理。
倒排索引(inverted index):
倒排索引是词项到文档的映射,它是通过词项来查找包含该词项的所有文档。
在倒排索引中,每个词项都会记录包含该词项的文档列表,以及文档内该词项出现的位置等信息。
当用户执行搜索时,搜索引擎会首先查找倒排索引,确定包含关键词的文档列表,然后进一步筛选和排序结果。
因此,正排索引与倒排索引的主要区别在于数据的组织方式。正排索引是从文档到词项的映射,而倒排索引是从词项到文档的映射。在Elasticsearch等搜索引擎中,倒排索引被广泛应用以加快搜索速度和改善搜索性能。
它将输入文本转换为可以索引和搜索的词条(tokens)。分析器在索引和搜索两个阶段都会用到,确保输入文本和查询语句都经过一致的处理。
字符过滤器:html_strip
词条过滤器:lowercase 和 stop
字符过滤器(html_strip):
输出:Elasticsearch is a distributed, RESTful search and analytics engine.
输入:Elasticsearch is a distributed, RESTful search and analytics engine.
词条过滤器(lowercase 和 stop):
lowercase 输出:["elasticsearch", "is", "a", "distributed", "restful", "search", "and", "analytics", "engine"]
stop 输出:["elasticsearch", "distributed", "restful", "search", "analytics", "engine"](去掉了停用词“is”、“a”、“and”)
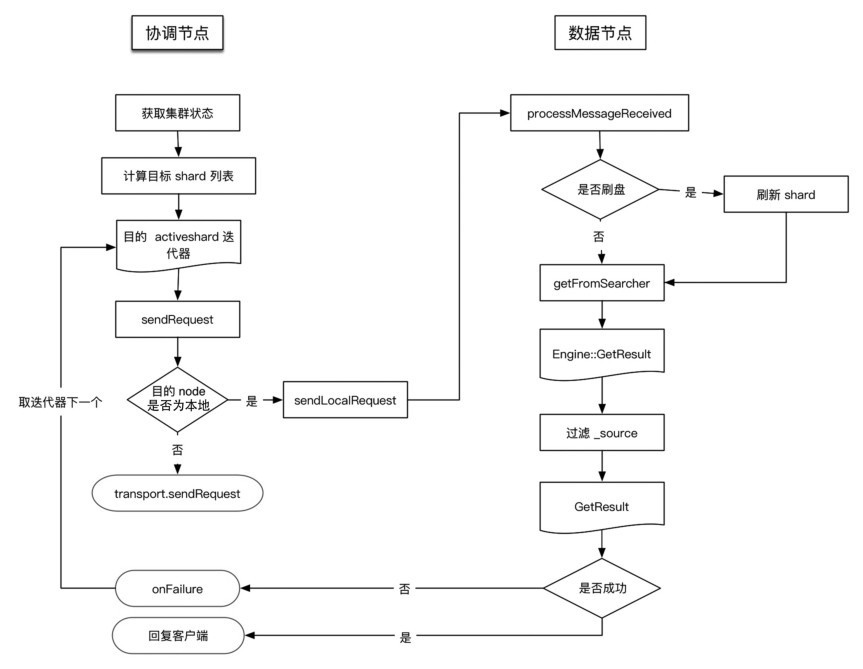
4. 源码
数据存储与管理
1. 磁盘存储的文件格式
doc : doc表示lucene中的一条记录
term :term是lucene中索引的最小单位,某个field对应的内容如果是全文检索类型,会将内容进行分词,分词的结果就是由term组成的。如果是不分词的字段,那么该字段的内容就是一个term。
正排数据:搜索引擎的通用叫法,即原始数据,可以理解为一个doc list。
每个segment会包含如下的文件。
| Name |
Extension |
Brief Description |
|---|---|---|
| Segment Info |
.si |
segment的元数据文件 |
| Compound File |
.cfs, .cfe |
一个segment包含了如下表的各个文件,为减少打开文件的数量,在segment的时候,segment的所有文件内容都保存在cfs文件中,cfe文件保存了lucene各文件在cfs文件中的位置信息 |
| Fields |
.fnm |
保存了fields的相关信息 |
| Field Index |
.fdx |
正排存储文件的元数据信息 |
| Field Data |
.fdt |
存储了正排存储数据,写入的原文存储在这 |
| Term Dictionary |
.tim |
倒排索引字典数据文件 |
| Term Index |
.tip |
倒排索引文件,存储了所有的倒排索引数据 |
| Frequencies |
.doc |
保存了每个term的doc id列表和term在doc中的词频 |
| Positions |
.pos |
Stores position information about where a term occurs in the index 全文索引的字段,会有该文件,保存了term在doc中的位置 |
| Payloads |
.pay |
Stores additional per-position metadata information such as character offsets and user payloads 全文索引的字段,使用了一些像payloads的高粒性会有该文件,保存了term在doc中的一些高粒性 |
| Norms |
.nvd, .nvm |
文件保存索引字段加权数据 |
| Per-Document Values |
.dvd, .dvm |
lucene的docvalues文件,即数据的列式存储,用作聚合和排序 |
| Term Vector Data |
.tvx, .tvd, .tvf |
Stores offset into the document data file 保存索引字段的矢量信息,用在对term进行高亮,计算文档相关性中使用 |
| Live Documents |
.liv |
记录了segment中删除的doc |
使用track_result/fetch_total拉取100条数据,约347.51k,对应这么多docs,实际的track_meta的json数据占用量为:102,566,186K = 97G。存储下来实际耗费30G,应该是有数据压缩.
| health |
status |
index |
uuid |
pri |
rep |
docs.count |
docs.deleted |
store.size |
pri.store.size |
|---|---|---|---|---|---|---|---|---|---|
| green |
open |
track_meta19841 |
qIvBoK1uTsWYvBK05Nwb4g |
3 |
0 |
29514600 |
374015 |
30gb |
30gb |
| Bash /usr/share/elasticsearch/data/nodes/0/indices/qIvBoK1uTsWYvBK05Nwb4g/0/index |
|---|
可以观察到单个shard上的index数据空间10G,乘上分片数3,正好等于store.size
| 后缀 |
Total size |
占比 |
作用 |
命令 |
|---|---|---|---|---|
| fdm |
12k |
find . -type f -name " *.fdm" -exec du -ch {} + |
||
| fdt |
8.6G |
86% |
存储了正排存储数据,写入的原文存储在这 |
find . -type f -name " *.fdt" -exec du -ch {} + |
| fdx |
180k |
find . -type f -name " *.fdx" -exec du -ch {} + |
||
| fnm |
48k |
find . -type f -name " *.fnm" -exec du -ch {} + |
||
| kdd |
74M |
find . -type f -name " *.kdd" -exec du -ch {} + |
||
| kdi |
264K |
find . -type f -name " *.kdi" -exec du -ch {} + |
||
| kdm |
12k |
find . -type f -name " *.kdm" -exec du -ch {} + |
||
| dvd |
211M |
2% |
lucene的docvalues文件,即数据的列式存储,用作聚合和排序 |
find . -type f -name " *.dvd" -exec du -ch {} + |
| dvm |
36K |
find . -type f -name " *.dvm" -exec du -ch {} + |
||
| si |
100K |
find . -type f -name " *.si" -exec du -ch {} + |
||
| cfe |
88K |
find . -type f -name " *.cfe" -exec du -ch {} + |
||
| cfs |
938M |
9.1% |
segment的所有文件内容都保存在cfs文件中 |
find . -type f -name " *.cfs" -exec du -ch {} + |
| segments_2x |
4k |
find . -type f -name "segments_2x" -exec du -ch {} + |
||
| total |
10G |
|||
| raw_data total |
97 / 3 = 32G |
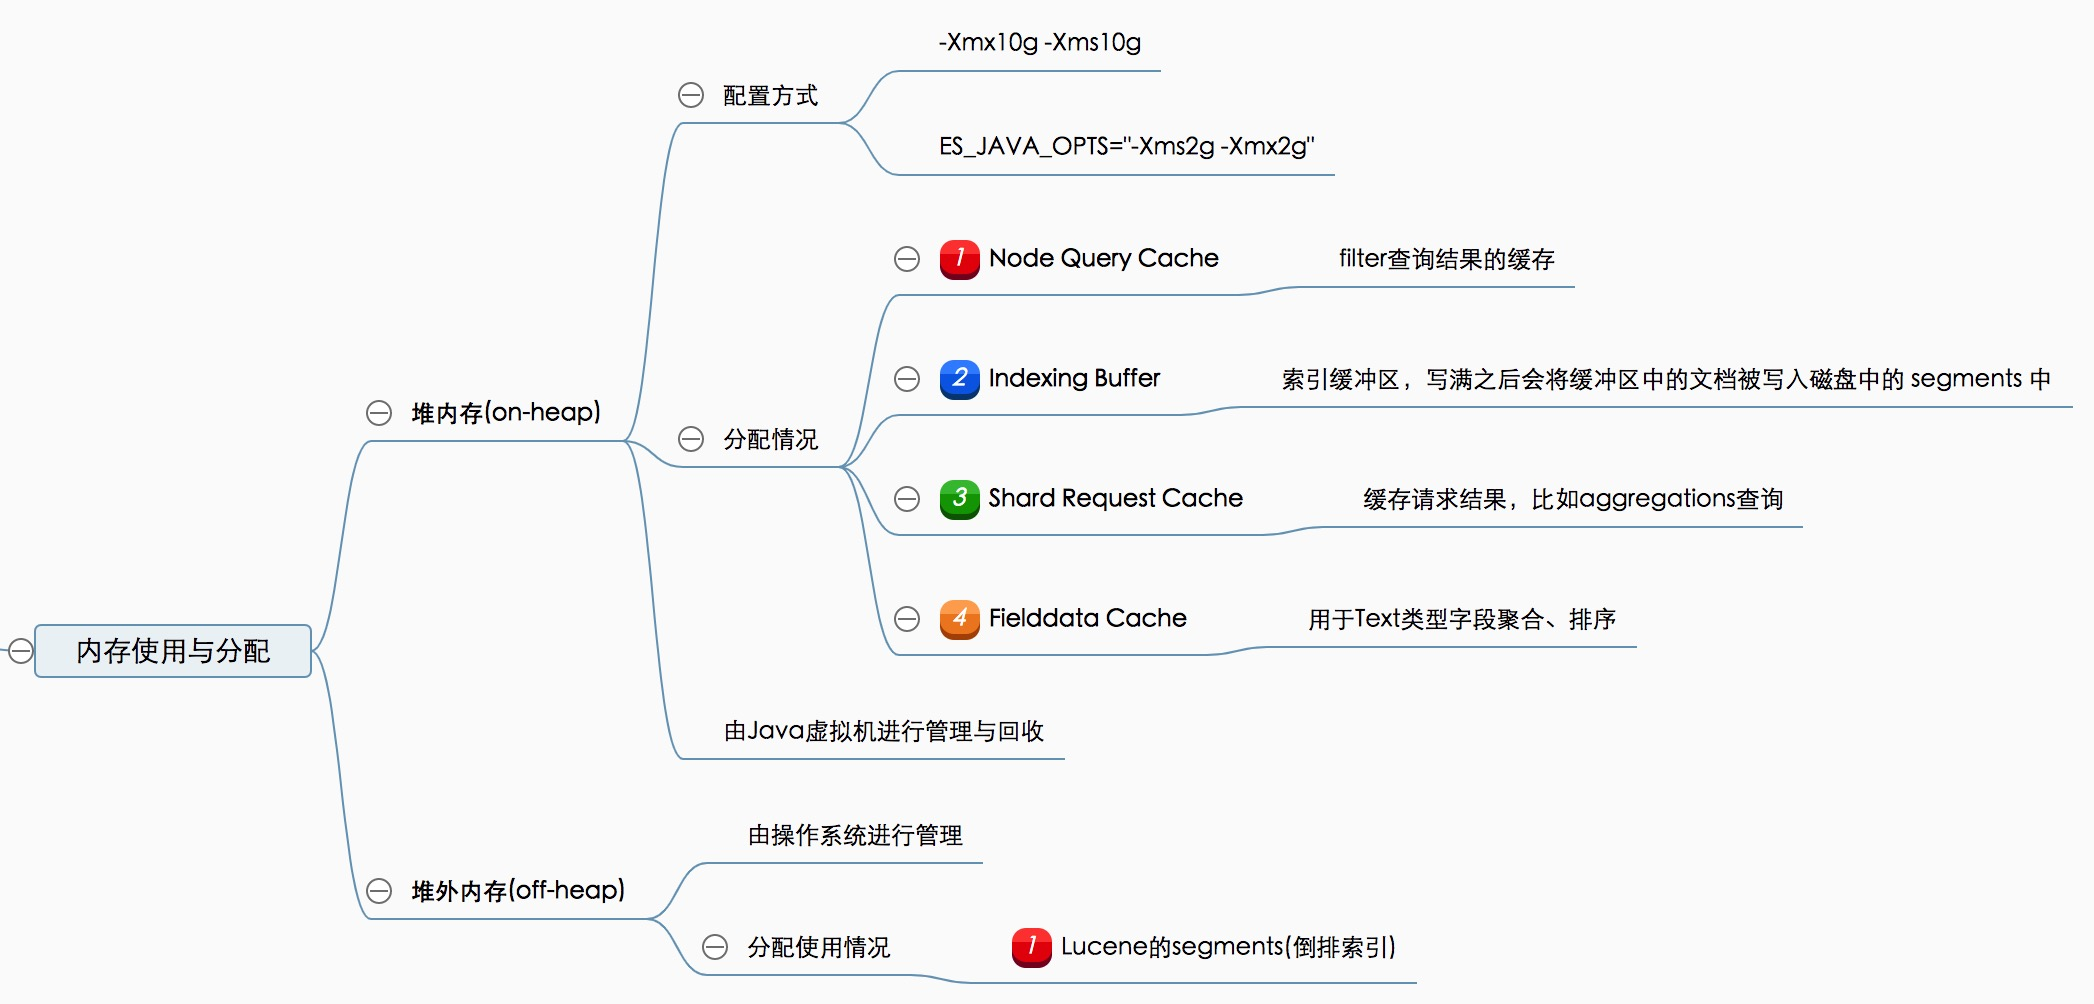
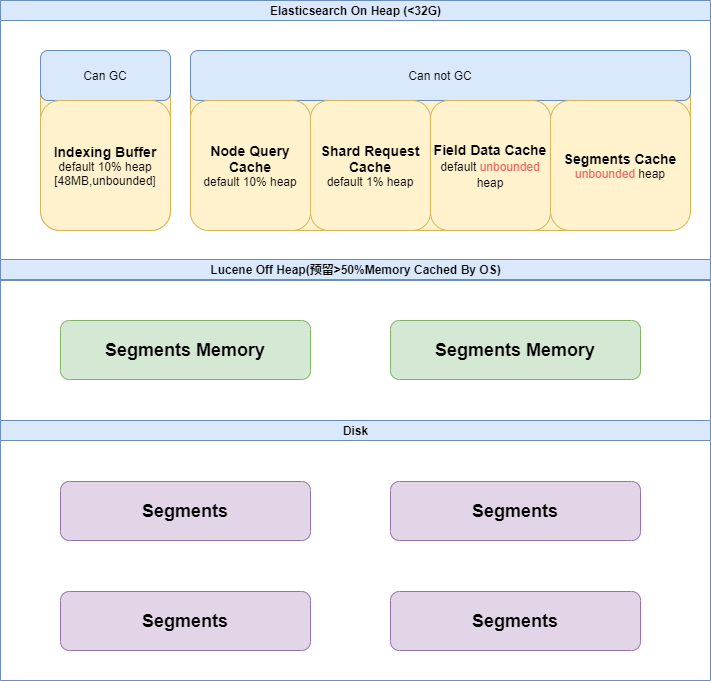
| 内存管理方式 |
类目 |
层级 |
默认占比 |
是否常驻 |
淘汰策略 (在控制大小情况下) |
作用 |
控制参数 |
其他补充 |
|---|---|---|---|---|---|---|---|---|
| 非GC |
query cache |
node-level |
10% |
是 |
LRU |
能够被当前节点的所有shard所共享,用于缓存filter的查询结果 |
indices.queries.cache.size 用来控制缓存的内存大小,默认是10%,属于节点级别配置。支持百分数,也支持大小精确值。该配置属于静态配置,更改配置需要重启节点 index.queries.cache.enabled 用来控制具体索引是否启用缓存,默认是开启的。属于index级别配置。只用在索引创建时候或者关闭的索引上设置 indices.queries.cache.all_segments 用于控制是否在所有Segment上启用缓存,默认是false,即不会对文档数小于100000或者小于整个索引大小的3%的Segment进行缓存 |
|
| request cache |
shard-level |
1% |
是 |
LRU |
当进行索引搜索时候,每个相关的shard在本地执行搜索,并将其本地结果返回给协调节点(Coordinating Node),协调节点将这些分片级别的结果合并为一个“全局”结果集。 仅缓存 size=0 的搜索请求,即不反悔具体文档内容,只返回统计信息 缓存 hits.total 缓存 aggregations 缓存 suggestions |
indices.requests.cache.size 设置请求缓存大小,默认是1%。该配置是静态配置。 索引的请求缓存默认是开启的,该配置可以动态开启或关闭 需要在那些需要缓存的搜索请求上加上request_cache=true这个参数才能使我们的查询请求被缓存 |
我们可以通过以_statAPI查看分片请求缓存大小 |
|
| fielddata cache |
segment-level |
无限制 (ES 默认禁用) |
是 |
LRU |
Text类型的字段,如果要对其进行聚合和排序,则需要打开字段的Fileddata属性 当对该字段进行聚合,排序时候,ES会把Field Data中加载到内存中,构建成Fielddata Cache 整个segment生命周期内都存在,是无法GC的。 |
indices.fielddata.cache.size 用来控制索引的fileddata cache大小。默认是unbounded。支持百分数,也支持大小精确值。该参数是静态配置类型。 大小默认是没有限制的原因是fielddata不是临时性的cache,它能够极大地提升性能,而且构建fielddata又比较耗时的操作,所以需要一直cache。 如果没有足够的内存保存fielddata时,Elastisearch会不断地从磁盘加载数据到内存,并剔除掉旧的内存数据。剔除操作会造成严重的磁盘I/O,并且引发大量的GC,会严重影响Elastisearch的性能。 indices.breaker.fielddata.limit 用来设置Fielddata断路器限制大小,默认是JVM heap大小的40%。当加载的内存中fielddata数据超过该限制大小,会发生异常,目的为了防止发生JVM OOM。该值可以动态设置,建议配置该项的值: indices.breaker.fielddata.overhead 用来设置fielddata过载值,默认值是1.03 |
我们可以通过以下API查看fielddata大小: |
|
| segment memory |
无限制 (需要监控) |
是 |
无 |
segments FST(Finite State Transducer)数据的缓存,为倒排索引的二级索引。 FST 永驻堆内内存,无法被 GC 回收。该部分内存无法设置大小,长期占用 50% ~ 70% 的堆内存,只能通过delete index,close index以及force-merge index释放内存。从7.3版本开始,FST由堆外内存来存储 |
不能通过参数控制 |
|||
| GC |
Index buffer |
node-level |
10% |
否 |
GC |
当文档创建时候,会先保存在IndexBuffer中,然后每隔index.refresh_interval或者索引缓存满的时候进行refresh操作,将文档的段存在系统缓存中,此时文档才能搜索到。索引缓冲是可以通过GC被反复利用的。 |
indices.memory.index_buffer_size 用于控制index buffer大小,属于节点级别配置。默认是10%,即允许分配到整个堆大小的10%。支持百分数,也支持大小精确值。 indices.memory.min_index_buffer_size 用于控制index buffer大小的最小值,当index_buffer_size为百分数时候,才生效。默认是48mb indices.memory.max_index_buffer_size 用于控制index buffer大小的最大值,当index_buffer_size为百分数时候,才生效。默认是unbounded(无上限的) |
| Bash PUT /my-index/_settings { "index.requests.cache.enable": true } |
|---|
| Bash curl 'localhost:9200/index_name/_ search?request_cache=true' -d' |
|---|
| Bash GET /_stats/request_cache?human // 查看每个索引的request cache大小 GET /_nodes/stats/indices/request_cache?human // 按节点查看request cache 大小 |
|---|
| Bash GET /_nodes/stats/indices/fielddata?human GET /_cat/nodes?v&h=id,ip,port,v,master,name,heap.current,heap.percent,heap.max,ram.current,ram.percent,ram.max,fielddata.memory_size,fielddata.evictions,query_cache.memory_size,query_cache.evictions, request_cache.memory_size,request_cache.evictions,request_cache.hit_count,request_cache.miss_count GET /_cat/fielddata?v |
|---|
2.2 堆外内存
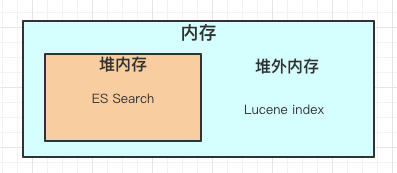
服务器总内存除过给jvm配置的其余都给了lucene,占用page cache内存,page cache保存对文件数据segment(segment是shard数据的一部分内容)的缓存。缓存索引的部分数据,用于提升查询响应(segment越大查询的名字率就越高查询性能越高,这也就是es查询响应ms级和s的主要差别所在就是内存)
服务器执行:free -g可查看内存使用,es节点只有es服务,基本cache就是缓存的segment。
我们可以通过cat segments查看索引的segment使用内存的情况:
| Bash GET /_cat/segments?v |
|---|
清除全部的缓存:
| Bash POST /_cache/clear |
|---|
清除特定索引的缓存:
| Bash POST /my_index/_ cache/clear POST /my_index1,my_index2/_cache/clear |
|---|
清除特定类型缓存:
通过设置fielddata,query,request参数为true来清除特定类型的缓存
| Bash POST /my-index/_cache/clear?fielddata=true POST /my-index/_cache/clear?query=true POST /my-index/_cache/clear?request=true |
|---|
节点负载详解
| Bash curl -s "10.108.138.231:9200/_cat/nodes?h=ip,hp,rp,rc,rm,fm,sm,sc,qcm,sqti,dt,du&v" ip:node.ip cpu:cpu使用率 hp:堆内存使用 rp:ram.percent,总内存使用量百分比,保持在75%以下最好 rc:Used total memory,使用总内存大小 rm:ram.max:总内存大小 fm:fielsdata.sizeMemoey:字段缓存 sm:segment.memory:segment使用的内存 sc:segments.count:segment的数量 qcm:query_cache.memory_size:查询缓存的内存使用 sqti:search.query_time:查询总用时 dt:disk.total:所有磁盘空间 du:disk.used:使用的磁盘空间 |
|---|
好的,以下是将名称转换为中文后的表格:
| IP |
堆内存使用 |
总内存使用量百分比 |
使用总内存大小 |
总内存大小 |
字段缓存 |
Segment使用的内存 |
Segment的数量 |
查询缓存的内存使用 |
查询总用时 |
所有磁盘空间 |
使用的磁盘空间 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 18.240.0.240 |
40 |
100 |
9.9gb |
10gb |
0b |
9.7mb |
1429 |
123.7mb |
11.2h |
12.2tb |
5.7tb |
| 18.240.0.242 |
70 |
100 |
9.9gb |
10gb |
0b |
9.4mb |
1411 |
112.2mb |
10.8h |
12.2tb |
5.7tb |
| 18.240.0.241 |
37 |
100 |
9.9gb |
10gb |
0b |
9.6mb |
1427 |
153.3mb |
10.4h |
12.2tb |
5.7tb |
| Bash curl -s "10.108.138.231:9200/_nodes/stats/jvm?human" |
|---|
结果如下:https://jsonhero.io/j/Pw9NwMuLR613?path=%24.nodes.26Ife_H_RQG9AOqf0IXO3A.jvm
| Bash GET _cluster/health |
|---|
| Bash { "cluster_name": "elasticsearch_zach", "status": "green", "timed_out": false, "number_of_nodes": 1, "number_of_data_nodes": 1, "active_primary_shards": 10, "active_shards": 10, "relocating_shards": 0, "initializing_shards": 0, "unassigned_shards": 0 } |
|---|
响应信息中最重要的一个指标 status 字段。状态可能是下列三个值之一:
green
所有的主分片和副本分片都已分配。你的集群是 100% 可用的。
yellow
所有的主分片已经分片了,但至少还有一个副本是缺失的。不会有数据丢失,所以搜索结果依然是完整的。不过,你的高可用性在某种程度上被弱化。如果 更多的 分片消失,你就会丢数据了。把 yellow 想象成一个需要及时调查的警告。
red
至少一个主分片(以及它的全部副本)都在缺失中。这意味着你在缺少数据:搜索只能返回部分数据,而分配到这个分片上的写入请求会返回一个异常。
其他信息输出
| Bash GET _cluster/health?level=indices |
|---|
| Bash { "cluster_name": "elasticsearch_zach", "status": "red", "timed_out": false, "number_of_nodes": 8, "number_of_data_nodes": 8, "active_primary_shards": 90, "active_shards": 180, "relocating_shards": 0, "initializing_shards": 0, "unassigned_shards": 20 "indices": { "v_1": { "status": "green", "number_of_shards": 10, "number_of_replicas": 1, "active_primary_shards": 10, "active_shards": 20, "relocating_shards": 0, "initializing_shards": 0, "unassigned_shards": 0 }, "v_2": { "status": "red", "number_of_shards": 10, "number_of_replicas": 1, "active_primary_shards": 0, "active_shards": 0, "relocating_shards": 0, "initializing_shards": 0, "unassigned_shards": 20 }, "v_3": { "status": "green", "number_of_shards": 10, "number_of_replicas": 1, "active_primary_shards": 10, "active_shards": 20, "relocating_shards": 0, "initializing_shards": 0, "unassigned_shards": 0 }, .... } } |
|---|
| 序号 |
指标 |
类型 |
详情 |
|---|---|---|---|
| 1 |
elasticsearch_indices_search_query_total |
counter |
查询总数 吞吐量 |
| 2 |
elasticsearch_indices_search_query_time_seconds |
counter |
查询总时间 性能 |
| 3 |
elasticsearch_indices_search_fetch_total |
counter |
提取总数 |
| 4 |
elasticsearch_indices_search_fetch_time_seconds |
counter |
花费在提取上的总时间 |
| 5 |
elasticsearch_indices_get_time_seconds |
counter |
GET请求总时间 |
| 6 |
elasticsearch_indices_get_missing_total |
counter |
丢失的文件的GET请求总数 |
| 7 |
elasticsearch_indices_get_missing_time_seconds |
counter |
花费在文档丢失的GET请求上的总时间 |
| 8 |
elasticsearch_indices_get_exists_time_seconds |
counter |
花费在文档存在的GET请求上的总时间 |
| 9 |
elasticsearch_indices_get_exists_total |
counter |
存在的文件的GET请求总数 |
| 10 |
elasticsearch_indices_get_total |
counter |
GET请求总次数 |
对于一个写入较为频繁的系统,refresh 和 flush 操作相关的指标较为重要,merge 相关的指标也需要关注,同时整个写入的耗时,搜索文档总数也需要关注,故而需要关注的写入相关指标为:
| 序号 |
指标 |
类型 |
详情 |
|---|---|---|---|
| 1 |
elasticsearch_indices_indexing_index_total |
counter |
被索引的文档总数 |
| 2 |
elasticsearch_indices_indexing_index_time_seconds_total |
counter |
索引文档花费的总时间 |
| 3 |
elasticsearch_indices_refresh_total |
counter |
索引refresh的总数 |
| 4 |
elasticsearch_indices_refresh_time_seconds_total |
counter |
refresh索引总共花费的时间 |
| 5 |
elasticsearch_indices_flush_total |
counter |
flush索引到磁盘的总数 |
| 6 |
elasticsearch_indices_flush_time_seconds |
counter |
flush索引到磁盘的总花费时间 |
| 7 |
elasticsearch_indices_merges_total |
counter |
Total merges(merge操作总次数) |
| 8 |
elasticsearch_indices_merges_total_time_seconds_total |
counter |
索引merge操作总花费时间 |
| 9 |
elasticsearch_indices_merges_Docs_total |
counter |
merge的文档总数 |
| 10 |
elasticsearch_indices_merges_total_size_bytes_total |
counter |
merge的数据量合计 |
| 11 |
elasticsearch_indices_indexing_delete_total |
counter |
索引的文件删除总数 |
| 12 |
elasticsearch_indices_indexing_delete_time_seconds_total |
counter |
索引的文件删除总时间 |
2.3 内存使用和垃圾回收指标
| 序号 |
指标 |
类型 |
详情 |
|---|---|---|---|
| 1 |
elasticsearch_jvm_gc_collection_seconds_sum |
counte |
JVM GC垃圾回收时间 |
| 2 |
elasticsearch_jvm_gc_collection_seconds_count |
counter |
JVM GC 垃圾搜集数 |
| 3 |
elasticsearch_jvm_memory_committed_bytes |
gauge |
JVM最大使用内存限制 |
| 4 |
elasticsearch_jvm_memory_max_bytes |
gauge |
配置的最大jvm值 |
| 5 |
elasticsearch_jvm_memory_pool_max_bytes |
counter |
JVM内存最大池数 |
| 6 |
elasticsearch_jvm_memory_pool_peak_max_bytes |
counter |
最大的JVM内存峰值 |
| 7 |
elasticsearch_jvm_memory_pool_peak_used_bytes |
counter |
池使用的JVM内存峰值 |
| 8 |
elasticsearch_jvm_memory_pool_used_bytes |
gauge |
目前使用的JVM内存池 |
| 9 |
elasticsearch_jvm_memory_used_bytes |
gauge |
2.4 主机级别网络系统指标
主机级别资源及网络使用情况也需要关注。
| 序号 | 指标 | 类型 | 详情 |
| 1 | elasticsearch_cluster_health_status | gauge | 集群状态,green( 所有的主分片和副本分片都正常运行)、yellow(所有的主分片都正常运行,但不是所有的副本分片都正常运行)red(有主分片没能正常运行)值为1的即为对应状态 |
| 2 | elasticsearch_cluster_health_number_of_data_nodes | gauge | node节点的数量 |
| 3 | elasticsearch_cluster_health_number_of_in_flight_fetch | gauge | 正在进行的碎片信息请求的数量 |
| 4 | elasticsearch_cluster_health_number_of_nodes | gauge | 集群内所有的节点 |
| 5 | elasticsearch_cluster_health_number_of_pending_tasks | gauge | 尚未执行的集群级别更改 |
| 6 | elasticsearch_cluster_health_initializing_shards | gauge | 正在初始化的分片数 |
| 7 | elasticsearch_cluster_health_unassigned_shards | gauge | 未分配分片数 |
| 8 | elasticsearch_cluster_health_active_primary_shards | gauge | 活跃的主分片总数 |
| 9 | elasticsearch_cluster_health_active_shards | gauge | 活跃的分片总数(包括复制分片) |
| 10 | elasticsearch_cluster_health_relocating_shards | gauge | 当前节点正在迁移到其他节点的分片数量,通常为0,集群中有节点新加入或者退出时该值会增加 |
| 11 | elasticsearch_breakers_tripped | counter | 熔断发生次数 |
| 12 | elasticsearch_breakers_limit_size_bytes | gauge | 熔断内存限制大小 |
| 13 | elasticsearch_breakers_estimated_size_bytes | gauge | 熔断器内存大小 |
ElasticSearch 节点使用线程池来管理线程如何消耗内存和 CPU,所以需要监控线程相关的指标。
| 序号 | 指标 | 类型 | 详情 |
| 1 | elasticsearch_thread_pool_completed_count | gauge | 线程池操作完成线程数 |
| 2 | elasticsearch_thread_pool_active_count | gauge | 线程池活跃线程数 |
| 3 | elasticsearch_thread_pool_largest_count | gauge | 线程池最大线程数 |
| 4 | elasticsearch_thread_pool_queue_count | gauge | 线程池中的排队线程数 |
| 5 | elasticsearch_thread_pool_active_count | gauge | 线程池的被拒绝线程数 |
| 6 | elasticsearch_indices_fielddata_memory_size_bytes | gauge | fielddata缓存的大小(字节) |
| 7 | elasticsearch_indices_fielddata_evictions |
常见的一些问题排查方案
1.使用 explain 分析查询
Elasticsearch 提供了对于查询的 explain 功能,可以帮助我们辅助分析执行计划。
explain 功能可以提供查询的详细执行计划,显示每个部分是如何匹配和评分的。
| JSON GET /<index>/_search { "query": { "match": { "field": "value" } }, "explain": true } |
|---|
explain 的输出包含了每个分片的详细信息,包括每个文档的评分解释。这有助于理解哪些部分耗时较长,或者为什么某些文档得分较高。
分析慢查询
Elasticsearch 提供了慢查询日志(slow log)功能,帮助识别和分析慢查询。以下是启用和查看慢查询日志的步骤。
在 Elasticsearch 配置文件(elasticsearch.yml)中设置慢查询日志阈值。例如:
| YAML index.search.slowlog.threshold.query.warn: 10s index.search.slowlog.threshold.query.info: 5s index.search.slowlog.threshold.query.debug: 2s index.search.slowlog.threshold.query.trace: 500ms index.indexing.slowlog.threshold.index.warn: 10s index.indexing.slowlog.threshold.index.info: 5s index.indexing.slowlog.threshold.index.debug: 2s index.indexing.slowlog.threshold.index.trace: 500ms |
|---|
上述配置将记录超过指定时间的慢查询日志。
慢查询日志通常保存在 Elasticsearch 日志目录中(例如 /var/log/elasticsearch)。可以查看相应的日志文件:
搜索慢查询日志:elasticsearch_index_search_slowlog.log
索引慢查询日志:elasticsearch_index_indexing_slowlog.log
慢查询日志记录了详细的查询信息,包括查询内容、耗时、分片信息等。这有助于识别哪些查询比较慢,以及是哪些分片导致的。
优化查询性能
根据 explain 和慢查询日志的分析结果,可以采取以下措施优化查询性能:
优化查询语句: 简化查询条件,避免使用复杂的正则表达式和大量的 wildcard 查询。
合理设计索引: 使用适当的映射和分词器,创建必要的索引和别名。
分页查询: 对于大结果集,使用 scroll API 进行分页查询,避免一次性返回所有数据。
缓存: 使用 Elasticsearch 提供的缓存功能,如结果缓存和请求缓存,提高查询响应速度。
增加资源: 如果查询量大且资源紧张,可以考虑增加节点和分片,平衡负载。
示例:慢查询优化
假设我们有以下慢查询:
| JSON GET /my_index/_ search { "query": { "match": { "description": "some long and complex query" } } } |
|---|
通过 explain 和慢查询日志发现,match 查询在 description 字段上耗时较长。优化方案可能包括:
优化字段映射: 确保 description 字段的映射和分词器适合查询需求。
使用更高效的查询类型: 如果适用,改用 term 查询而不是 match 查询。
减少查询范围: 使用过滤器(如 bool 查询中的 filter)来减少需要查询的数据量。
优化后的查询可能是:
| JSON GET /my_index/_ search { "query": { "bool": { "filter": [ { "term": { "status": "active" } } ], "must": [ { "match": { "description": "some long and complex query" } } ] } } } |
|---|
通过合理使用 filter 可以减少查询的计算量,因为过滤器不会影响评分且可以被缓存。
通过 explain 功能和慢查询日志,可以详细分析 Elasticsearch 的查询性能,识别和优化慢查询。合理设计索引结构和查询语句,使用缓存和增加资源,可以有效提升查询效率。
2. 使用profile api
lasticsearch的Profile API用于分析和优化查询的性能。它可以帮助你了解查询的执行过程以及每个阶段花费的时间,从而找出瓶颈和优化点。
使用Profile API的步骤
构建查询:构建你需要分析的查询。
添加profile参数:在查询请求中添加profile参数,并将其设置为true。
执行查询:执行查询并查看返回的结果。
分析结果:查看返回的结果中的profile部分,分析查询的执行情况。
假设我们这里有个结构化查询语句,这个是它初始语句(在176上)
| Bash curl --location --request POST '10.108.138.231:9200/track_meta,track_meta19869,track_meta19870,track_meta19871,track_meta19872/_ search?ignore_unavailable=true' --header 'Content-Type: application/json' --data-raw '{ "query": { "bool": { "must": [ { "terms": { "camera_id": [ 23812, 24353, 29938, 16367, 9161 ] } }, { "term": { "is_set_face_data": true } }, { "range": { "timestamp": { "gt": 1716825600, "lt": 1716912000 } } } ] } }, "size": 2, "sort": [ { "timestamp": { "order": "desc" } } ] } ' |
|---|
接下来我们加入profile参数
| Bash curl --location --request POST '10.108.138.231:9200/track_meta,track_meta19869,track_meta19870,track_meta19871,track_meta19872/_ search?ignore_unavailable=true' --header 'Content-Type: application/json' --data-raw '{ "profile": true, "query": { "bool": { "must": [ { "terms": { "camera_id": [ 23812, 24353, 29938, 16367, 9161 ] } }, { "term": { "is_set_face_data": true } }, { "range": { "timestamp": { "gt": 1716825600, "lt": 1716912000 } } } ] } }, "size": 2, "sort": [ { "timestamp": { "order": "desc" } } ] } ' |
|---|
输出的数据比较多,这里直接放上文件
with_profile.json
without_profile.json
会发现with_profile中增加了一个profile字段
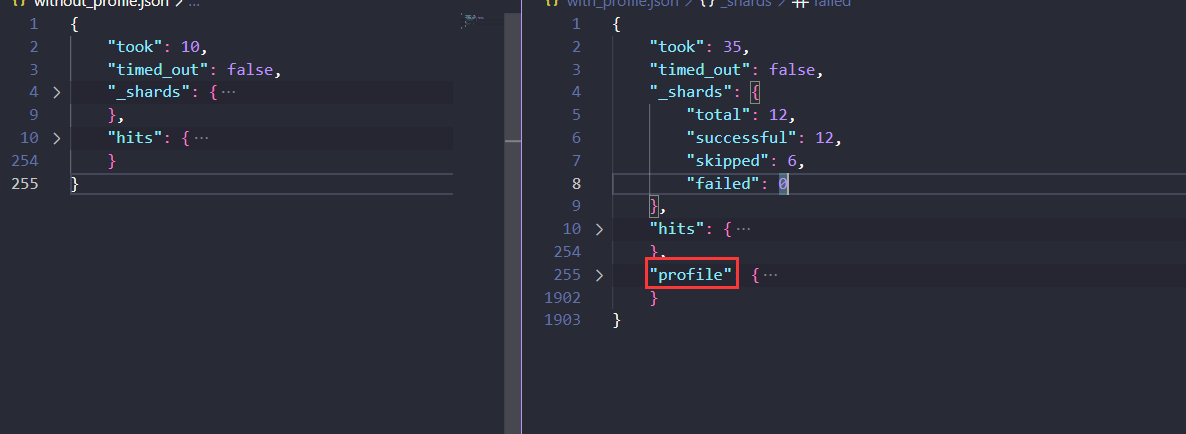
返回结果中包含了一个profile字段,里面详细描述了每个分片的查询执行情况。以下是几个关键部分:
type:查询的类型,例如BooleanQuery。
description:查询的描述,例如title:elasticsearch。
time_in_nanos:查询花费的时间(纳秒)。
breakdown:每个阶段的时间分解,例如创建权重时间、构建评分器时间、匹配文档时间等。
通过这些信息,你可以了解查询的各个阶段花费的时间,找出性能瓶颈,并进行相应的优化。
3. 使用explain api分析unassigned shards
使用Elasticsearch的Explain API分析unassigned shards的具体步骤如下:
检查集群状态:首先,查看集群状态以识别是否有未分配的分片。
使用Explain API:对未分配的分片使用Explain API进行分析。
查看分片分配说明:解释未分配分片的原因。
解决问题:根据解释的原因采取相应的措施解决未分配分片的问题。
以下是详细步骤:
详细步骤
检查集群状态
使用GET /_cluster/health检查集群健康状态,确认是否存在未分配的分片。
| Bash GET /_cluster/health |
|---|
列出未分配的分片
使用GET /_cat/shards列出所有分片并找到未分配的分片。
| Bash GET /_cat/shards |
|---|
使用Explain API
对于每个未分配的分片,使用Explain API进行分析。例如,假设索引为my_index,分片ID为0:
| Bash POST /_cluster/allocation/explain { "index": "my_index", "shard": 0, "primary": true } |
|---|
查看分片分配说明
查看Explain API的响应,分析未分配的原因。
| JSON { "index": "my_index", "shard": 0, "primary": true, "current_state": "unassigned", "unassigned_info": { "reason": "INDEX_CREATED", "at": "2023-06-03T00:00:00.000Z", "last_allocation_status": "no_attempt" }, "can_allocate": "no", "allocate_explanation": "cannot allocate because allocation is not permitted to any of the nodes" } |
|---|
解决问题
根据解释的原因采取相应措施。例如,如果是因为没有足够的磁盘空间,则需要增加节点的磁盘空间。
4. 节点CPU使用率高
| 原因 |
描述 |
|---|---|
| 查询负载增加 |
Elasticsearch 集群承受查询负载增加会导致 CPU 使用率升高,通常出现在索引大量新数据或搜索流量增加的情况下。 |
| 索引负载增加 |
Elasticsearch 集群承受索引负载增加会导致 CPU 使用率升高,通常发生在索引大量新数据的情况下。 |
| GC(垃圾回收) |
Elasticsearch Java 进程进行垃圾回收时,CPU 使用率上升。GC 清理 Java 堆内存中不再使用的对象,频率和时间随对象数量增加而增加。 |
| 机器性能不足 |
Elasticsearch 部署的机器性能不足会导致 CPU 使用率升高,如慢速 CPU 处理器、内存不足、磁盘 I/O 较慢等。 |
| 插件/脚本等性能问题 |
插件或脚本存在性能问题会导致 CPU 使用率升高。某些插件或脚本可能影响 Elasticsearch 性能,如复杂脚本或调用较慢的第三方库。 |
Elasticsearch集群的CPU使用率升高时,可以考虑调整哪些参数
| 参数 |
描述 |
建议值范围 |
|---|---|---|
| indices.store.throttle.max_bytes_per_sec |
限制每秒写入的数据量,减缓写入速度。过高的写入速度可能导致CPU使用率升高。最优值取决于硬件配置和负载情况,一般设置为每秒写入速率的80%到90%。 |
40MB/s 到 45MB/s |
| indices.memory.index_buffer_size |
调整索引缓冲区大小,避免频繁IO操作增加CPU负载。建议设置为可用内存的20%到30%。 |
20GB 到 30GB |
| indices.fielddata.cache.size |
增大字段数据缓存大小,减少磁盘读取操作。建议设置为可用内存的20%到30%。 |
20GB 到 30GB |
| indices.queries.cache.size |
增大查询缓存大小,减少频繁查询操作增加CPU负载。建议设置为查询缓存占用可用内存的20%到30%。 |
20GB 到 30GB |
| indices.recovery.max_bytes_per_sec |
限制每秒恢复的数据量,减缓恢复速度。快速恢复可能导致CPU使用率升高。建议设置为每秒恢复速率的80%到90%。 |
40MB/s 到 45MB/s |
| indices.search.slowlog.threshold.query.warn |
调整查询慢日志告警阈值,快速发现查询慢的问题。建议设置为查询执行时间的90%到95%。 |
900ms 到 950ms |
在这个github的issues中有一些关于ES的建议配置:https://github.com/elastic/elasticsearch/issues/4288
以下是将上述配置项转换成表格形式的输出:
| 类别 |
配置项名称 |
配置值 |
描述 |
|---|---|---|---|
| 内存设置 |
bootstrap.mlockall |
true |
强制JVM将所有内存锁定在物理内存中,防止交换到磁盘。 |
| 线程池设置 |
threadpool.search.type |
fixed |
使用固定大小的线程池。 |
| threadpool.search.size |
20 |
搜索线程池的线程数为20。 |
分配给索引缓冲区的内存比例为30%。 |
| threadpool.search.queue_size |
200 |
搜索线程池的队列大小为200。 |
字段数据缓存的大小为总内存的30%。 |
| threadpool.bulk.type |
fixed |
使用固定大小的线程池。 |
索引的刷新间隔时间为30秒。 |
| threadpool.bulk.size |
60 |
批量处理线程池的线程数为60。 |
|
| threadpool.bulk.queue_size |
3000 |
批量处理线程池的队列大小为3000。 |
|
| threadpool.index.type |
fixed |
使用固定大小的线程池。 |
|
| threadpool.index.size |
20 |
索引线程池的线程数为20。 |
|
| threadpool.index.queue_size |
1000 |
索引线程池的队列大小为1000。 |
|
| 索引设置 |
indices.memory.index_buffer_size |
30% |
|
| indices.memory.min_shard_index_buffer_size |
12mb |
每个分片的最小索引缓冲区大小为12MB。 |
|
| indices.memory.min_index_buffer_size |
96mb |
索引缓冲区的最小大小为96MB。 |
|
| 缓存大小设置 |
indices.fielddata.cache.size |
30% |
|
| indices.cache.filter.size |
30% |
过滤缓存的大小为总内存的30%。 |
|
| 写操作的索引设置 |
index.refresh_interval |
30s |
|
| index.translog.flush_threshold_period |
5m |
事务日志刷新阈值时间为5分钟。 |
|
| index.merge.scheduler.max_thread_count |
1 |
合并调度器的最大线程数为1。 |
排查的时候还可以通过API查看hot_threads:
| Bash GET _nodes/hot_threads ::: {test}{ikKuXkFvRc-qFCqG99smGg}{VE-uqoiARoONJwomfPwRBw}{127.0.0.1}{127.0.0.1:9300}{ml.machine_memory=8481566720, ml.max_open_jobs=20, ml.enabled=true} Hot threads at 2018-04-09T15:58:21.117Z, interval=500ms, busiestThreads=3, ignoreIdleThreads=true: 0.0% (0s out of 500ms) cpu usage by thread 'Attach Listener' unique snapshot unique snapshot unique snapshot unique snapshot unique snapshot unique snapshot unique snapshot unique snapshot unique snapshot unique snapshot |
|---|
5. 节点内存使用率高
ES内存使用率过高,可以考虑调整哪些参数
| 参数 |
描述 |
建议值范围 |
|---|---|---|
| indices.memory.index_buffer_size |
控制索引模块使用的内存缓冲区大小。降低该值可减少内存占用,但可能影响性能。建议设置为每个索引的可用堆内存的5%-10%。 |
5%-10%的可用堆内存 |
| indices.fielddata.cache.size |
控制字段数据缓存大小。降低该值可减少内存占用,但可能影响查询性能。建议设置为10%-30%的可用堆内存。 |
10%-30%的可用堆内存 |
| indices.queries.cache.size |
控制查询缓存大小。降低该值可减少内存占用,但可能影响查询性能。建议设置为10%-30%的可用堆内存。 |
10%-30%的可用堆内存 |
| indices.breaker.* |
控制熔断器阈值,用于保护内存和磁盘资源。调整阈值可避免过度使用内存。 |
适应具体情况调整 |
| indices.recovery.max_bytes_per_sec |
控制恢复速度,降低该值可减少内存占用。建议根据网络带宽进行调整,设置为网络带宽的70%-80%。 |
网络带宽的70%-80% |
6. 节点GC频率过高
| 原因 |
描述 |
|---|---|
| JVM堆内存不足 |
当JVM堆内存不足时,会导致GC频繁触发,通常由于索引数据量增加或查询负载增加等原因导致。 |
| 索引数据过多 |
当索引数据量过多时,会占用大量内存空间,导致JVM堆内存不足,进而引发GC频繁触发。 |
| 查询压力过大 |
查询压力过大会导致Elasticsearch集群需要处理大量查询请求,可能引起JVM堆内存不足,导致GC频繁触发。 |
| 代码逻辑问题 |
存在代码逻辑问题(如内存泄漏)可能导致JVM堆内存占用过高,诱发GC频繁触发。 |
| 解决方法 |
描述 |
具体demo |
|---|---|---|
| 增加JVM堆内存大小 |
增加JVM堆内存大小可以有效降低GC频率,应设置为应用程序需求的最小值加一定余量以确保系统有足够内存。 |
java -Xms31G -Xmx31G -jar your-application.jar |
| 优化查询和索引操作 |
通过优化查询和索引操作来减少GC频率,例如使用filter替代query、避免过度聚合、减少脚本使用等。 |
json GET /_search { "query": { "bool": { "filter": [ { "term": { "status": "active" } } ] } } } |
| 使用合适的垃圾回收器 |
选择适合的垃圾回收器可以降低GC频率。CMS适合实时处理,G1适合大型堆内存应用程序。 |
java -XX:+UseG1GC -jar your-application.jar |
| 使用合适的JVM参数 |
合适的JVM参数对GC频率影响重大,可通过设置堆内存大小、调整垃圾回收器参数等方式来减少GC频率。 |
java -Xms31G -Xmx31G -XX:+UseG1GC -XX:MaxGCPauseMillis=200 -jar your-application.jar |
7. 节点磁盘使用率过高
| 原因 |
描述 |
|---|---|
| 数据量 |
Elasticsearch的磁盘使用率与数据量直接相关,随着数据量增加,磁盘使用率也会相应增加。 |
| 索引设置 |
分片和副本设置会影响数据在磁盘上的存储方式和占用空间大小。分片数量多意味着每个分片占用空间小,但可能增加额外磁盘空间占用。 |
| 索引更新频率 |
索引频繁更新会导致写入更多数据到磁盘,增加磁盘使用率。 |
| 删除操作 |
删除文档不会立即释放磁盘空间,而通过后台段合并操作来回收空间。频繁删除文档可能需定期执行段合并操作以避免持续增加磁盘使用率。 |
| 数据复制 |
支持副本机制导致每个副本需要额外磁盘空间。 |
| 磁盘类型 |
不同类型磁盘对性能和空间占用影响不同,如固态硬盘比机械硬盘更快但成本更高,机械硬盘适合低成本应用。 |
| 处理方案 |
描述 |
|---|---|
| 添加更多节点 |
通过添加更多节点扩展集群存储能力,减轻单节点负担。 |
| 删除旧或不需要数据 |
删除旧或不需要数据释放磁盘空间,确保数据不再需要,因为删除是不可逆操作。 |
| 压缩索引 |
Elasticsearch提供工具压缩索引,在不降低性能情况下减小索引大小。 |
| 增加磁盘空间 |
若磁盘使用率升高由磁盘空间不足导致,可考虑增加磁盘空间。 |
| 调整文档存储方式 |
调整文档存储方式减小磁盘使用率,例如设置字段为不索引或压缩存储。 |
8. 分词导致的检索不到结果
FP不存在这个问题,FP使用的是标准分词器,并且检索
https://www.cnblogs.com/sgh1023/p/15691061.html
ES的节点:https://www.elastic.co/guide/en/elasticsearch/reference/7.10/modules-node.html
https://juejin.cn/post/7222440107214274597
https://www.shenyanchao.cn/blog/2018/12/04/lucene-fst/
| SQL curl -X GET "http://10.102.178.118:9200/_nodes" curl -X GET "http://10.102.178.118:9200/_cluster/state" curl -X GET "http://10.108.138.231:9200/_cat/indices?v" curl -X GET "http://10.110.192.50:9200/_cat/indices/repository?v" curl -X GET "http://10.101.162.184:9200/_cat/shards?v" curl -X GET "http://10.110.192.50:9200/_cat/shards/track_meta19864?v" |
|---|
Comments 0
Sign in to comment and like
No comments yet.