原理
Kafka 的存储设计 (Append Only Data Structures)
为什么kafka不允许多个consumer消费同一个partition
其他
https://cloud.tencent.com/developer/article/2258899
kafka的可靠性保证
核心是保证消息在传递过程中不丢失,核心环节如下:
- msg 从producer可靠发送至broker: 网络、本地丢数据
- 发送到broker的msg的可靠持久化: pagecache缓存落盘、单点崩溃、主从同步跨网络
- consumer从broker消费消息,且最好只消费1次:跨网络消息传输
1 消息从生产者可靠地发送至 Broker
消息从生产者可靠地发送至 Broker,需要确保:
- producer发送消息后,能够收到来自broker的消息保存成功的ack
- producer发送消息后,能够捕获超时、失败ack等异常ack并做处理
1.1 ack 策略
Kafka 为我们提供了三种 ack 策略
acks = 0:请求发送即认为成功,不关心有没有写成功,常用于日志进行分析场景
acks = 1:当leader patition写入成功以后才算写入成功,有丢数据的可能(如果Leader副本在消息写入后但在消息复制到其他Follower副本之前失败(比如宕机或数据未持久化到磁盘就发生故障),那么这条消息就有可能丢失)
acks = -1:ISR列表中所有副本都写完以后,消息才算写入成功,强可靠性保证
1.2 消息发送策略
kafka 提供两类消息发送方式:同步(sync)发送和异步(async)发送
在消息发送的过程中,无论是同步发送还是异步发送都会涉及到两个协程--负责消息发送的主协程和负责消息分发的 dispatcher 协程。
异步发送
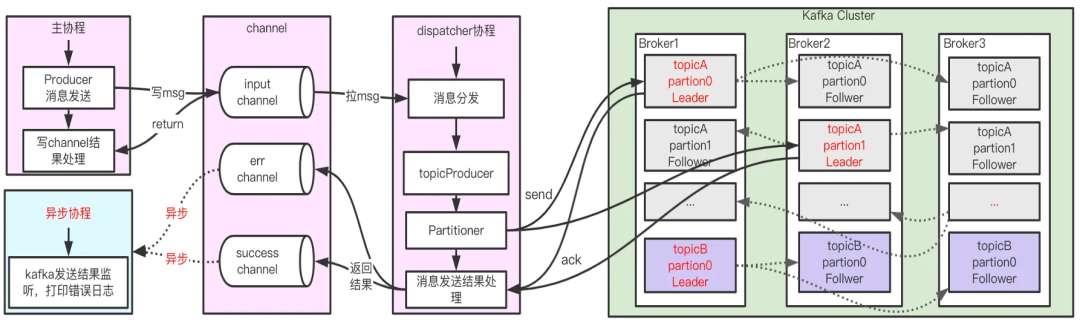
- 在主协程中调用异步发送 kafka 消息的时候,其本质是将消息体放进了一个 input 的 channel,只要入 channel 成功,则这个函数直接返回,不会产生任何阻塞。相反,如果入 channel 失败,则会返回错误信息。因此调用 async 写入的时候返回的错误信息是入 channel 的错误信息,至于具体最终消息有没有发送到 kafka 的 broker,我们无法从返回值得知。
- 当消息进入 input 的 channel 后,会有另一个 dispatcher 的协程负责遍历 input,来真正发送消息到特定 Broker 上的主 Partition 上。发送结果通过一个异步协程进行监听,循环处理 err channel 和 success channel,出现了 error 就记一个日志。因此异步写入场景时,写 kafka 的错误信息,我们暂时仅能够从这个错误日志来得知具体发生了什么错,并且也不支持我们自建函数进行兜底处理,这一点在 trpc-go 的官方也得到了承认。
同步发送
同步消息发送在 newSyncProducerFromAsyncProducer 中开启两个异步协程处理消息成功与失败的“回调”,并使用 waitGroup 进行等待,从而将异步操作转变为同步操作
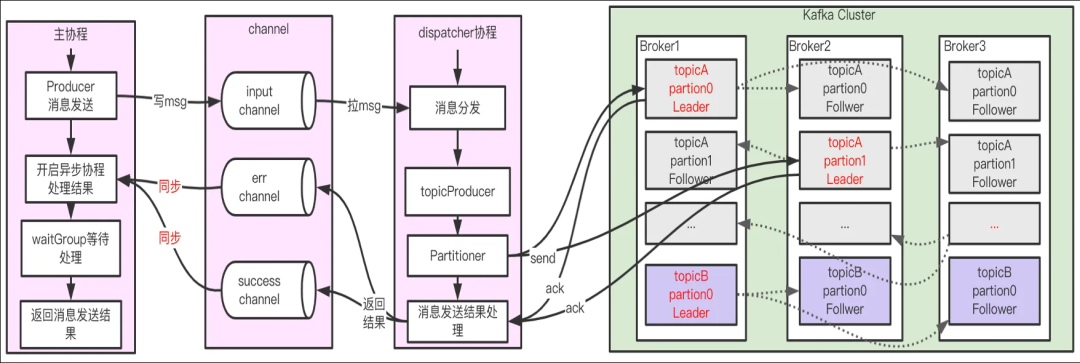
kafka 消息发送本质上都是异步的,不过同步发送通过 waitGroup 将异步操作转变为同步操作。同步发送在一定程度上确保了我们在跨网络向 Broker 传输消息时,消息一定可以可靠地传输到 Broker
1.3至少一次、精确一次
同步发送场景我们可以明确感知消息是否发送至 Broker,若因网络抖动、机器宕机等故障导致消息发送失败或结果不明,可通过重试等手段确保消息至少一次(at least once) 发送到 Broker。另外,Kafka(0.11.0.0版本后)还为 Producer 提供两种机制来实现精确一次(exactly once) 消息发送:幂等性(Idempotence)和事务(Transaction)。
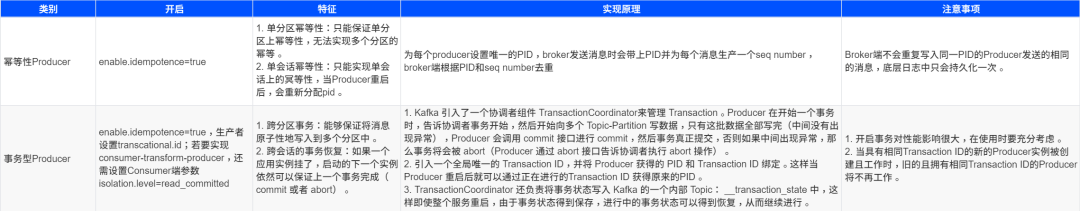
当然可以,以下是翻译后的表格内容:
| 类别 | 开启 | 特征 | 实现原理 | 注意事项 |
|---|---|---|---|---|
| 幂等性Producer | enable.idempotence=true |
1. 单分区幂等性:只能保证单分区上消息等性,无法实现多个分区的幂等。 2. 单会话幂等性:只能实现单会话上的幂等性,当Producer重启后,会重新分配pid。 |
为每个producer设置唯一的PID,broker发送消息时会带上PID并为每个消息生成一个seq number,broker根据PID和seq number去重。 | Broker端不会重复写入同一PID的Producer发送的相同消息,底层日志中只会持久化一次。 |
| 事务型Producer | enable.idempotence=true,生产者设置transactional.id;若要实现consumer-transform-producer,还需要设置enable.transform=true,以及auto.commit.offset |
1. 跨分区事务:能够保证跨消息原子性地写入到多个分区中。 2. 跨会话的事务恢复:如果一个应用实例挂了,启动的下一个实例依然可以继续上一个事务完成(commit/abort)。 |
1. Kafka引入了一个协调者角色TransactionCoordinator来管理事务。Producer在开始一个事务时,告诉协调者事务开始,然后开始向多个Topic-Partition写数据,只有这批数据全部写入成功(中间没有出现异常)Producer会调用commit接口进行commit,然后事务真正提交,否则如果中间出现异常,那么事务将会被abort(Producer通过abort接口告诉协调者执行abort操作)。 2. 引入一个全局唯一的Transaction ID,并与Producer获得的PID和Transaction ID绑定,这样当Producer重启后依然可以通过正在进行的Transaction ID获得原来的PID。 3. TransactionCoordinator还负责将事务状态写入Kafka的一个内部Topic:_transactional.state中,这样即使整个服务重启,由于事务状态得到保存,进行中的事务状态可以得到恢复,从而继续进行。 |
1. 开启事务对性能影响很大,在使用时要充分考虑。 2. 当具有相同Transaction ID的新的Producer实例被创建且工作时,旧的且拥有相同Transaction ID的Producer将不再工作。 |
1.4 小结
通过ack策略配置、同步发送、事务消息组合能力,可以实现exactly once语义跨网络向broker传输消息。
但是producer收到broker的成功ack后,消息未必不会丢失
2 发送到Broker的消息可靠持久化
- Broker 返回 Producer 成功 ack 时,消息是否已经落盘;
- Broker 宕机是否会导致数据丢失,容灾机制是什么
- Replica 副本机制带来的多副本间数据同步一致性问题如何解决
2.1 Broker 异步刷盘机制
kafka 为了获得更高吞吐,Broker 接收到消息后只是将数据写入 PageCache 后便认为消息已写入成功,而 PageCache 中的数据通过 linux 的 flusher 程序进行异步刷盘(刷盘触发条:主动调用 sync 或 fsync 函数、可用内存低于阀值、dirty data 时间达到阀值),将数据顺序写到磁盘。消息处理示意图如下:
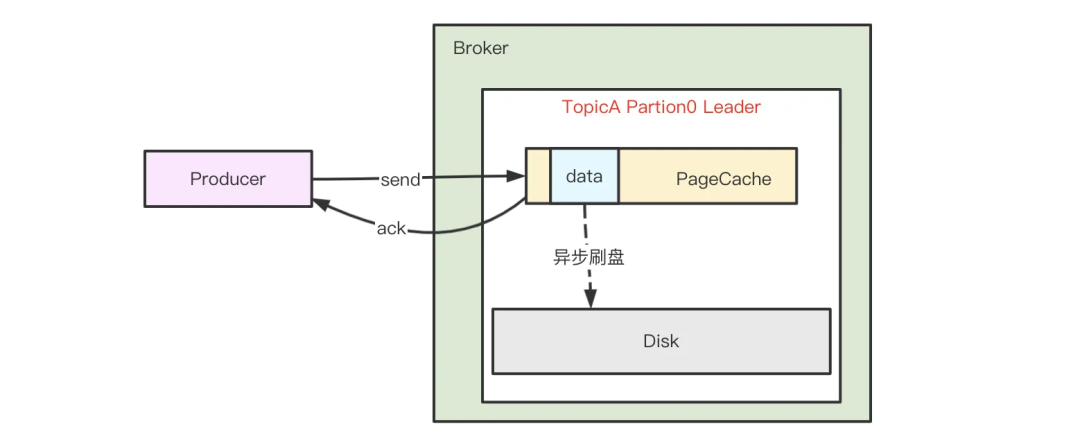
由于消息是写入到 PageCache ,单机场景,如果还没刷盘 Broker 就宕机了,那么 Producer 产生的这部分数据就可能丢失。为了解决单机故障可能带来的数据丢失问题,Kafka 为分区引入了副本机制。
2.2 Replica 副本机制
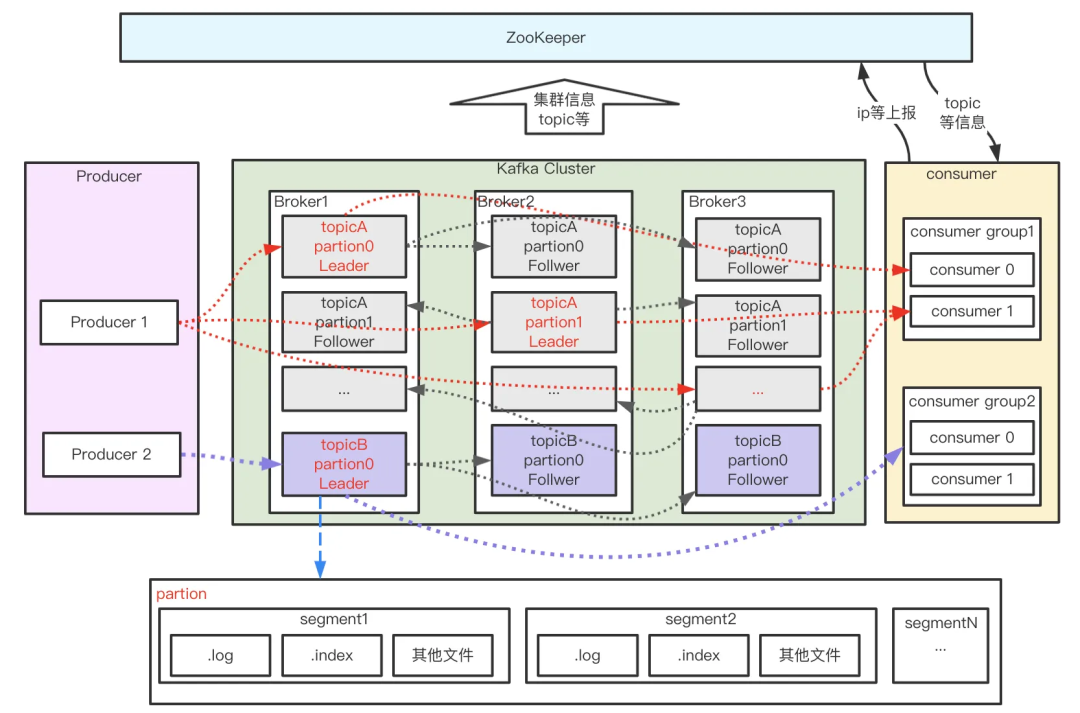
Kafka 每组分区通常有多个副本,同组分区的不同副本分布在不同的 Broker 上,保存相同的消息(可能有滞后)
副本之间是“一主多从”的关系,其中 leader 副本负责处理读写请求,follower 副本负责从 leader 拉取消息进行同步
分区的所有副本统称为 AR(Assigned Replicas),其中所有与 leader 副本保持一定同步的副本(包括 leader 副本在内)组成ISR(In-Sync Replicas)
与 leader 同步滞后过多的副本组成 OSR(Out-of-Sync Replicas)
由此可见,AR=ISR+OSR
follower 副本是否与leader同步的判断标准取决于 Broker 端参数 replica.lag.time.max.ms(默认为10秒),follower 默认每隔 500ms 向 leader fetch 一次数据,只要一个 Follower 副本落后 Leader 副本的时间不连续超过10秒,那么 Kafka 就认为该 Follower 副本与 leader 是同步的。在正常情况下,所有的 follower 副本都应该与 leader 副本保持一定程度的同步,即 AR=ISR,OSR 集合为空。
当 leader 副本所在 Broker 宕机时,Kafka 会借助 ZK 从 follower 副本中选举新的 leader 继续对外提供服务,实现故障的自动转移,保证服务可用。为了使选举的新 leader 和旧 leader 数据尽可能一致,当 leader 副本发生故障时,默认情况下只有在 ISR 集合中的副本才有资格被选举为新的 leader,而在 OSR 集合中的副本则没有任何机会(可通过设置unclean.leader.election.enable改变)。
当 Kafka 通过多副本机制解决单机故障问题时,同时也带来了多副本间数据同步一致性问题。Kafka 通过高水位更新机制、副本同步机制、 Leader Epoch 等多种措施解决了多副本间数据同步一致性问题,下面我们来依次看下这几大措施
2.3 多副本之间一致性
首先,我们来看下两个和Kafka中日志相关的重要概念 HW 和 LEO:
- HW:High Watermark,高水位,表示已经提交(commit)的最大日志偏移量
Kafka 中某条日志“已提交”的意思是 ISR 中所有节点都包含了此条日志,并且消费者只能消费 HW 之前的数据;
- LEO: Log End Offset,表示当前 log 文件中下一条待写入消息的 offset;
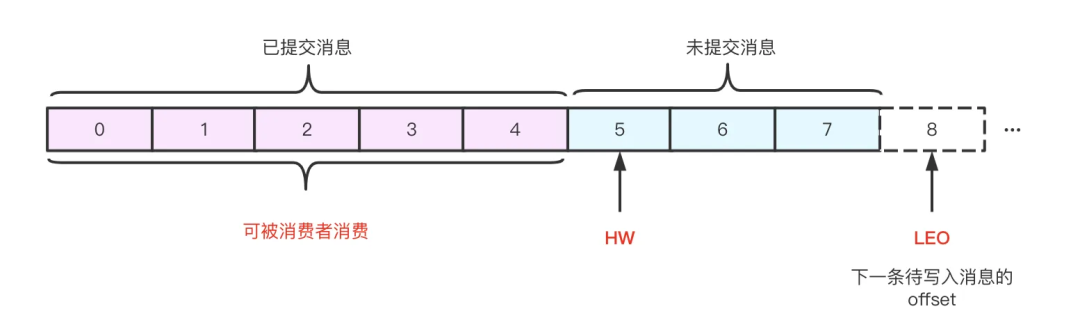
它代表一个日志文件,这个日志文件中有8条消息,0至5之间的消息为已提交消息,5至7的消息为未提交消息。日志文件的 HW 为5,表示消费者只能拉取到5之前的消息,而 offset 为5的消息对消费者而言是不可见的。日志文件的 LEO 为8,下一条消息将在此处写入。
所有副本都有对应的 HW 和 LEO,只不过 Leader 副本比较特殊,Kafka 使用 Leader 副本的高水位来定义所在分区的高水位。换句话说,分区的高水位就是其 Leader 副本的高水位。Leader 副本和 Follower 副本的 HW 有如下特点
- Leader HW: min(所有副本 LEO),为此 Leader 副本不仅要保存自己的 HW 和 LEO,还要保存 follower 副本的 HW 和 LEO,而 follower 副本只需保存自己的 HW 和 LEO;
- Follower HW: min(follower 自身 LEO,leader HW)。
No comments yet.