消息堆积问题的解决措施,简而言之就是使用多线程,具体来说,可以采用三种方式:
- 每一个线程对应一个 KafkaConsumer,每一个 KafkaConsumer 对应 topic 中的一个 partition,这些 KafkaConsumer 隶属于同一个消费组,这样能保证同一条消息不被多个 Consumer 消费。好处就是可以不用处理偏移量和顺序控制,因为 partition 内部使按序的,缺点也很明显,就是该多线程的能力受限于分区数,如果需求是所有消息都必须按序,也就是说所有消息都在一个 partition 内,此时,该方法失效;
- 为了解决上述问题,也就是在只有一个分区的情况下,如何解决消息堆积。这个就必须通过手动控制offset了,通过 assign()、seek() 等方法解决。好处就是打破了原有的消费线程的个数受分区数的限制,坏处就是这种实现方式对于位移提交和顺序控制的处理会变得十分复杂,实际应用基本不会涉及。
- 上述两种方法都是从提高拉取消息的速率考虑的,但是在实际情况中,poll() 拉取消息的速度是相当快的,整体的消费性能瓶颈并不在于此,而是在于处理消息这一块。所以,我们可以在处理消息模块改成多线程的实现方式,但是这样同样会遇到一个问题,就是消息的顺序问题,因为多线程处理消息,原本 partition 的消息是按序拉取的,但是多线程处理完之后可能就不是按顺序的了,所以我们需要进一步进行处理,作者在该书中提出了滑动窗口的解决思路,即如果按序拉取后的正在处理的消息处理完成,将其放到窗口缓存,当全部完成之后窗口才向后滑动,类似于 TCP 中的 GBN 协议和 SR 协议。
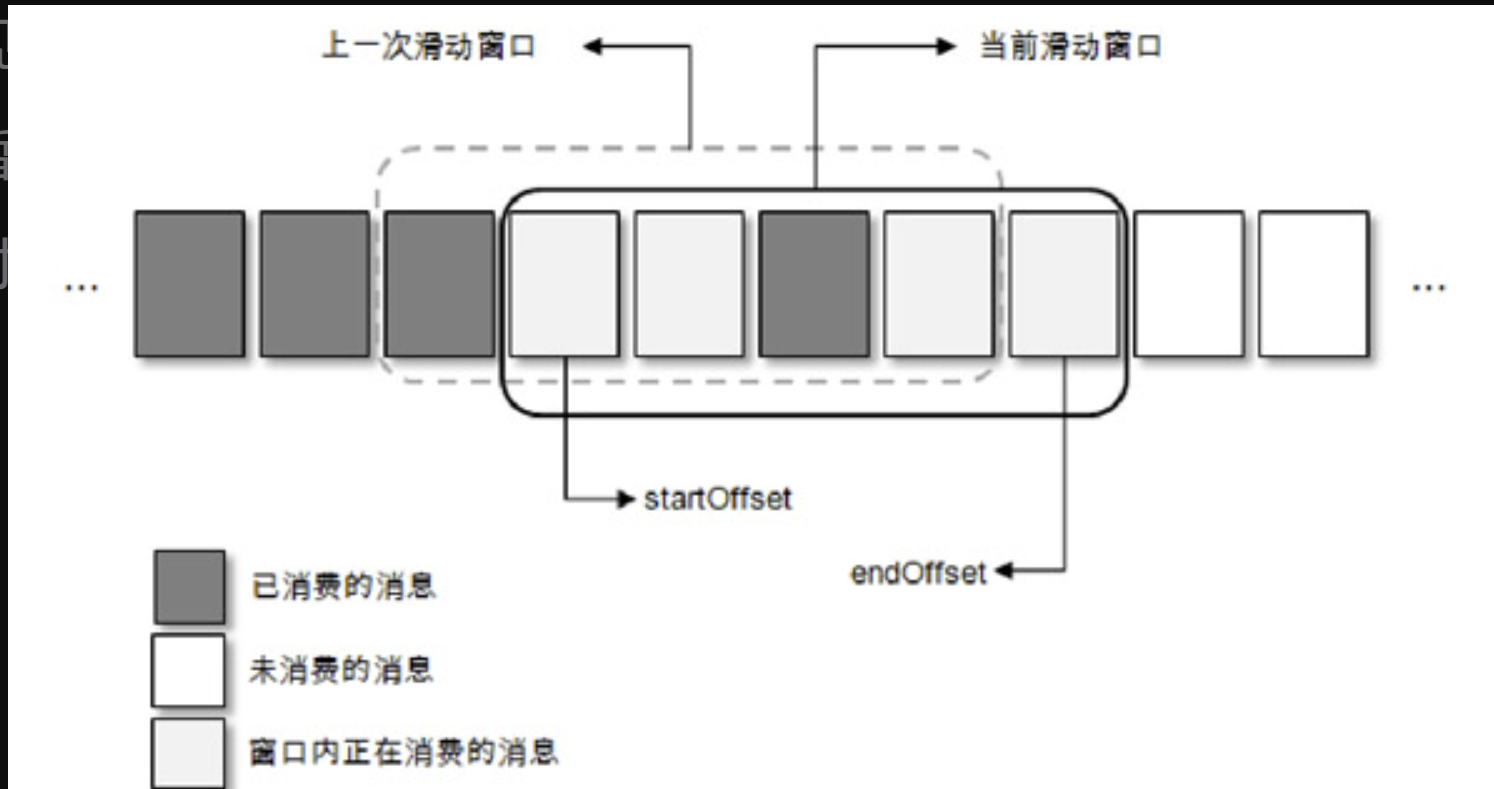
如果一个方格内的消息无法被标记为消费完成,那么就会造成 startOffset 的悬停。为了使窗口能够继续向前滑动,那么就需要设定一个阈值,当 startOffset 悬停一定的时间后就对这部分消息进行本地重试消费,如果重试失败就转入重试队列,如果还不奏效就转入死信队列,有关Kafka中重试队列和死信队列的实现可以参考11.3节。真实应用中无法消费的情况极少,一般是由业务代码的处理逻辑引起的,比如消息中的内容格式与业务处理的内容格式不符,无法对这条消息进行决断,这种情况可以通过优化代码逻辑或采取丢弃策略来避免。如果需要消息高度可靠,也可以将无法进行业务逻辑的消息(这类消息可以称为死信)存入磁盘、数据库或Kafka,然后继续消费下一条消息以保证整体消费进度合理推进,之后可以通过一个额外的处理任务来分析死信进而找出异常的原因
No comments yet.