目录
语音编码致力于:降低传输所需要的信道带宽,同时保持输入语音的高质量。
语音编码的目标在于:设计低复杂度的编码器以尽可能低的比特率实现高品质数据传输。
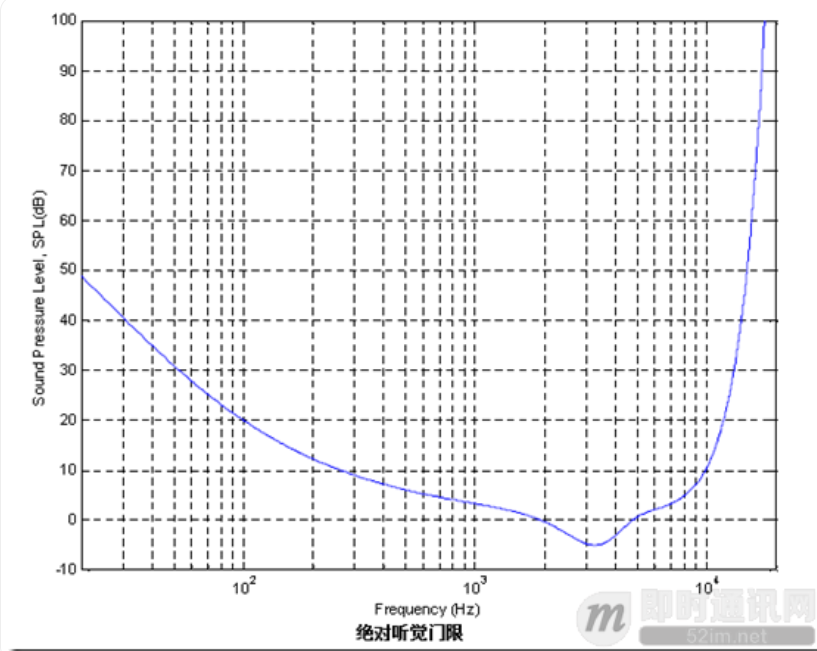
静音阈值曲线
指在安静环境下,人耳在各个频率能听到声音的阈值。
临界频带
由于人耳对不同频率的解析度不同,MPEG1/Audio将22khz内可感知的频率范围,依不同编码层,不同取样频率,划分成23~26个临界频带。下图列出理想临界频带的中心频率与频宽。图中可看到,人耳对低频的解析度较好。
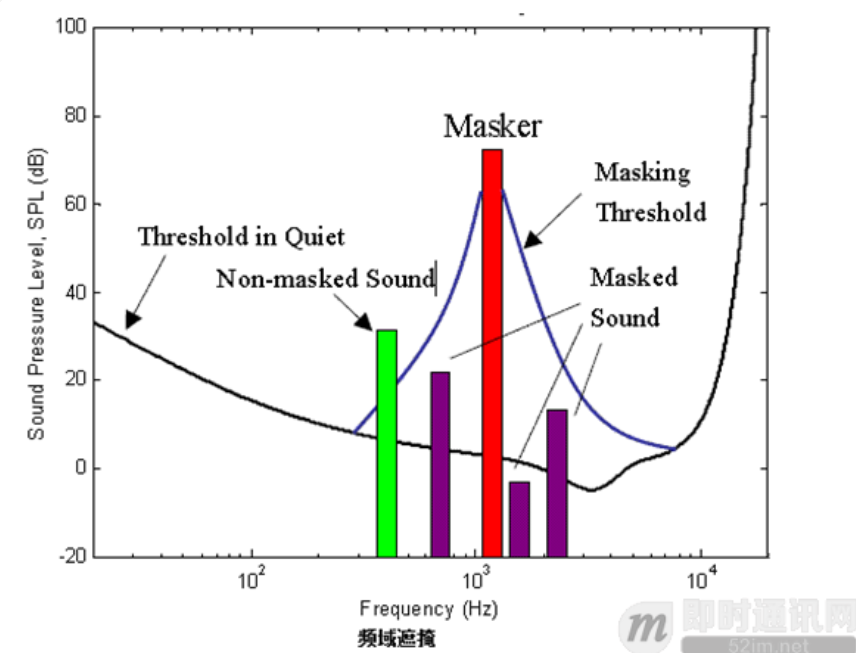
频域上的掩蔽效应
幅值较大的信号会掩蔽频率相近的幅值较小的信号,如下图:
时域上的遮蔽效应
在一个很短的时间内,若出现了2个声音,SPL(sound pressure level,声压级)较大的声音会掩蔽SPL较小的声音。时域掩蔽效应分前向掩蔽(pre-masking)和后向掩蔽(post-masking),其中post-masking的时间会比较长,约是pre-masking的10倍。
时域遮蔽效应有助于消除前回音。
更多请参考:
- 1)量化和量化器: 量化是把离散时间上的连续信号,转化成离散时间上的离散信号。
- 2)常见的量化器有: 均匀量化器,对数量化器,非均匀量化器。
- 3)量化过程追求的目标是: 最小化量化误差,并尽量减低量化器的复杂度(这2者本身就是一个矛盾)。
各个量化器的优缺点:
- channel vocoder: 利用人耳对相位的不敏感。
- homomorphic vocoder:能有效地处理合成信号。
- formant vocoder: 以用语音信号的绝大部分信息都位于共振峰的位置与带宽上。
- linear predictive vocoder:最常用的声码器。
- RELP: 在线性预测的基础上,对残差进行编码。机制为:只传输小部分残差,在接受端重构全部残差(把基带的残差进行拷贝)。
- MPC: multi-pulse coding,对残差去除相关性,用于弥补声码器将声音简单分为voiced和unvoiced,而没有中间状态的缺陷。
- CELP: codebook excited linear prediction,用声道预测其和基音预测器的级联,更好逼近原始信号。
- MBE: multiband excitation,多带激励,目的是避免CELP的大量运算,获得比声码器更高的质量。
语音编码器
语音编码器分为三种类形:(a)波形编器 、(b)声码器 、(c)混合编码器 。
波形编码器以构造出背景噪单在内的模拟波形为目标。作用于所有输入信号,因此会产生高质量的样值并且耗费较高的比特率。
声码器 (vocoder)不会再生原始波形。这组编码器 会提取一组参数 ,这组参数被送到接收端,用来导出语音产生模形。声码器语音质量不够好。
混合编码器,它融入了波形编码器和声器的长处。
波形编码器
波形编码器的设计常独立于信号。所以适应于各种信号的编码而不限于语音。
基于时域编码方法
PCM:pulse code modulation,是最简单的编码方式。仅仅是对信号的离散和量化,常采用对数量化。
DPCM:differential pulse code modulation,差分脉冲编码,只对样本之间的差异进行编码。前一个或多个样本用来预测当前样本值。用来做预测的样本越多,预测值越精确。真实值和预测值之间的差值叫残差,是编码的对象。
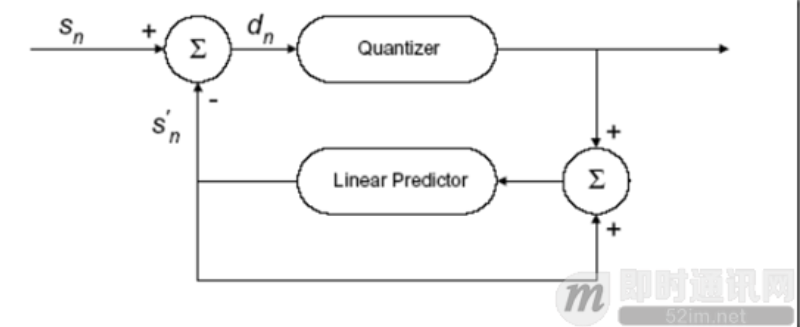
ADPCM:adaptive differential pulse code modulation,自适应差分脉冲编码。即在DPCM的基础上,根据信号的变化,适当调整量化器和预测器,使预测值更接近真实信号,残差更小,压缩效率更高。
基于频域编码方法
sub-band coding:子带编码是最简单的频域编码技术。是将原始信号由时间域转变为频率域,然后将其分割为若干个子频带,并对其分别进行数字编码的技术。它是利用带通滤波器(BPF)组把原始信号分割为若干(例如m个)子频带(简称子带)。将各子带通过等效于单边带调幅的调制特性,将各子带搬移到零频率附近,分别经过BPF(共m个)之后,再以规定的速率(奈奎斯特速率)对各子带输出信号进行取样,并对取样数值进行通常的数字编码,其设置m路数字编码器。将各路数字编码信号送到多路复用器,最后输出子带编码数据流。对不同的子带可以根据人耳感知模型,采用不同量化方式以及对子带分配不同的比特数。
transform coding:DCT编码。
声码器
混合编码器
波形编码器试图保留被编码信号的波形,能以中等比特率(32kbps)提供高品质语音,但无法应用在低比特率场合。声码器试图产生在听觉上与被编码信号相似的信号,能以低比特率提供可以理解的语音,但是所形成的语音听起来不自然。
混合编码器结合了2者的优点:
目前传统视频通讯过程中主要采用的是G.711、G.722、G.721、G.728等音频标准,音频宽度仅有50Hz-7KHz单声道,而人耳所能感知的自然界的频响能力可以达到20Hz-20KHz,因此,在对现场环境音的还原过程中过多的音频信息的丢失造成了无法真实表现现场情况。所以在高清晰视频通讯过程中我们势必要有一种相辅助的音频处理方式解决此问题。使整个高清晰通讯过程更去近于完美。
No comments yet.