目录
如何构建一个简单的文件系统?
磁盘上需要什么结构?
它们需要记录什么?
它们如何访问?
文件系统的数据结构(data structure)
访问方法
磁盘上的哪些结构存储文件系统的数据和元数据?
当一个进程打开一个文件时会发生什么?
在读取或写入期间访问哪些磁盘结构?
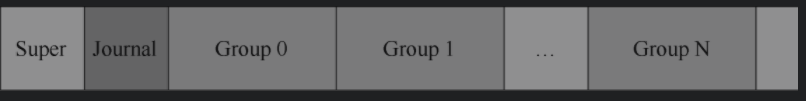
将磁盘分成块(block),一系列块,每块大小为4KB。在大小为N个4KB块的分区中,这些块的地址为从0到N−1。
2、有一个名为inode的结构:记录诸如文件包含哪些数据块(在数据区域中)、文件的大小,其所有者和访问权限、访问和修改时间以及其他类似信息的事情。
,每个位用于指示相应的对象/块是空闲(0)还是正在使用(1)
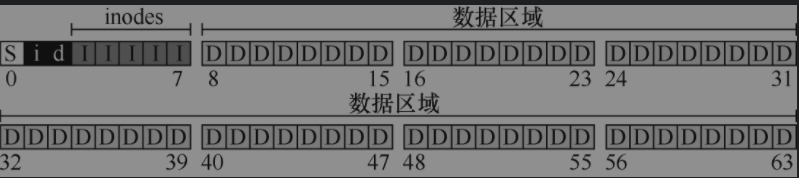
假设每个inode有256字节,一个4KB块可以容纳16个inode,而我们上面的文件系统则包含80个inode。
S块包含关于该特定文件系统的信息,包括例如文件系统中有多少个inode和数据块(在这个例子中分别为80和56)、inode表的开始位置(块3)等等。它可能还包括一些幻数,来标识文件系统类型(在本例中为VSFS)
2:inode
inode(index node)是许多文件系统中使用的通用名称,用于描述保存给定文件的元数据的结构,例如其长度、权限以及其组成块的位置。
在VSFS中给定一个inode,就能够直接计算出磁盘上相应节点位置。
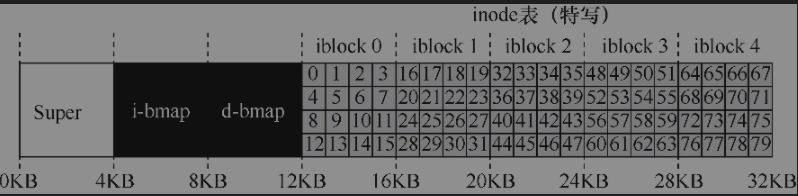
VSFS的inode表:大小为20KB(5个4KB块),因此由80个inode(假设每个inode为256字节)组成。进一步假设inode区域从12KB开始(即超级块从0KB开。
若想要读取inode为32,步骤如下
- 计算inode区域的offset:32 * sizeof(node) = 8192Byte = 8kb
- 再加上起始地址:inodeStartAddr = 12kb, 地址为20kb
- 磁盘是按照扇区来分区的,一个扇区512Byte,所以扇区号为:20kb / 512Byte = 40
伪代码如下:
blk = (inumber * sizeof(inode_t)) / blockSize;
sector = ((blk * blockSize) + inodeStartAddr) / sectorSize;
node_t的字段解释
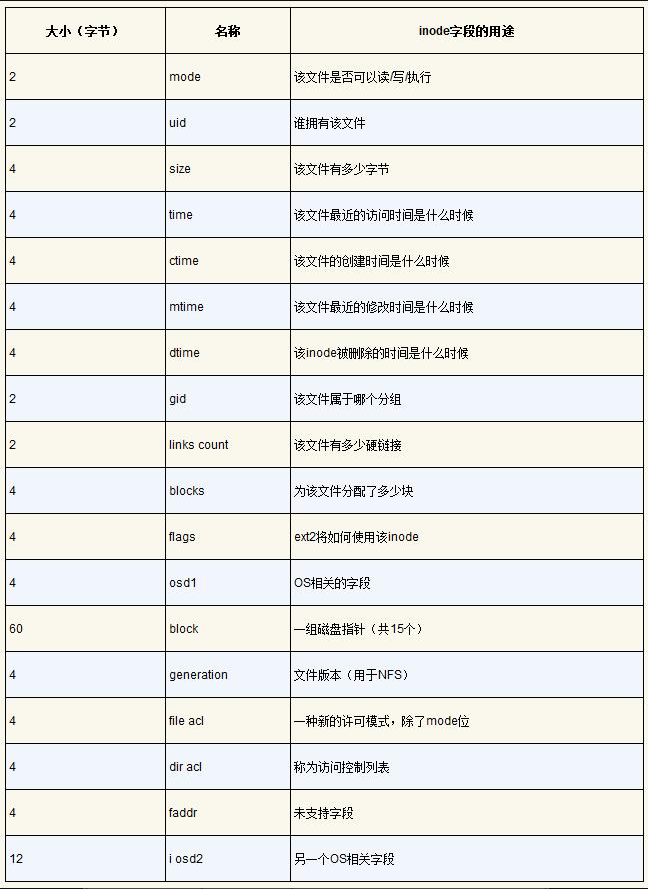
这里介绍的inode是单级索引,可以使用多级索引。只需添加另一个指向inode的指针:双重间接指针(double indirect pointer)。该指针指的是一个包含间接块指针的块,每个间接块都包含指向数据块的指针。
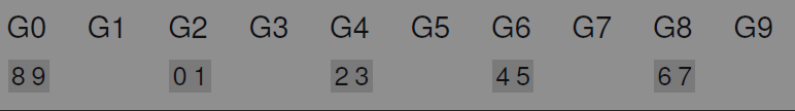
FFS将磁盘划分为一些分组,称为柱面组(cylindergroup),通过在同一组中放置两个文件,FFS可以确保先后访问两个文件不会导致穿越磁盘的长时间寻道。
每个组内部结构:
FS使用了一些简单的放置推断方法:找到分配数量少的柱面组,和大量的自由inode,并将目录数据和inode放在该分组中。
目录中的文件通常一起访问,确保了相关文件之间的寻道时间很短,FFS通常会提高性能。
1图是没有大文件,2图是有大文件。
4、崩溃一致性
文件系统数据结构必须持久(persist),即它们必须长期存在,存储在断电也能保留数据的设备上。
这里主要使用两种方法:
1、fsck,文件系统检查程序
2、日志记录(预写日志,每次写入增加一点开销,以便从崩溃中恢复)
日志记录法
这里主要记录一下日志记录的方法
主要为:
更新磁盘时,在覆写结构之前,首先写下一点小注记,描述你将要做的事情。写下这个注记就是“预写”部分,我们把它写入一个结构,并组织成“日志”。
增加日志后的文件结构:
将inode(I[v2])、位图(B[v2])和数据块(Db)写入磁盘。在将它们写入最终磁盘位置之前,现在先将它们写入日志。
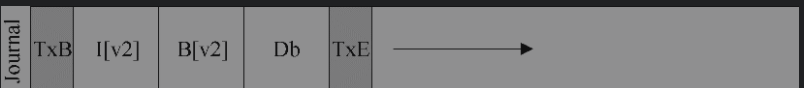
事务开始(TxB),中间的3个块只包含块本身的确切内容,这被称为物理日志(physical logging)。最后一个块(TxE)是该事务结束的标记,也会包含TID。
一旦这个事务安全地存在于磁盘上,我们就可以覆写文件系统中的旧结构了。这个过程称为加检查点(checkpointing)。
我们将I[v2]、B[v2]和Db写入其磁盘位置,如果这些写入成功完成,我们已成功地为文件系统加上了检查点,基本上完成了。
所以初始操作顺序如下:
1、日志写入:将事务(事务开始块,所有即将写入的数据和元数据更新以及事务结束块)写入日志,等待这些写入完成。
2、加检查点:将待处理的元数据和数据更新写入文件系统的最终位置。先写日志,再加入检查点,再写实际数据。
事务写入也有细节考量:
首先将除了TxE块之外的所有写入日志,同时发出这些写入请求。
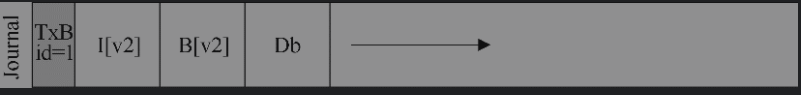
当写入完成后,文件系统会发出TxE块的写入,从而保证日志处于最终的安全状态。
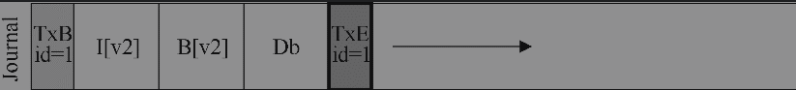
磁盘保证任何512字节写入都会发生或不发生(永远不会半写)。因此,为了确保TxE的写入是原子的,应该使它成为一个512字节的块。
现在细化一下更新文件系统的协议:
1、日志写入:将事务的内容(TxB、元数据和数据)写入日志,等待这些写入完成
2、日志提交:将事务提交块(包括TxE)写入日志,等待写完成,事务被认为已经提交
3、加检查点:将更新内容(元数据和数据)写入最终的磁盘位置
崩溃恢复
接下来讲解如何利用日志从崩溃中恢复。在这个更新序列期间,任何时候都可能发生崩溃。
- 2之前,日志提交前崩溃:简单地跳过待执行的更新
- 2~3之间:如果在事务已提交到日志之后但在加检查点完成之前发生崩溃:
- 将扫描日志,并查找已提交到磁盘的事务。
- 这些事务被重放,文件系统再次尝试将事务中的块写入它们最终的磁盘位置
- 称为重做日志(redo logging)
即使在某些更新写入块的最终位置之后,在加检查点期间的任何时刻发生崩溃,都没问题。
批处理日志更新
基本协议可能会增加大量额外的磁盘流量,一些文件系统不会一次一个地向磁盘提交每个更新。
可以将所有更新缓冲到全局事务中,当创建两个文件时,文件系统只将内存中的inode位图、文件的inode、目录数据和目录inode标记为脏,并将它们添加到块列表中,形成当前的事务。当最后应该将这些块写入磁盘时(例如,在超时5s之后),会提交包含上述所有更新的单个全局事务。因此,通过缓冲更新,文件系统在许多情况下可以避免对磁盘的过多的写入流量。
日志写满处理
日志文件系统将日志视为循环数据结构,一遍又一遍地重复使用。
为此,文件系统必须在加检查点之后的某个时间执行操作。一旦事务被加检查点,文件系统应释放它在日志中占用的空间,允许重用日志空间。
1.日志写入:将事务的内容(包括TxB和更新内容)写入日志,等待这些写入完成。
2.日志提交:将事务提交块(包括TxE)写入日志,等待写完成,事务被认为已提交(committed)。
3.加检查点:将更新内容写入其最终的磁盘位置。
4.释放:一段时间后,通过更新日志超级块,在日志中标记该事务为空闲。
元数据日志
对于每次写入磁盘,我们现在也要先写入日志,从而使写入流量加倍。由于将每个数据块写入磁盘的成本很高,人们为了提高性能,尝试了一些不同的东西。
上面描述的日志模式通常称为数据日志,日志本身记录了所有用户的数据。
而元数据日志和数据日志几乎相同,不过用户数据并不写入日志。 只写入日志头和位掩码。
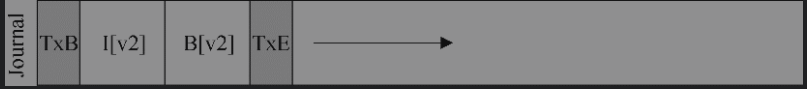
先前写入日志的数据块Db将改为写入文件系统,避免额外写入,不用两次写入数据会大大减少日志的I/O负载。
具体写入过程如下:(肯定先写入数据再写入掩码之类的,否则会出现写数据时崩溃,从而读取脏数据)
1、数据写入:将数据写入最终位置,等待完成
2、日志元数据写入:将TxB和元数据写入日志,等待完成
3、日志提交:将事务提交块(包括TxE)写入日志,等待写完成,现在认为事务(包括数据)已提交(committed)。
4、加检查点元数据:将元数据更新的内容写入文件系统中的最终位置。
5、释放:稍后,在日志超级块中将事务标记为空闲。
通过强制先写入数据,文件系统可以保证指针永远不会指向垃圾。实际上,这个“先写入被指对象,再写入指针对象”的规则是崩溃一致性的核心,并且被其他崩溃一致性方案[GP94]进一步利用。
在发出写入日志(步骤2)之前强制数据写入完成(步骤1)不是正确性所必需的,唯一真正的要求,是在发出日志提交块之前完成步骤1和步骤2(步骤3)。
Log-structured File System,日志结构文件系统。
顺序写入磁盘
简单地将所有更新(例如数据块、inode等)顺序写入磁盘的这一基本思想是LFS的核心。
必须向驱动器发出大量连续写入(或一次大写入)才能获得良好的写入性能。为了达到这个目的,LFS使用了一种称为写入缓冲[1](write buffering)的古老技术。在写入磁盘之前,LFS会跟踪内存中的更新。收到足够数量的更新时,会立即将它们写入磁盘。
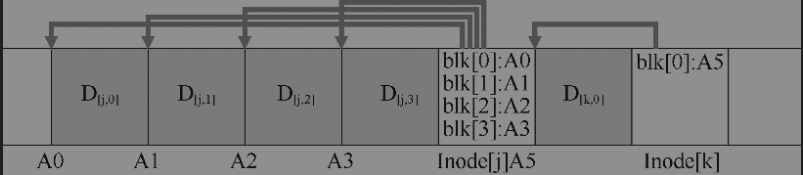
如图,inode此时的位置与前几个FS不同,具有很大的不规律性。所以LFS直接引入了inode map作为一个哈希表,key为inode号,value为inode的磁盘地址(4个字节的磁盘指针)
imap也需要持久化,由于它经常更新,LFS将inode映射的块放在它写入所有其他新信息的位置旁边,LFS实际上将新数据块,其inode和一段inode映射一起写入磁盘
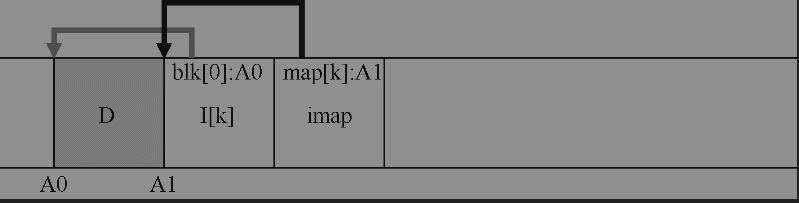
那么如何找到inode map呢,它也已经分散在整个磁盘上了。
LFS在磁盘上有块区域称为检查点区域,检查点区域包含指向最新的inode映射片段的指针
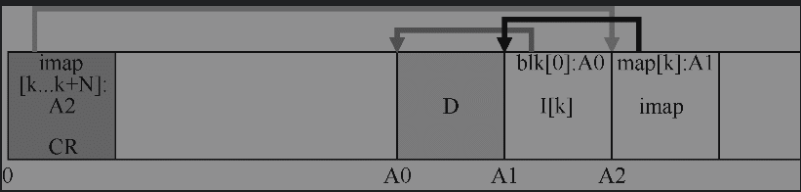
可以通过首先读取CR来找到inode映射片段。
因此,磁盘布局的整体结构包含一个检查点区域(指向内部映射的最新部分),每个inode映射块包含inode的地址,inode指向文件(和目录),就像典型的UNIX文件系统一样。、
检查点区域仅定期更新(例如每30s左右)
假设从内存中没有任何东西开始。
2、当给定文件的inode号,从现有的imap查找映射,读入最新版本的inode
崩溃恢复和日志
在正常操作期间,LFS将一些写入缓冲在段中,然后(当段已满或经过一段时间后),将段写入磁盘。LFS在日志(log)中组织这些写入,即指向头部段和尾部段的检查点区域,并且每个段指向要写入的下一个段。LFS还定期更新检查点区域(CR)。在这些操作期间都可能发生崩溃(写入段,写入CR)。那么LFS在写入这些结构时如何处理崩溃?
LFS实际上保留了两个CR,每个位于磁盘的一端,并交替写入它们。当使用最新的指向inode映射和其他信息的指针更新CR时,LFS还实现了一个谨慎的协议。具体来说,它首先写出一个头(带有时间戳),然后写出CR的主体,然后最后写出最后一部分(也带有时间戳)。如果系统在CR更新期间崩溃,LFS可以通过查看一对不一致的时间戳来检测到这一点。LFS将始终选择使用具有一致时间戳的最新CR,从而实现CR的一致更新。
No comments yet.