目录
模板
请解决以下问题,并详细解释每一步的过程,并根据模板测试代码给出相似的测试样例

问题描述:c++代码中有哪些针对循环优化的方法
问题解决的步骤
1.给出优化的背景和相关概念
2.给出优化方向以及每个方向上的benchmark代码
3.思考要有一定的深度
测试demo
// 原始循环函数
void originalLoop(std::vector
for (int i = 0; i < array.size(); ++i) {
array[i] = array[i] * 2;
}
}
// 展开后的循环函数
void unrolledLoop(std::vector
int n = array.size();
int i = 0;
// 展开循环
for (; i <= n - 4; i += 4) {
    array[i] = array[i] * 2;
    array[i + 1] = array[i + 1] * 2;
    array[i + 2] = array[i + 2] * 2;
    array[i + 3] = array[i + 3] * 2;
}

// 处理剩余的元素
for (; i < n; ++i) {
    array[i] = array[i] * 2;
}
}
static void test1(benchmark::State& state) {
const int arraySize = 1000000; // 数组大小
std::vector
// Code inside this loop is measured repeatedly
for (auto _ : state) {
originalLoop(array);
}
}
// Register the function as a benchmark
BENCHMARK(test1);
static void test2(benchmark::State& state) {
const int arraySize = 1000000; // 数组大小
std::vector
// Code before the loop is not measured
for (auto _ : state) {
unrolledLoop(array);
}
}
BENCHMARK(test2);
C++ 代码中的循环优化方法
在 C++ 中进行循环优化是一种常见的性能优化技术,通过减少循环控制开销、提高内存访问效率、增加指令级并行性等方式来提升程序的运行速度。常见的循环优化方法包括
循环优化的背景和相关概念:
- 循环优化:是指通过各种技术和方法来提高循环的执行效率。这包括减少循环的计算量、优化数据访问、减少不必要的操作等。
- 性能瓶颈:循环中的性能瓶颈通常包括:迭代次数过多、复杂的循环条件、频繁的内存访问、数据依赖等。
- 循环展开(Loop Unrolling):通过将循环体内的操作次数减少到更少的迭代次数,以减少循环控制开销。
- 循环外提(Loop Invariant Code Motion):将循环中不变的计算移到循环外部
- 循环合并(Loop Fusion):将多个循环合并为一个循环,减少循环的数量
- 循环分裂(Loop Splitting):将复杂的循环分裂为多个简单的循环,优化每个子循环
- 数据预取(Data Prefetching):提前加载数据到缓存中,减少内存访问延迟。
- 多线程并行:通过并行化循环来利用多核处理器的计算能力。
具体操作
优化验证:
https://quick-bench.com/q/1rO0t_gX0h5r1dyOmx0mWMz4P_c
1. 循环展开验证
核心优化代码
循环展开:将简单的循环展开成更少的迭代。例如,将以下循环:
for (int i = 0; i < 100; ++i) {
    array[i] = array[i] * 2;
}
for (int i = 0; i < 100; i += 4) {
    array[i] = array[i] * 2;
    array[i + 1] = array[i + 1] * 2;
    array[i + 2] = array[i + 2] * 2;
    array[i + 3] = array[i + 3] * 2;
}
完整测试验证代码
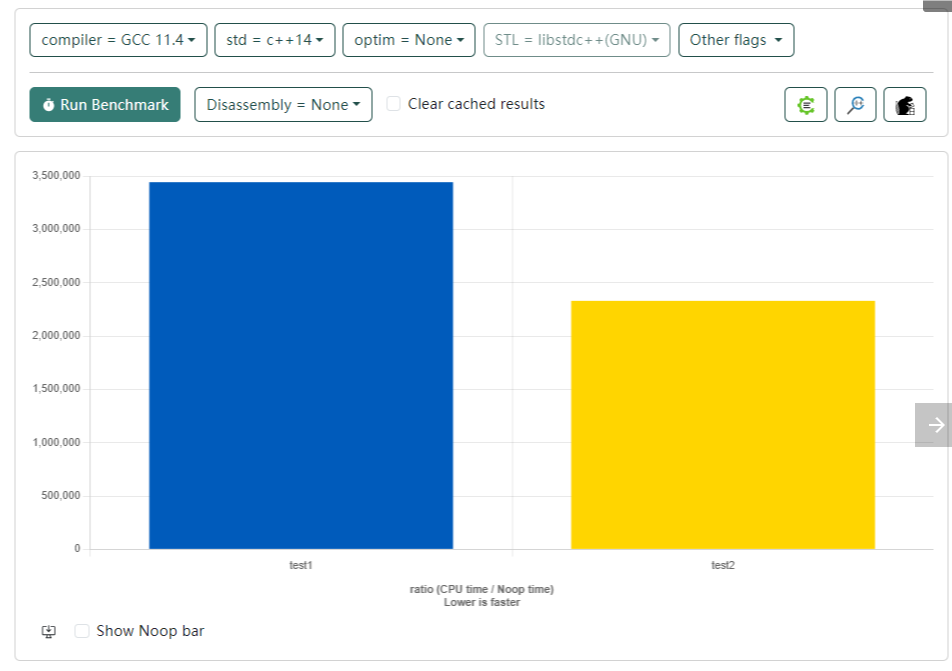
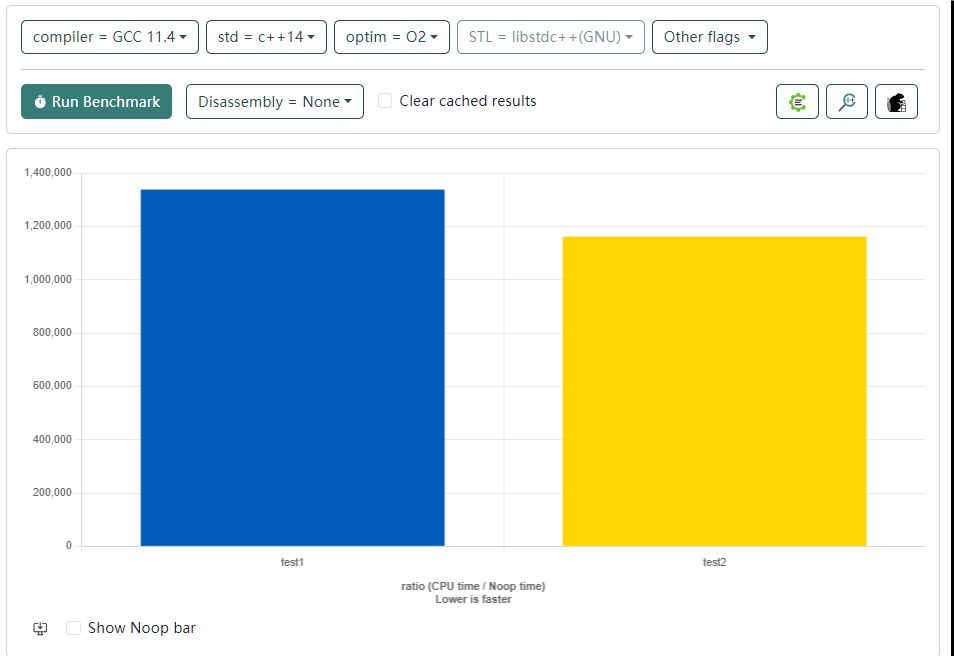
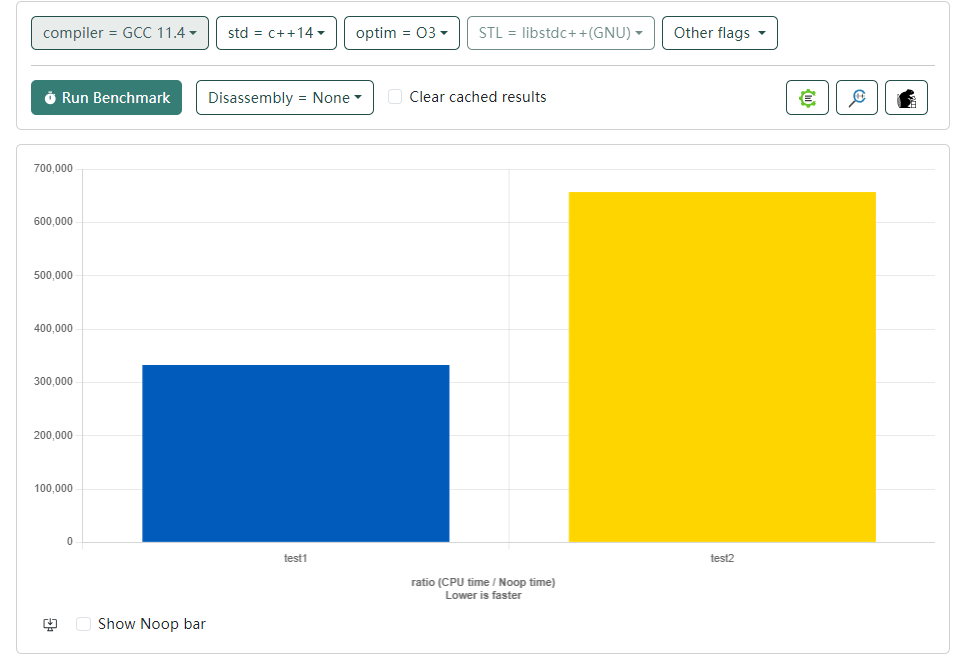
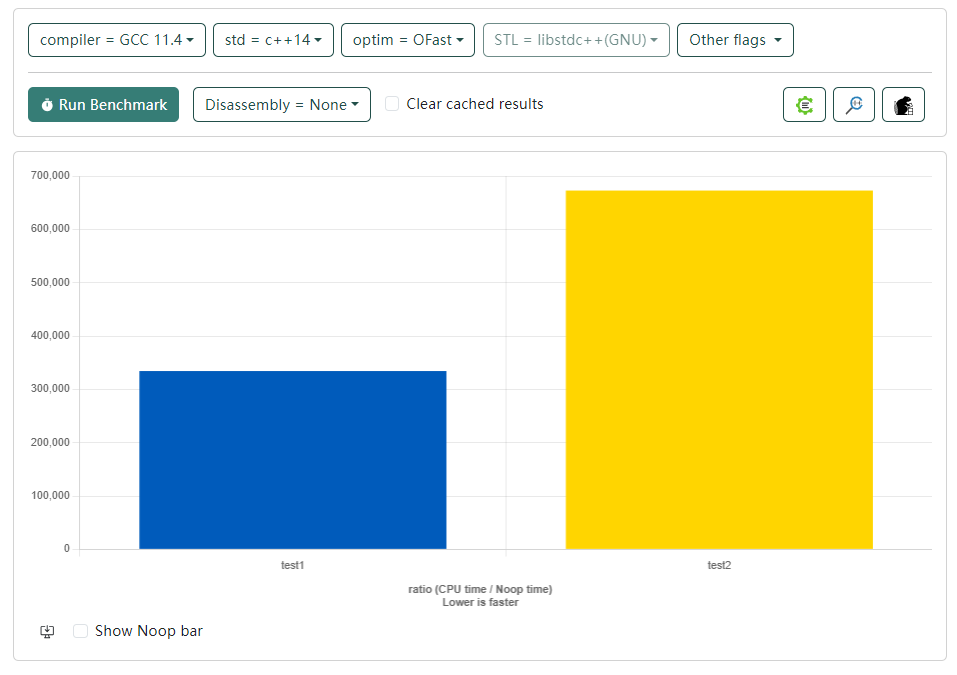
测试结果
测试结果,验证一下不开优化、O2、O3、OFast等级下的优化效果
蓝色:原始函数 耗时
黄色:加上优化策略函数 耗时
2. 循环外提验证
// 原始循环函数 void originalLoop() { int sum = 0; int n = 1000000; for (int i = 0; i < n; i++) { int temp = 5 * 5; // 循环不变 sum += temp; } return; } // 简化函数 void inVariantLoop() { int sum = 0; int temp = 5 * 5; // 移出循环 int n = 1000000; for (int i = 0; i < n; i++) { sum += temp; } return; }3. 循环合并验证
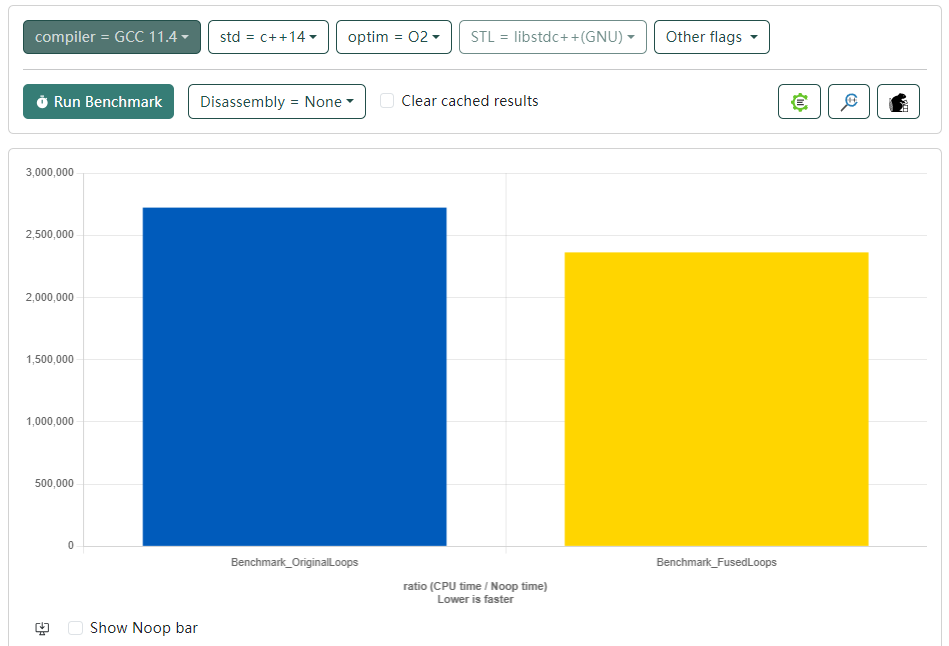
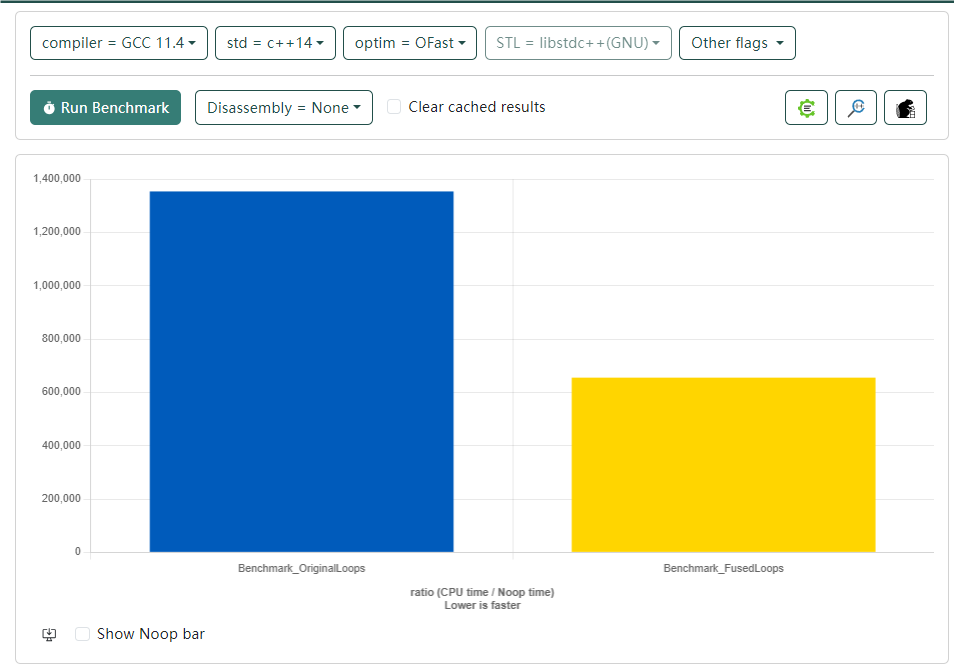
循环合并是将多个遍历同一数据结构的循环合并成一个循环,以减少循环控制和内存访问的开销。
核心优化代码
完整测试验证代码
#include <benchmark/benchmark.h> #include <vector> // 原始循环函数 void originalLoops(std::vector<int>& array1, std::vector<int>& array2) { for (int i = 0; i < array1.size(); ++i) { array1[i] = array1[i] * 2; } for (int i = 0; i < array2.size(); ++i) { array2[i] = array2[i] + 1; } } // 合并后的循环函数 void fusedLoops(std::vector<int>& array1, std::vector<int>& array2) { for (int i = 0; i < array1.size(); ++i) { array1[i] = array1[i] * 2; array2[i] = array2[i] + 1; } } static void Benchmark_OriginalLoops(benchmark::State& state) { const int arraySize = 1000000; std::vector<int> array1(arraySize, 1); std::vector<int> array2(arraySize, 1); for (auto _ : state) { originalLoops(array1, array2); } } BENCHMARK(Benchmark_OriginalLoops); static void Benchmark_FusedLoops(benchmark::State& state) { const int arraySize = 1000000; std::vector<int> array1(arraySize, 1); std::vector<int> array2(arraySize, 1); for (auto _ : state) { fusedLoops(array1, array2); } } BENCHMARK(Benchmark_FusedLoops);测试结果,验证一下不开优化、O2、O3、OFast等级下的优化效果
黄色:加上优化策略函数 耗时
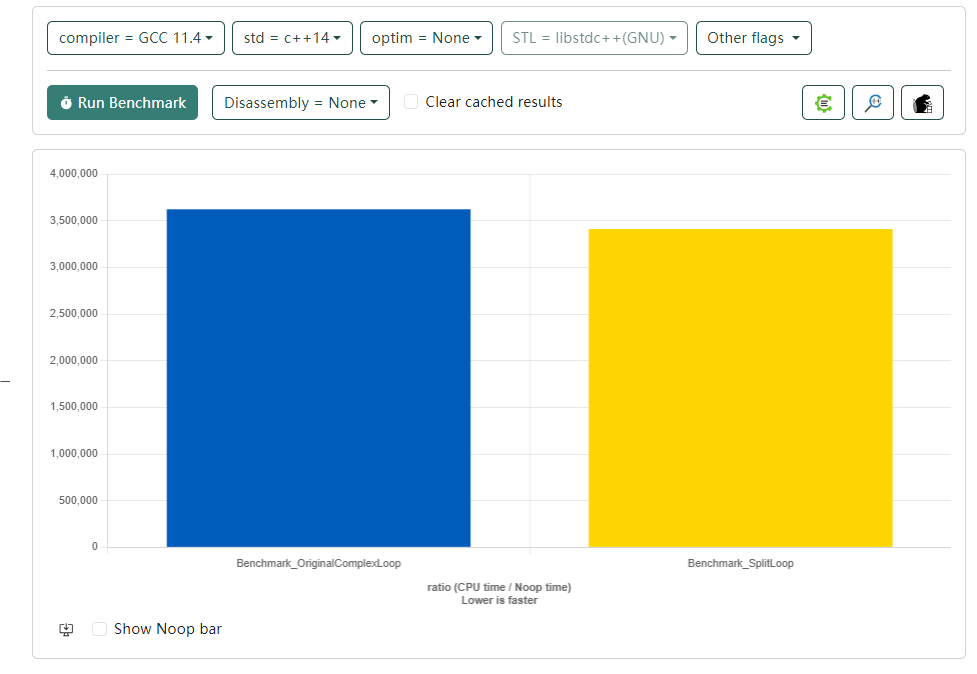
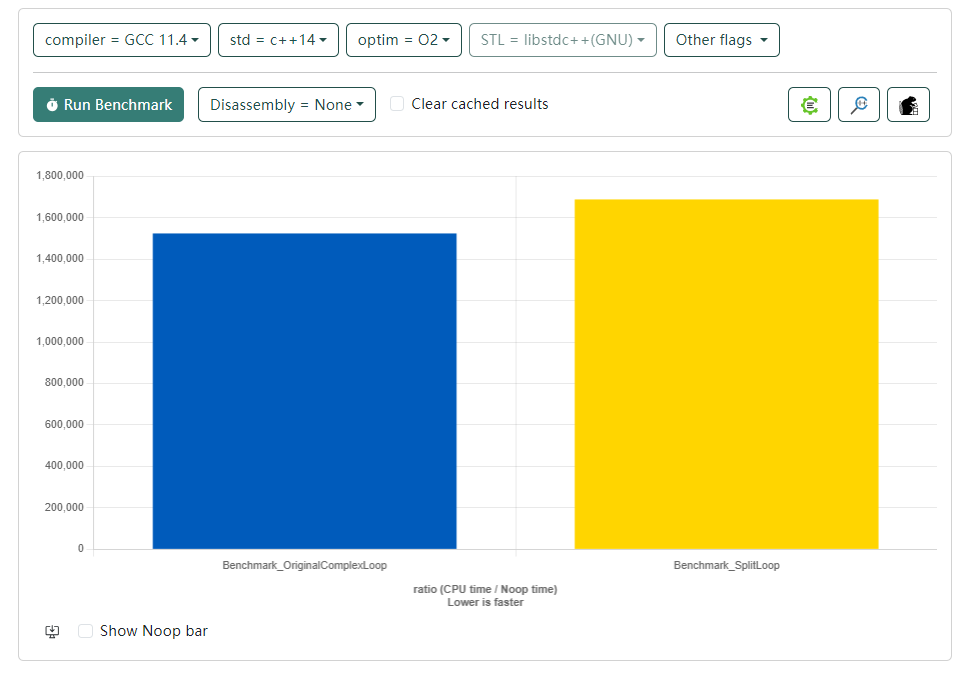
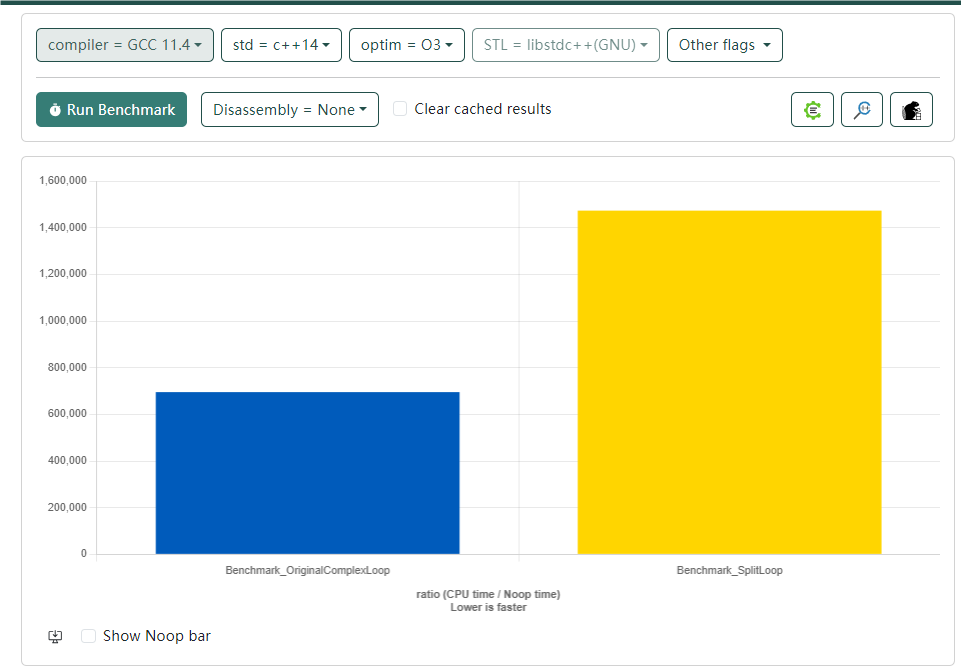
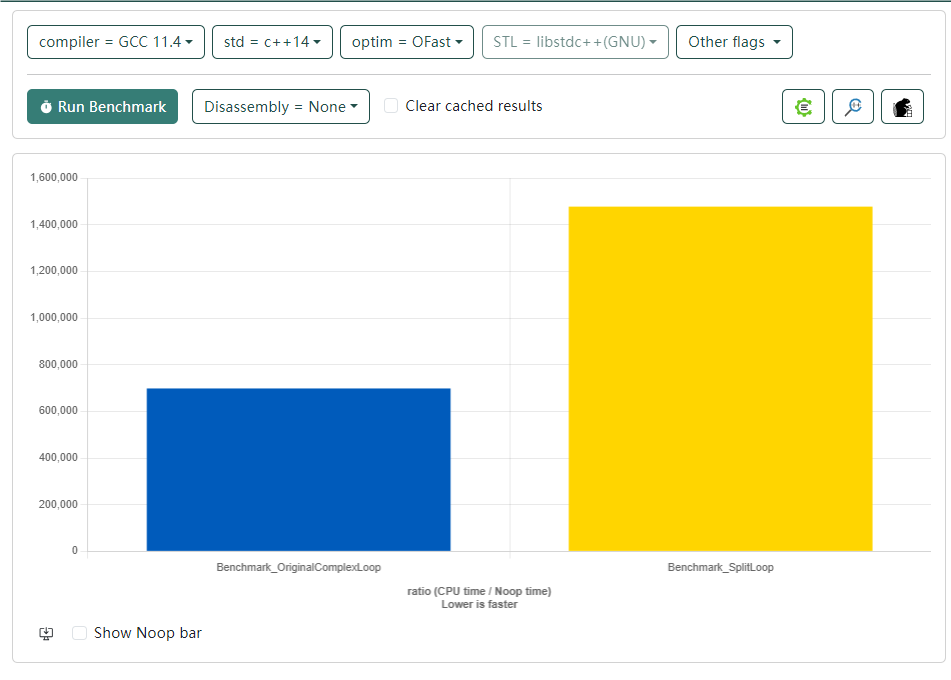
4. 循环分裂提验证(存在负优化)
核心优化代码
#include <benchmark/benchmark.h> #include <vector> // 原始循环函数 void originalComplexLoop(std::vector<int>& array) { for (int i = 0; i < array.size(); ++i) { if (i % 2 == 0) { array[i] = array[i] * 2; } else { array[i] = array[i] + 1; } } } // 分裂后的循环函数 void splitLoop(std::vector<int>& array) { for (int i = 0; i < array.size(); i += 2) { array[i] = array[i] * 2; } for (int i = 1; i < array.size(); i += 2) { array[i] = array[i] + 1; } } static void Benchmark_OriginalComplexLoop(benchmark::State& state) { const int arraySize = 1000000; std::vector<int> array(arraySize, 1); for (auto _ : state) { originalComplexLoop(array); } } BENCHMARK(Benchmark_OriginalComplexLoop); static void Benchmark_SplitLoop(benchmark::State& state) { const int arraySize = 1000000; std::vector<int> array(arraySize, 1); for (auto _ : state) { splitLoop(array); } } BENCHMARK(Benchmark_SplitLoop);测试结果
测试结果,验证一下不开优化、O2、O3、OFast等级下的优化效果
蓝色:原始函数 耗时
黄色:加上优化策略函数 耗时
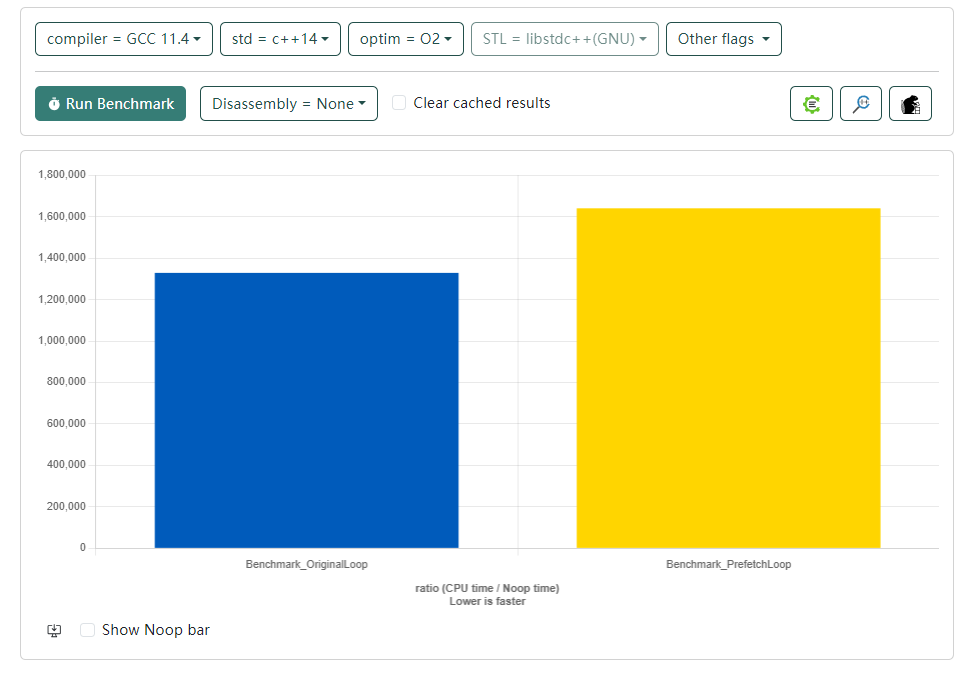
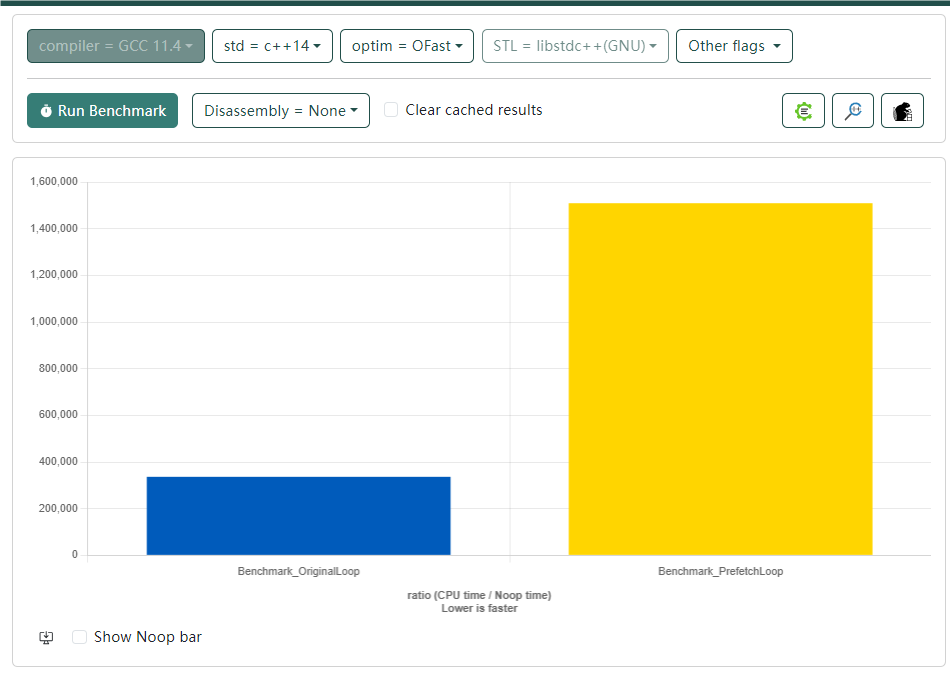
5. 数据预取验证(存在负优化)
数据预取是提前加载将要访问的数据到缓存中,以减少内存访问延迟
核心优化代码
完整测试验证代码
#include <benchmark/benchmark.h> #include <vector> // 原始循环函数 void originalLoop(std::vector<int>& array) { for (int i = 0; i < array.size(); ++i) { array[i] = array[i] * 2; } } // 预取后的循环函数 void prefetchLoop(std::vector<int>& array) { for (int i = 0; i < array.size(); ++i) { __builtin_prefetch(&array[i + 16], 0, 1); // 预取后面的数据 array[i] = array[i] * 2; } } static void Benchmark_OriginalLoop(benchmark::State& state) { const int arraySize = 1000000; std::vector<int> array(arraySize, 1); for (auto _ : state) { originalLoop(array); } } BENCHMARK(Benchmark_OriginalLoop); static void Benchmark_PrefetchLoop(benchmark::State& state) { const int arraySize = 1000000; std::vector<int> array(arraySize, 1); for (auto _ : state) { prefetchLoop(array); } } BENCHMARK(Benchmark_PrefetchLoop); BENCHMARK_MAIN();测试结果,验证一下不开优化、O2、O3、OFast等级下的优化效果
黄色:加上优化策略函数 耗时
6. 并行化验证
核心优化代码
// 原始循环函数 void originalLoop(std::vector<int>& array) { for (int i = 0; i < array.size(); ++i) { array[i] = array[i] * 2; } } // 使用OpenMP并行化的循环函数 void parallelLoop(std::vector<int>& array) { #pragma omp parallel for for (int i = 0; i < array.size(); ++i) { array[i] = array[i] * 2; } }测试结果
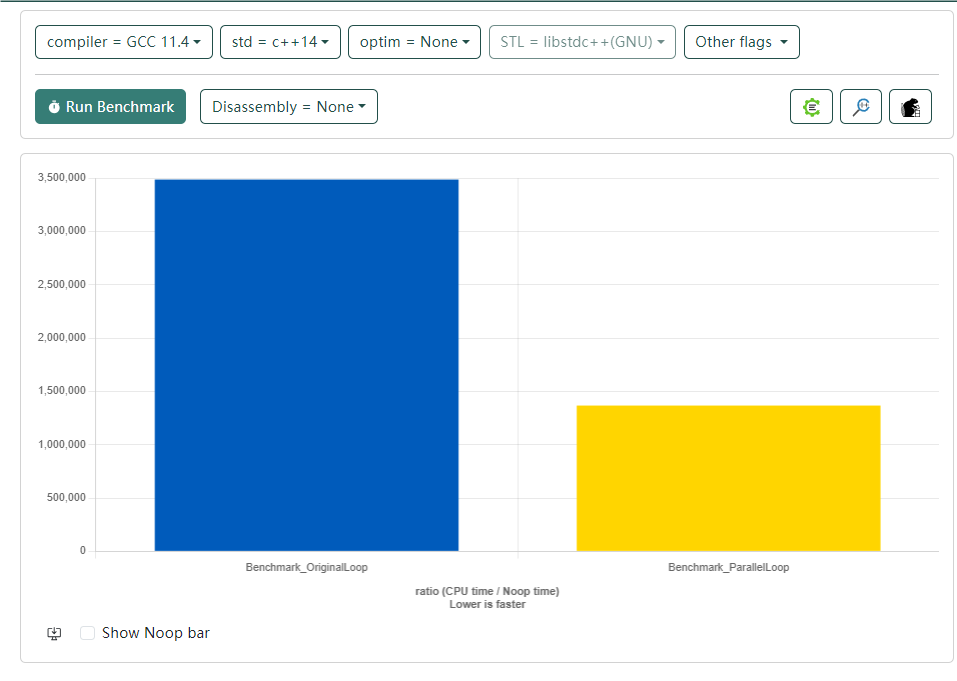
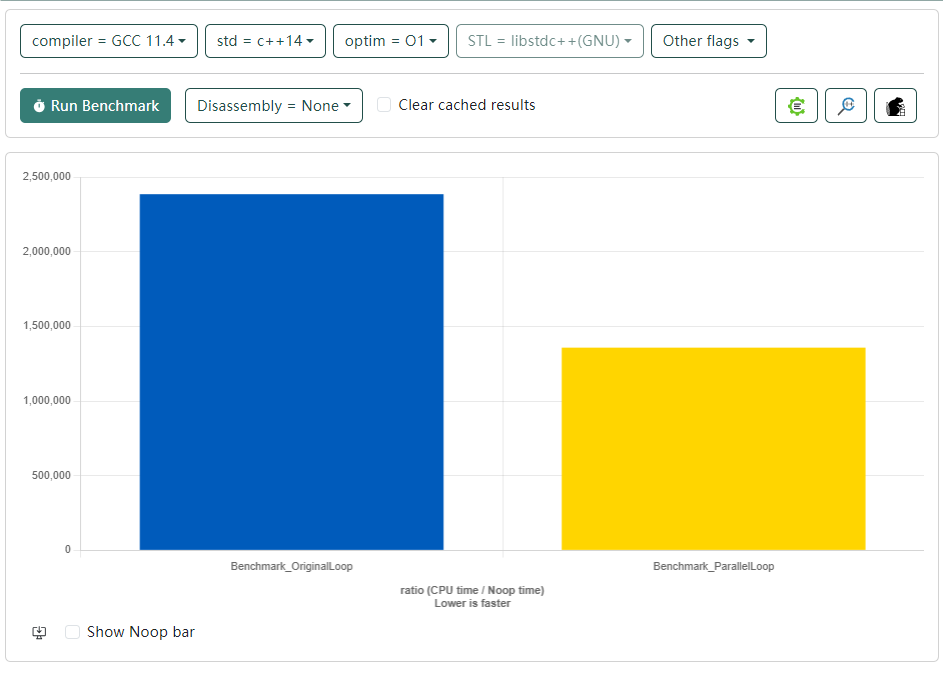
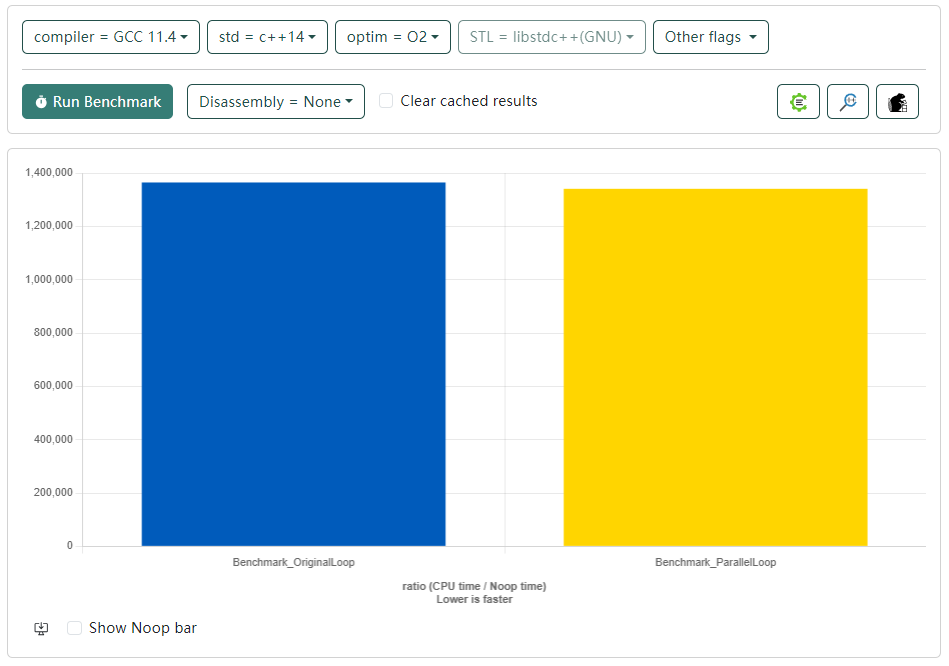
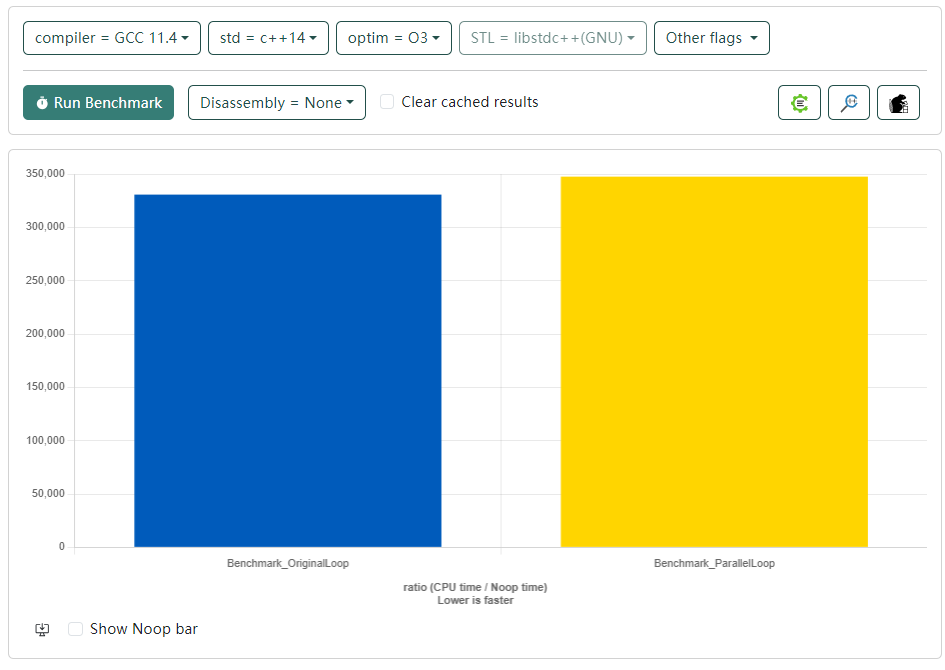
Note: 使用简单数组优化
这里我们不使用vector,而是使用简单的c类型数组,发现在不开优化的情况下,使用简单数组更加快
#include <benchmark/benchmark.h> #include <vector> #include <omp.h> // 原始循环函数 void originalLoop(std::vector<int>& array) { for (int i = 0; i < array.size(); ++i) { array[i] = array[i] * 2; } } // 简化数据结构 void SimpleLoop(int* array, size_t size) { for (int i = 0; i < static_cast<int>(size); ++i) { array[i] = array[i] * 2; } } // 测试原始循环 static void Benchmark_OriginalLoop(benchmark::State& state) { const int arraySize = 1000000; // 数组大小 std::vector<int> array(arraySize, 1); // 初始化数组 for (auto _ : state) { originalLoop(array); } } BENCHMARK(Benchmark_OriginalLoop); // 测试循环 static void Benchmark_ParallelLoop(benchmark::State& state) { const int arraySize = 1000000; // 数组大小 int* array = new int[arraySize]; for (int i = 0; i < arraySize; ++i) { array[i] = 1; } for (auto _ : state) { SimpleLoop(array, arraySize); } } BENCHMARK(Benchmark_ParallelLoop);测试结果,验证一下不开优化、O1、O2、O3等级下的优化效果
蓝色:原始函数 耗时
黄色:加上优化策略函数 耗时
在使用
__builtin_prefetch进行预取时,确实需要仔细调整参数以确保优化效果。__builtin_prefetch函数的原型如下:void __builtin_prefetch(const void *addr, int rw, int locality);
addr是预取地址。rw表示预取数据是用于读还是写。0 表示只读,1 表示写入。locality表示数据的局部性。0 表示无局部性,1 表示低局部性,2 表示高局部性,3 表示最高局部性。
你的代码中已经正确地设置了 rw 参数为 1,表示预取的数据将被写入。然而,可能存在的问题包括:
- 预取距离:预取的地址可能太近,导致预取效果不明显。
- 局部性:局部性参数可能设置得不够合理。
以下是一些调整建议:
1. 调整预取距离
预取距离过近或过远都可能影响性能。你可以尝试调整预取的地址,例如:
__builtin_prefetch(&array[i + 8], 0, 1);
这里将预取距离从 16 调整为 8。
2. 调整局部性参数
局部性参数可以影响预取的优先级和缓存行为。你可以尝试不同的局部性参数,例如:
__builtin_prefetch(&array[i + 16], 0, 3); // 最高局部性
3. 考虑数据访问模式
确保你的预取逻辑与数据的实际访问模式相匹配。例如,如果你的数据访问模式是随机的,预取可能不会带来太大帮助。
4. 考虑循环展开
如果循环迭代次数较多,可以考虑循环展开来减少循环开销:
void prefetchLoop(std::vector<int>& array) {
    const int blockSize = 8; // 可以根据实际情况调整
    for (int i = 0; i < array.size(); i += blockSize) {
        for (int j = 0; j < blockSize && i + j < array.size(); ++j) {
            __builtin_prefetch(&array[i + j + blockSize], 0, 1);
            array[i + j] = array[i + j] * 2;
        }
    }
}
5. 考虑硬件特性
不同的硬件可能对预取有不同的优化效果。了解你的硬件特性,例如缓存大小和缓存行大小,可以帮助你更好地调整预取策略。
6. 性能测试
最后,进行实际的性能测试是验证优化效果的关键。使用性能分析工具(如 gprof 或 VTune)来测量优化前后的性能差异,并根据测试结果调整预取策略。
通过这些调整,你可以更好地利用 __builtin_prefetch 来优化你的代码。
No comments yet.