目录
一个标准的方法来创建一个并发数据结构:添加一把大锁。
typedef struct counter_t {
    int value;
    pthread_mutex_t lock;
} counter_t;

void init(counter_t *c) {
    c->value = 0;
    Pthread_mutex_init(&c->lock, NULL);
}

void increment(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    c->value++;
    Pthread_mutex_unlock(&c->lock);
}

void decrement(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    c->value--;
    Pthread_mutex_unlock(&c->lock);
}

int get(counter_t *c) {
    Pthread_mutex_lock(&c->lock);
    int rc = c->value;
    Pthread_mutex_unlock(&c->lock);
    return rc;
}
typedef struct counter_t {
int value;
pthread_mutex_t lock;
} counter_t;
void init(counter_t *c) {
c->value = 0;
Pthread_mutex_init(&c->lock, NULL);
}
void increment(counter_t *c) {
Pthread_mutex_lock(&c->lock);
c->value++;
Pthread_mutex_unlock(&c->lock);
}
void decrement(counter_t *c) {
Pthread_mutex_lock(&c->lock);
c->value--;
Pthread_mutex_unlock(&c->lock);
}
int get(counter_t *c) {
Pthread_mutex_lock(&c->lock);
int rc = c->value;
Pthread_mutex_unlock(&c->lock);
return rc;
}
它只是加了一把锁,在调用函数操作该数据结构时获取锁,从调用返回时释放锁。
同步的计数器扩展性不好。单线程完成100万次更新只需要很短的时间(大约0.03s),而两个线程并发执行,每个更新100万次,性能下降很多(超过5s!)。线程更多时,性能更差。
理想情况下,你会看到多处理上运行的多线程就像单线程一样快。达到这种状态称为完美扩展(perfect scaling)。
2、懒惰计数器
懒惰计数器的基本思想是这样的。如果一个核心上的线程想增加计数器,那就增加它的局部计数器,访问这个局部计数器是通过对应的局部锁同步的。因为每个CPU有自己的局部计数器,不同CPU上的线程不会竞争,所以计数器的更新操作可扩展性好。
懒惰计数器通过多个局部计数器和一个全局计数器来实现一个逻辑计数器,其中每个CPU核心有一个局部计数器。具体来说,在4个CPU的机器上,有4个局部计数器和1个全局计数器。除了这些计数器,还有锁:每个局部计数器有一个锁,全局计数器有一个。
但是,为了保持全局计数器更新(以防某个线程要读取该值),局部值会定期转移给全局计数器,方法是获取全局锁,让全局计数器加上局部计数器的值,然后将局部计数器置零。
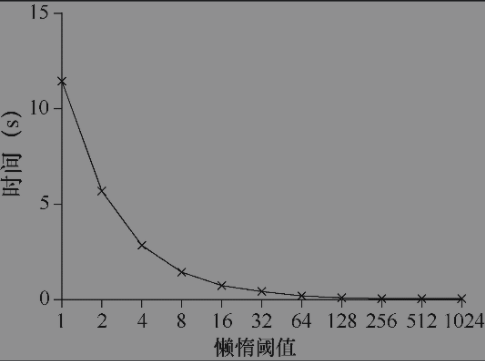
这种局部转全局的频度,取决于一个阈值,这里称为S(表示sloppiness)。S越小,懒惰计数器则越趋近于非扩展的计数器。S越大,扩展性越强,但是全局计数器与实际计数的偏差越大。
在4个CPU上的4个线程,分别增加计数器100万次。如果S小,性能很差(但是全局计数器精确度高)。如果S大,性能很好,但是全局计数器会有延时。懒惰计数器就是在准确性和性能之间折中。
3、并发链表
typedef struct node_t { int key; struct node_t* next; } node_t; typedef struct list_t { node_t* head; pthread_mutex_t lock; } list_t; void init(list_t* list) { list->head = NULL; Pthread_mutex_init(&list->lock, NULL); } void insert(list_t *list, int key) { node_t* p = malloc(sizeof(node_t)); if (p == NULL) { perror("malloc"); return -1; } p->key = key; // 假定malloc()是线程安全的,每个线程都可以调用它,不需要担心竞争条件和其他并发缺陷。 // 只有在更新共享列表时需要持有锁 Pthread_mutex_lock(&list->lock); p->next = list->head; // 头插法 list->head = p; Pthread_mutex_unlock(&list->lock); return 0; } void find(list_t *list, int key) { int ret = -1; Pthread_mutex_lock(&list->lock); node_t* cur = list->head; while (cur) { if (cur->key == key) { ret = 0; break; } cur = cur->next; } Pthread_mutex_unlock(&list->lock); return ret; }扩展,上面的代码demo是一个链表一个锁,这样性能不大行。介绍一个过手锁(hand-over-hand locking,也叫作锁耦合,lock coupling)
原理也很简单。每个节点都有一个锁,替代之前整个链表一个锁。遍历链表的时候,首先抢占下一个节点的锁,然后释放当前节点的锁。
增加了链表操作的并发程度。但是实际上,在遍历的时候,每个节点获取锁、释放锁的开销巨大,很难比单锁的方法快。即使有大量的线程和很大的链表,这种并发的方案也不一定会比单锁的方案快。也许某种杂合的方案(一定数量的节点用一个锁)值得去研究。
typedef struct node_t { int value; struct node_t* next; } node_t; typedef struct queue_t { node_t* head; node_t* tail; pthread_mutex_t headLock; pthread_mutex_t tailLock; } queue_t; void init(queue_t* q) { node_t* tmp = malloc(sizeof(node_t)); tmp->next = NULL; q->head = q->tail = tmp; Pthread_mutex_init(&q->headLock, NULL); Pthread_mutex_init(&q->tailLock, NULL); } void enqueue(queue_t *q, int value) { node_t* tmp = malloc(sizeof(node_t)); assert(tmp != NULL); tmp->value = value; tmp->next = NULL; // 队尾入队 Pthread_mutex_lock(&q->tailLock); q->tail->next = tmp; q->tail = tmp; Pthread_mutex_unlock(&q->tailLock); } int dequeue(queue_t *q, int* value) { Pthread_mutex_lock(&q->headLock); node_t* tmp = q->head; node_t* newHead = q->next; if (newHead == NULL) { Pthread_mutex_unlock(&q->headLock); return -1; // queue was empty } *value = newHead->value; q->head = newHead; Pthread_mutex_unlock(&q->headLock); free(tmp); return 0; }有两个锁,一个负责队列头,另一个负责队列尾。这两个锁使得入队列操作和出队列操作可以并发执行,因为入队列只访问tail锁,而出队列只访问head锁。
使用了一个技巧,添加了一个假节点(在队列初始化的代码里分配的)。该假节点分开了头和尾操作。
5、并发散列表
基于3的并发链表
每个散列桶(每个桶都是一个链表)都有一个锁,而不是整个散列表只有一个锁,从而支持许多并发操作。
总结
关于并发队列的更多内容,查看:
No comments yet.