目录
参考文档:
https://blog.csdn.net/qq_42596142/article/details/103157468
Numba是一个开源的即时编译器,它可以将Python和NumPy代码转换成快速运行的机器码。Numba的主要作用是显著提高Python程序的执行速度,特别是在进行数值计算和数据处理时。以下是Numba的一些关键作用和特点:
- 性能加速:Numba通过编译Python函数为机器码,可以显著提高函数的执行速度,使得Python在数值计算方面的速度接近C、C++或Fortran等传统高性能语言。
- 简单易用:Numba的使用非常简单,只需在函数定义前加上一个装饰器(decorator),Numba就会自动处理函数的编译和优化。这使得开发者无需对底层硬件和编译原理有深入了解即可提升代码性能。
- 支持并行计算:Numba提供了并行执行的功能,可以利用多核CPU进行并行计算,进一步提高程序的运行效率。
- GPU加速:Numba支持CUDA,这意味着可以将Python函数编译为可以在NVIDIA GPU上执行的代码,从而利用GPU的强大并行处理能力来加速计算密集型任务。
- 内存管理:Numba可以自动管理内存,减少数据在主机和GPU之间的传输,这对于提升程序性能尤其重要。
- 兼容性:Numba与NumPy紧密集成,可以无缝处理NumPy数组和数据结构,使得数据科学和机器学习领域的开发者能够轻松地加速现有代码。
- 灵活性:Numba提供了多种编译选项和功能,允许开发者根据需要进行细粒度的控制和优化。
from numba import cuda
print(cuda.gpus)
如果上述步骤没有问题,可以得到结果:<Managed Device 0>...。如果机器上没有GPU或没安装好上述包,会有报错。CUDA程序执行时会独霸一张卡,如果你的机器上有多张GPU卡,CUDA默认会选用0号卡。如果你与其他人共用这台机器,最好协商好谁在用哪张卡。一般使用CUDA_VISIBLE_DEVICES这个环境变量来选择某张卡。如选择5号GPU卡运行你的程序。
如果手头暂时没有GPU设备,Numba提供了一个模拟器,供用户学习调试
export NUMBA_ENABLE_CUDASIM=1from numba import cuda print(cuda.gpus)from numba import cuda def cpu_print(): print("print by cpu.") # 在GPU函数上添加@cuda.jit装饰符,表示该函数是一个在GPU设备上运行的函数,GPU函数又被称为核函数 @cuda.jit def gpu_print(): # GPU核函数 print("print by gpu.") def main(): # 主函数调用GPU核函数时,需要添加如[1, 2]这样的执行配置,这个配置是在告知GPU以多大的并行粒度同时进行计算。 # gpu_print[1, 2]()表示同时开启2个线程并行地执行gpu_print函数,函数将被并行地执行2次。下文会深入探讨如何设置执行配置。 gpu_print[1, 2]() # GPU核函数的启动方式是异步的:启动GPU函数后,CPU不会等待GPU函数执行完毕才执行下一行代码。 # 必要时,需要调用cuda.synchronize(),告知CPU等待GPU执行完核函数后,再进行CPU端后续计算。 cuda.synchronize() cpu_print() if __name__ == "__main__": main() # 使用CUDA_VISIBLE_DEVICES='0' python gpu_print.py执行这段代码,得到的结果为: # print by gpu. # print by gpu. # print by cpu.CUDA的Thread层次结构
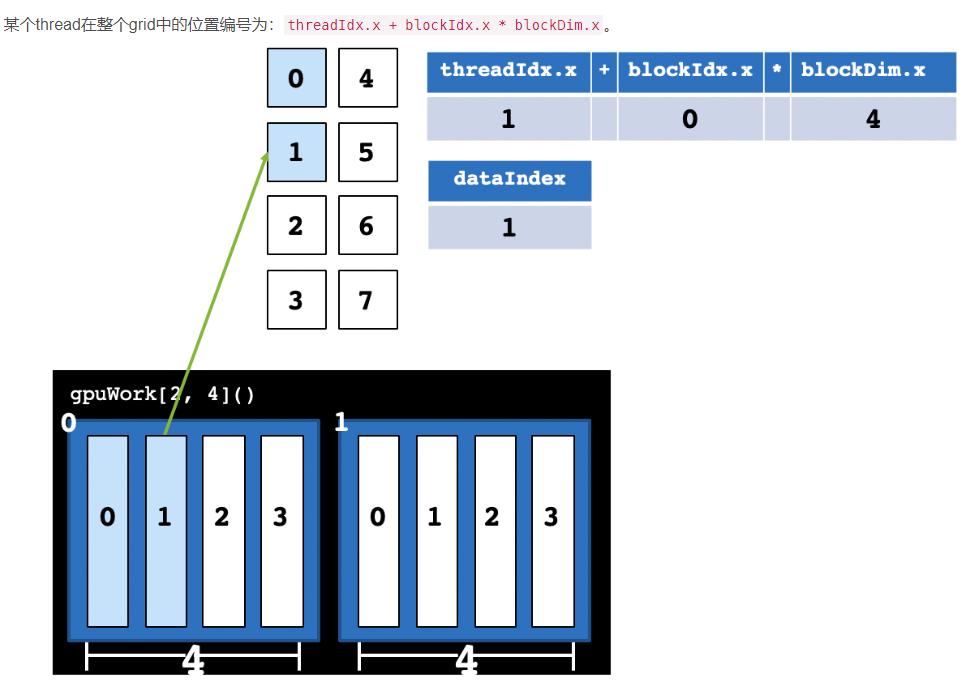
例如,把前面的程序改为并行执行8次:可以用2个block,每个block中有4个thread。原来的代码可以改为
gpu_print[2, 4](),其中方括号中第一个数字表示整个grid有多少个block,方括号中第二个数字表示一个block有多少个thread。
from numba import cuda def cpu_print(N): for i in range(0, N): print(i) @cuda.jit def gpu_print(N): idx = cuda.threadIdx.x + cuda.blockIdx.x * cuda.blockDim.x if (idx < N): print(idx) def main(): print("gpu print:") gpu_print[2, 4](8) cuda.synchronize() print("cpu print:") cpu_print(8) if __name__ == "__main__": main()这份代码打印了8个数字,核函数有一个参数N,N = 8,假如我们只想打印5个数字呢?当前的执行配置共2 * 4 = 8个线程,线程数8与要执行的次数5不匹配,不过我们已经在代码里写好了if (idx < N)的判断语句,判断会帮我们过滤不需要的计算。我们只需要把N = 5传递给gpu_print函数中就好,CUDA仍然会启动8个thread,但是大于等于N的thread不进行计算。注意,当线程数与计算次数不一致时,一定要使用这样的判断语句,以保证某个线程的计算不会影响其他线程的数据。
Block的设置
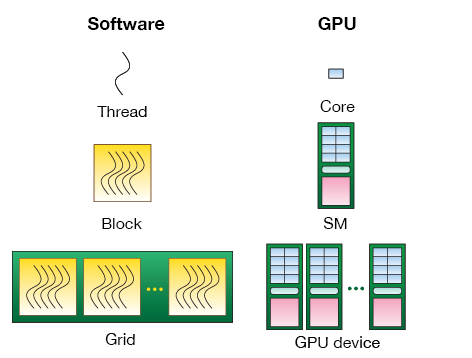
block运行在SM上,不同硬件架构(Turing、Volta、Pascal…)的CUDA核心数不同,一般需要根据当前硬件来设置block的大小blockDim(执行配置中第二个参数)。一个block中的thread数最好是32、128、256的倍数。注意,限于当前硬件的设计,block大小不能超过1024。
grid的大小gridDim(执行配置中第一个参数),即一个grid中block的个数可以由总次数N除以blockDim,并向上取整。
例如,我们想并行启动1000个thread,可以将blockDim设置为128,1000 ÷ 128 = 7.8,向上取整为8。使用时,执行配置可以写成gpuWork8, 128,CUDA共启动8 * 128 = 1024个thread,实际计算时只使用前1000个thread,多余的24个thread不进行计算。向量加法
@cuda.jit def gpu_add(a, b, result, n): # a, b为输入向量,result为输出向量 # 所有向量都是n维 # 得到当前thread的索引 idx = cuda.threadIdx.x + cuda.blockDim.x * cuda.blockIdx.x if idx < n: result[idx] = a[idx] + b[idx]初始化两个2千万维的向量,作为参数传递给核函数:
n = 20000000 x = np.arange(n).astype(np.int32) y = 2 * x gpu_result = np.zeros(n) # CUDA执行配置 threads_per_block = 1024 blocks_per_grid = math.ceil(n / threads_per_block) # 这样计算 gpu_add[blocks_per_grid, threads_per_block](x, y, gpu_result, n)
No comments yet.