目录
Raft 是一种简洁高效的分布式一致性算法,通过 Leader 选举和日志复制确保共识和一致性。
- 常见的一致性算法:
- Paxos:复杂,难以理解和实现。
- Raft:易于理解和实现,采用简单明了的解决方案。
- ZAB:Zookeeper 原子广播协议,专为 Zookeeper 设计。
- Raft 算法使用场景:
- 元数据管理:如 etcd,保证数据一致性和集群高可用。
- 分布式数据库:使用 partition group,每个 group 有一个 Raft 集群。
- Raft 算法基础:
- 包含三个子问题:领导选举、日志复制、安全性。
- 角色:领导者(Leader)、追随者(Follower)、候选人(Candidate)。
- 状态转换:
- 启动时所有节点为 Follower。
- 超时未接收到 Leader 请求,Follower 转换为 Candidate。
- Candidate 获得多数票成为 Leader。
- 发现已有 Leader 或收到更高任期请求,Candidate 转换为 Follower。
- Leader 收到更高任期请求,转换为 Follower。
- 任期:
- 任期编号是单调递增的,每个任期可能包含选举时间和正常运行时间。
- 通信:
- 使用两种 RPC 调用:RequestVote(候选人发起)和 AppendEntries(Leader 发起)。
- Leader 选举:
- 触发条件:系统初次启动或 Follower 超时未接收到 Leader 心跳。
- 当选条件:获得超过半数节点的投票。
- 日志同步:
- 保证 Leader 日志能完全复制到 Follower。
- 日志结构包含索引、任期号、命令。
- 日志持久化存储条件:Follower 必须先写入磁盘再响应 Leader。
- 日志已提交:存储在超过半数节点上。
- 一致性检查:
- 使用 AppendEntries RPC 消息。
- Follower 检查日志索引和任期号匹配。
- 日志一致性:
- 确保一个日志条目在所有节点上被提交。
?.2 流程推演
Term概念
Raft将Term作为内部的逻辑时钟,使用Term的对比来比较日志、身份、心跳的新旧而不是用绝对时间。Term与Leader的身份绑定,即某个节点是Leader更严谨一点的说法是集群某个Term的Leader。Term用连续的数字进行表示。Term会在follower发起选举(成为Candidate从而试图成为Leader )的时候加1,对于一次选举可能存在两种结果:
1.胜利当选:胜利的条件是超过半数的节点认为当前Candidate有资格成为Leader,即超过半数的节点给当前Candidate投了选票。
2.失败:如果没有任何Candidate(一个Term的Leader只有一位,但是如果多个节点同时发起选举,那么某个Term的Candidate可能有多位)获得超半数的选票,那么选举超时之后又会开始另一个Term(Term递增)的选举。
Raft是如何保证一个Term只有一个Leader的?
发生故障后Term过期后该怎么办
一个故障节点是无法知道当前最新的Term是多少,故障恢复后,节点可以通过其他节点发送过来的心跳中的Term信息查明一些过期信息。
当发现自己Term小于其他节点Term,说明自己已经过期了。
- leader、candidate:退回成follower并更新term到较大的term(既然过期了,说明raft集群可能已经有了新的leader,提交了新的日志)
- follower:仅更新term到较大的term
当发现自己的Term大于其他节点的Term,那么就会忽略这个消息中携带的其他信息
安全性
- 选举安全性:
- 每个term最多只会有1个leader(多人竞选可能没有leader)
- 集群同时最多只会有一个可以读写的leader(网络分区会导致多个leader,但是只有1个可以读写)
- 对于一次选举可能存在两种结果
- 胜利当选:胜利的条件是超过半数的节点认为当前Candidate有资格成为Leader,即超过半数的节点给当前Candidate投了选票。
- 失败:如果没有任何Candidate(一个Term的Leader只有一位,但是如果多个节点同时发起选举,那么某个Term的Candidate可能有多位)获得超半数的选票,那么选举超时之后又会开始另一个Term(Term递增)的选举
- 网络分区,一个分区中的leader会维护分区的运行,而另一个分区会因为没有leader而发生选举产生新的leader。任何情况下,最多只有一个分区拥有绝大部分节点 ,那么只有一个分区能写入日志
- election
- election timeout : follwer在成为candidate之前等待的时间, 150ms-300ms之间的一个随机数
- election timeout之后一个follower成为candidate,并且开启一轮新的election term
- 给自己vote一票
- 向其他node发送vote请求
- 如果接收节点在这个任期内还没有投票,那么它会投票给candidate,并且重置election timeout
- 一旦candidate获取到了大部分的vote,就会从转变成leader
- leader向followers发送append entries,发送间隔取决于**heartbeat timeout **,followers回复该请求
- election term将持续到follower停止心跳并成为候选人。
- re-election
- leader stop
- 剩余节点重新做选举出新leader, term+1
- 如果两个节点同时成为候选节点,则可能发生分裂投票,并且同时向其他节点发送vote请求,并且此时拿到了相同票数
- 此时node会多等待一任期,term+1
- 直到一个candidate获得了大部分votes
- log replication
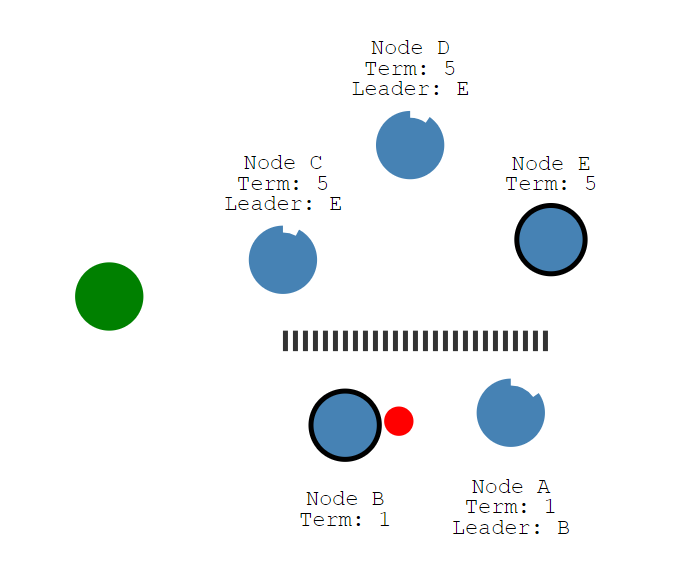
假设目前有5个node,AB和CDE之间发生了网络分区,此时经过一段时间,两个分区各自完成了选举
由于我们的分裂,我们现在有两个不同term的leader。
?.3 参考
https://thesecretlivesofdata.com/raft/
https://mp.weixin.qq.com/s/FFkGKaNpNwJtkpaO5yyYrg
1 raft的python实现
Raft是一种用于一致性算法的分布式协议,用于确保在多个节点之间数据的一致性。Raft协议包括选举、日志复制和故障恢复三个主要模块。下面是一个简化版的Python实现Raft的代码示例,以及对应的Mermaid流程图,用于展示Raft的主要流程。最后,我会介绍详细的测试方法。
import time
import random
from threading import Thread, Lock

class RaftNode:
    def __init__(self, node_id, peers):
        self.node_id = node_id
        self.peers = peers
        self.current_term = 0
        self.voted_for = None
        self.log = []
        self.commit_index = 0
        self.state = "follower"
        self.leader_id = None
        self.lock = Lock()

    def start(self):
        Thread(target=self.run).start()

    def run(self):
        while True:
            if self.state == "follower":
                self.follower_behavior()
            elif self.state == "candidate":
                self.candidate_behavior()
            elif self.state == "leader":
                self.leader_behavior()

    def follower_behavior(self):
        timeout = random.uniform(1, 2)
        time.sleep(timeout)
        if self.state == "follower":  # 超时后成为候选人
            self.state = "candidate"

    def candidate_behavior(self):
        self.current_term += 1
        self.voted_for = self.node_id
        votes = 1
        for peer in self.peers:
            if peer.request_vote(self.current_term, self.node_id):
                votes += 1
        if votes > len(self.peers) / 2:
            self.state = "leader"
            print(f"Node {self.node_id} became the leader for term {self.current_term}")
        else:
            time.sleep(random.uniform(1, 2))  # 等待重新选举

    def leader_behavior(self):
        while self.state == "leader":
            self.send_heartbeats()
            time.sleep(1)

    def request_vote(self, term, candidate_id):
        with self.lock:
            if term > self.current_term:
                self.current_term = term
                self.voted_for = candidate_id
                return True
            return False

    def send_heartbeats(self):
        print(f"Leader {self.node_id} sending heartbeats")

class RaftCluster:
    def __init__(self, num_nodes):
        self.nodes = [RaftNode(i, []) for i in range(num_nodes)]
        for i in range(num_nodes):
            self.nodes[i].peers = self.nodes[:i] + self.nodes[i+1:]

    def start(self):
        for node in self.nodes:
            node.start()

if __name__ == "__main__":
    cluster = RaftCluster(5)
    cluster.start()
1.1.1 Raft 流程图(Mermaid)
以下是Raft协议的流程图,展示了Follower、Candidate、Leader三种状态之间的转换逻辑。
graph TD A[Follower] -->|超时| B[Candidate] B -->|选举成功| C[Leader] B -->|选举失败| A C -->|发送心跳| A A -->|收到心跳| A1.1.2 测试方法
为了测试Raft协议的Python实现,您可以使用以下几种方法:
模拟集群启动:
- 创建一个包含多个节点的Raft集群,验证每个节点是否能够在选举过程中正确地转换状态(从Follower到Candidate,再到Leader)。
模拟节点选举:
- 设置超时时间来触发选举,观察节点是否在超时后从Follower状态转换为Candidate,是否有节点成功当选Leader。
- 测试Leader发送心跳信号以及在Leader崩溃时其他节点重新进行选举的过程。
def test_leader_failure(cluster):
    cluster.nodes[0].state = "leader"  # 手动设置Node 0为Leader
    print(f"Node 0 is the leader.")
    time.sleep(5)
    cluster.nodes[0].state = "follower"  # 模拟Leader崩溃
    print(f"Node 0 failed, starting new election.")
日志复制:
通过以上测试方法,可以确保Raft协议的基本功能如选举、心跳信号和故障恢复都正常工作。
2 raft的c++实现
No comments yet.