目录
- 0、accept + read/write
- 1、accept + fork
- 2、thread-per-connection
- 3、prefork
- 4、pre threaded
- 5、IO复用
- 6、reactor+per thread task
- 7、reactor + worker thread
- 8、one reactor + thread poll
- 9、reactors in per threads
- 10、reactors in per processes
- 11、reactors + thread pool
- 确定event loop的个数
- 实用的模型
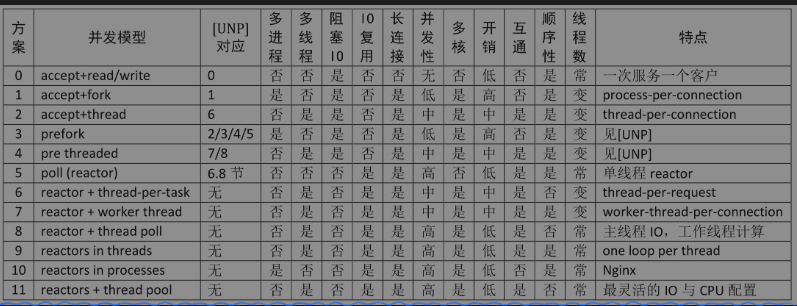
方案0:并非并发服务器,一次只能服务一个客户。
py代码如下:
#!/usr/bin/python

import socket

def handle(client_socket, client_address):
    while True:
        data = client_socket.recv(4096)
        if data:
            sent = client_socket.send(data)    # sendall?
        else:
            print "disconnect", client_address
            client_socket.close()
            break

if __name__ == "__main__":
    listen_address = ("0.0.0.0", 2007)
    server_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
    server_socket.bind(listen_address)
    server_socket.listen(5)

    while True:
        (client_socket, client_address) = server_socket.accept()
        print "got connection from", client_address
        handle(client_socket, client_address)
1、accept + fork
适合并发连接数不大的情况。
#!/usr/bin/python

from SocketServer import BaseRequestHandler, TCPServer
from SocketServer import ForkingTCPServer, ThreadingTCPServer

class EchoHandler(BaseRequestHandler):
    def handle(self):
        print "got connection from", self.client_address
        while True:
            data = self.request.recv(4096)
            if data:
                sent = self.request.send(data)    # sendall?
            else:
                print "disconnect", self.client_address
                self.request.close()
                break

if __name__ == "__main__":
    listen_address = ("0.0.0.0", 2007)
    server = ForkingTCPServer(listen_address, EchoHandler)
    server.serve_forever()
2、thread-per-connection
这种方案的伸缩性受到线程数的限制,一两百个还行,几千个的话对操作系统的scheduler恐怕是个不小的负担。
ThreadingTCPServer会对每个客户连接新建一个线程,在该线程中调用EchoHandler.handle()
3、prefork
这是针对方案1的优化,[UNP]详细分析了几种变化,包括对accept(2)“惊群”问题(thundering herd)的考虑
这是对方案2的优化,[UNP]详细分析了它的几种变化。方案3和方案4这两个方案都是Apache httpd长期使用的方案
5、IO复用
Reactor模式,让event-driven网络编程有章可循。继而出现了一些通用的Reactor框架/库,比如libevent、muduo、Netty、twisted、POE。
epoll模型
1、定义一个从文件描述符到socket对象的映射
3、当有IO事件发生时,就针对不同的文件描述符执行不同的操作
- 对于监听fd,accept新连接,并注册到IO的watch list中,然后将连接添加到connections cache中
- 对于客户连接,读取并回显数据,并处理连接的关闭
- 对于echo服务真正的业务逻辑只有:将收到的数据原样发回客户端
#!/usr/bin/python

import socket
import select

server_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
server_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
server_socket.bind(('', 2007))
server_socket.listen(5)
# server_socket.setblocking(0)
poll = select.poll() # epoll() should work the same
poll.register(server_socket.fileno(), select.POLLIN)

connections = {}
while True:
    events = poll.poll(10000)  # 10 seconds
    for fileno, event in events:
        if fileno == server_socket.fileno():   # 处理监听事件
            (client_socket, client_address) = server_socket.accept()
            print "got connection from", client_address
            # client_socket.setblocking(0)
            poll.register(client_socket.fileno(), select.POLLIN)
            connections[client_socket.fileno()] = client_socket
        elif event & select.POLLIN:             # 处理连接
            client_socket = connections[fileno]
            data = client_socket.recv(4096)
            if data:
                client_socket.send(data) # sendall() partial?
            else:
                poll.unregister(fileno)
                client_socket.close()
                del connections[fileno]
而Reactor的意义在于将消息(IO事件)分发到用户提供的处理函数,并保持网络部分的通用代码不变,独立于用户的业务逻辑。
单线程reactor
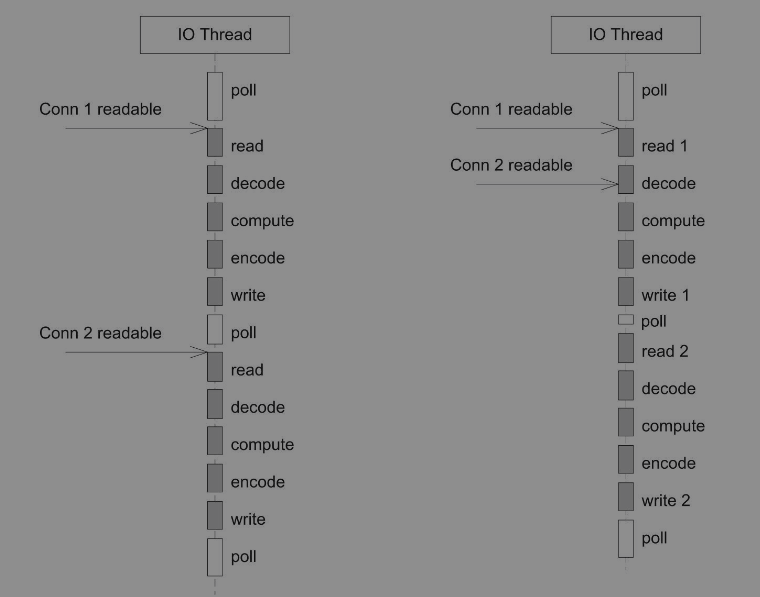
与方案2相比,方案5处理网络消息的延迟可能要略大一些,因为方案2直接一次read(2)系统调用就能拿到请求数据,而方案5要先poll(2)再read(2),多了一次系统调用。
#!/usr/bin/python

import socket
import select

server_socket = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
server_socket.setsockopt(socket.SOL_SOCKET, socket.SO_REUSEADDR, 1)
server_socket.bind(('', 2007))
server_socket.listen(5)
# serversocket.setblocking(0)

poll = select.poll() # epoll() should work the same
connections = {}
handlers = {}

def handle_input(socket, data):
    socket.send(data) # sendall() partial?

def handle_request(fileno, event):
    if event & select.POLLIN:
        client_socket = connections[fileno]
        data = client_socket.recv(4096)
        if data:
            handle_input(client_socket, data)
        else:
            poll.unregister(fileno)
            client_socket.close()
            del connections[fileno]
            del handlers[fileno]

def handle_accept(fileno, event):
    (client_socket, client_address) = server_socket.accept()
    print "got connection from", client_address
    # client_socket.setblocking(0)
    poll.register(client_socket.fileno(), select.POLLIN)
    connections[client_socket.fileno()] = client_socket
    handlers[client_socket.fileno()] = handle_request

poll.register(server_socket.fileno(), select.POLLIN)
handlers[server_socket.fileno()] = handle_accept

while True:
    events = poll.poll(10000)  # 10 seconds
    for fileno, event in events:
        handler = handlers[fileno]
        handler(fileno, event)
6、reactor+per thread task
收到请求后不在reactor线程计算,而是创建一个新的线程去计算。
它是为每个请求(而非连接)创建一个新线程,这个开销可以用线程池来避免
同时创建多个线程去计算同一个连接上收到的多个请求,那么算出结果的次序是不确定的
为了让返回结果的顺序确定,我们可以为每个连接创建一个计算线程,每个连接上的请求固定发给同一个线程去算,先到先得。
方案7与方案6的另外一个区别是单个client的最大CPU占用率。在方案6中,一个TCP连接上发来的一长串突发请求(burst requests)可以占满全部8个core;而在方案7中,由于每个连接上的请求固定由同一个线程处理,那么它最多占用12.5%的CPU资源。这两种方案各有优劣,取决于应用场景的需要(到底是公平性重要还是突发性能重要)
8、one reactor + thread poll
全部的IO工作都在一个Reactor线程完成,而计算任务交给thread pool.
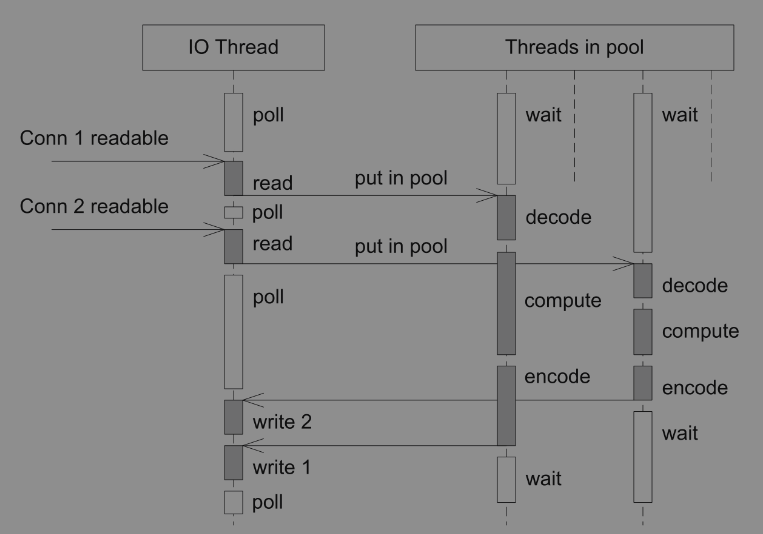
线程池的另外一个作用是执行阻塞操作。比如有的数据库的客户端只提供同步访问,那么可以把数据库查询放到线程池中,可以避免阻塞IO线程,不会影响其他客户连接
9、reactors in per threads
muduo内置的多线程方案,也是Netty内置的多线程方案
one loop per thread,有一个main Reactor负责accept(2)连接,然后把连接挂在某个sub Reactor中。
这样该连接的所有操作都在那个sub Reactor所处的线程中完成。多个连接可能被分派到多个线程中,以充分利用CPU。
muduo采用的是固定大小的Reactor pool,池子的大小通常根据CPU数目确定,也就是说线程数是固定的,这样程序的总体处理能力不会随连接数增加而下降
另外,由于一个连接完全由一个线程管理,那么请求的顺序性有保证,突发请求也不会占满全部8个核。
这种方案把IO分派给多个线程,防止出现一个Reactor的处理能力饱和。
与方案8的线程池相比,方案9减少了进出thread pool的两次上下文切换,在把多个连接分散到多个Reactor线程之后,小规模计算可以在当前IO线程完成并发回结果,从而降低响应的延迟。
这是Nginx的内置方案。如果连接之间无交互,这种方案也是很好的选择。工作进程之间相互独立,可以热升级
11、reactors + thread pool
这种方案适合既有突发IO(利用多线程处理多个连接上的IO),又有突发计算的应用(利用线程池把一个连接上的计算任务分配给多个线程去做)
确定event loop的个数
一个程序到底是使用一个event loop还是使用多个event loops呢?ZeroMQ的手册给出的建议是,按照每千兆比特每秒的吞吐量配一个event loop的比例来设置event loop的数目,即muduo::TcpServer::setThreadNum()的参数。依据这条经验规则,在编写运行于千兆以太网上的网络程序时,用一个event loop就足以应付网络IO。如果程序本身没有多少计算量,而主要瓶颈在网络带宽,那么可以按这条规则来办,只用一个event loop。另一方面,如果程序的IO带宽较小,计算量较大,而且对延迟不敏感,那么可以把计算放到thread pool中,也可以只用一个event loop。值得指出的是,以上假定了TCP连接是同质的,没有优先级之分,我们看重的是服务程序的总吞吐量。但是如果TCP连接有优先级之分,那么单个event loop可能不适合,正确的做法是把高优先级的连接用单独的event loop来处理
在muduo中,属于同一个event loop的连接之间没有事件优先级的差别。
我们应该用单独的event loop来管理心跳连接,这样就能避免数据连接上的事件阻塞了心跳事件,因为它们分属不同的线程。
陈硕推荐的C++多线程服务端编程模式为:one loop per thread+thread pool。· event loop用作non-blocking IO和定时器。· thread pool用来做计算,具体可以是任务队列或生产者消费者队列
2、5、8、9、11
N表示并发连接数目,C1和C2是与连接数无关、与CPU数目有关的常数。
8:单线程处理连接和IO,计算可以并行了。排队会耗时。
11:又增加了一层队列。资源利用率可能更高,但是延迟会比9大(多了IO与计算线程的切换)
No comments yet.