目录
系统架构图
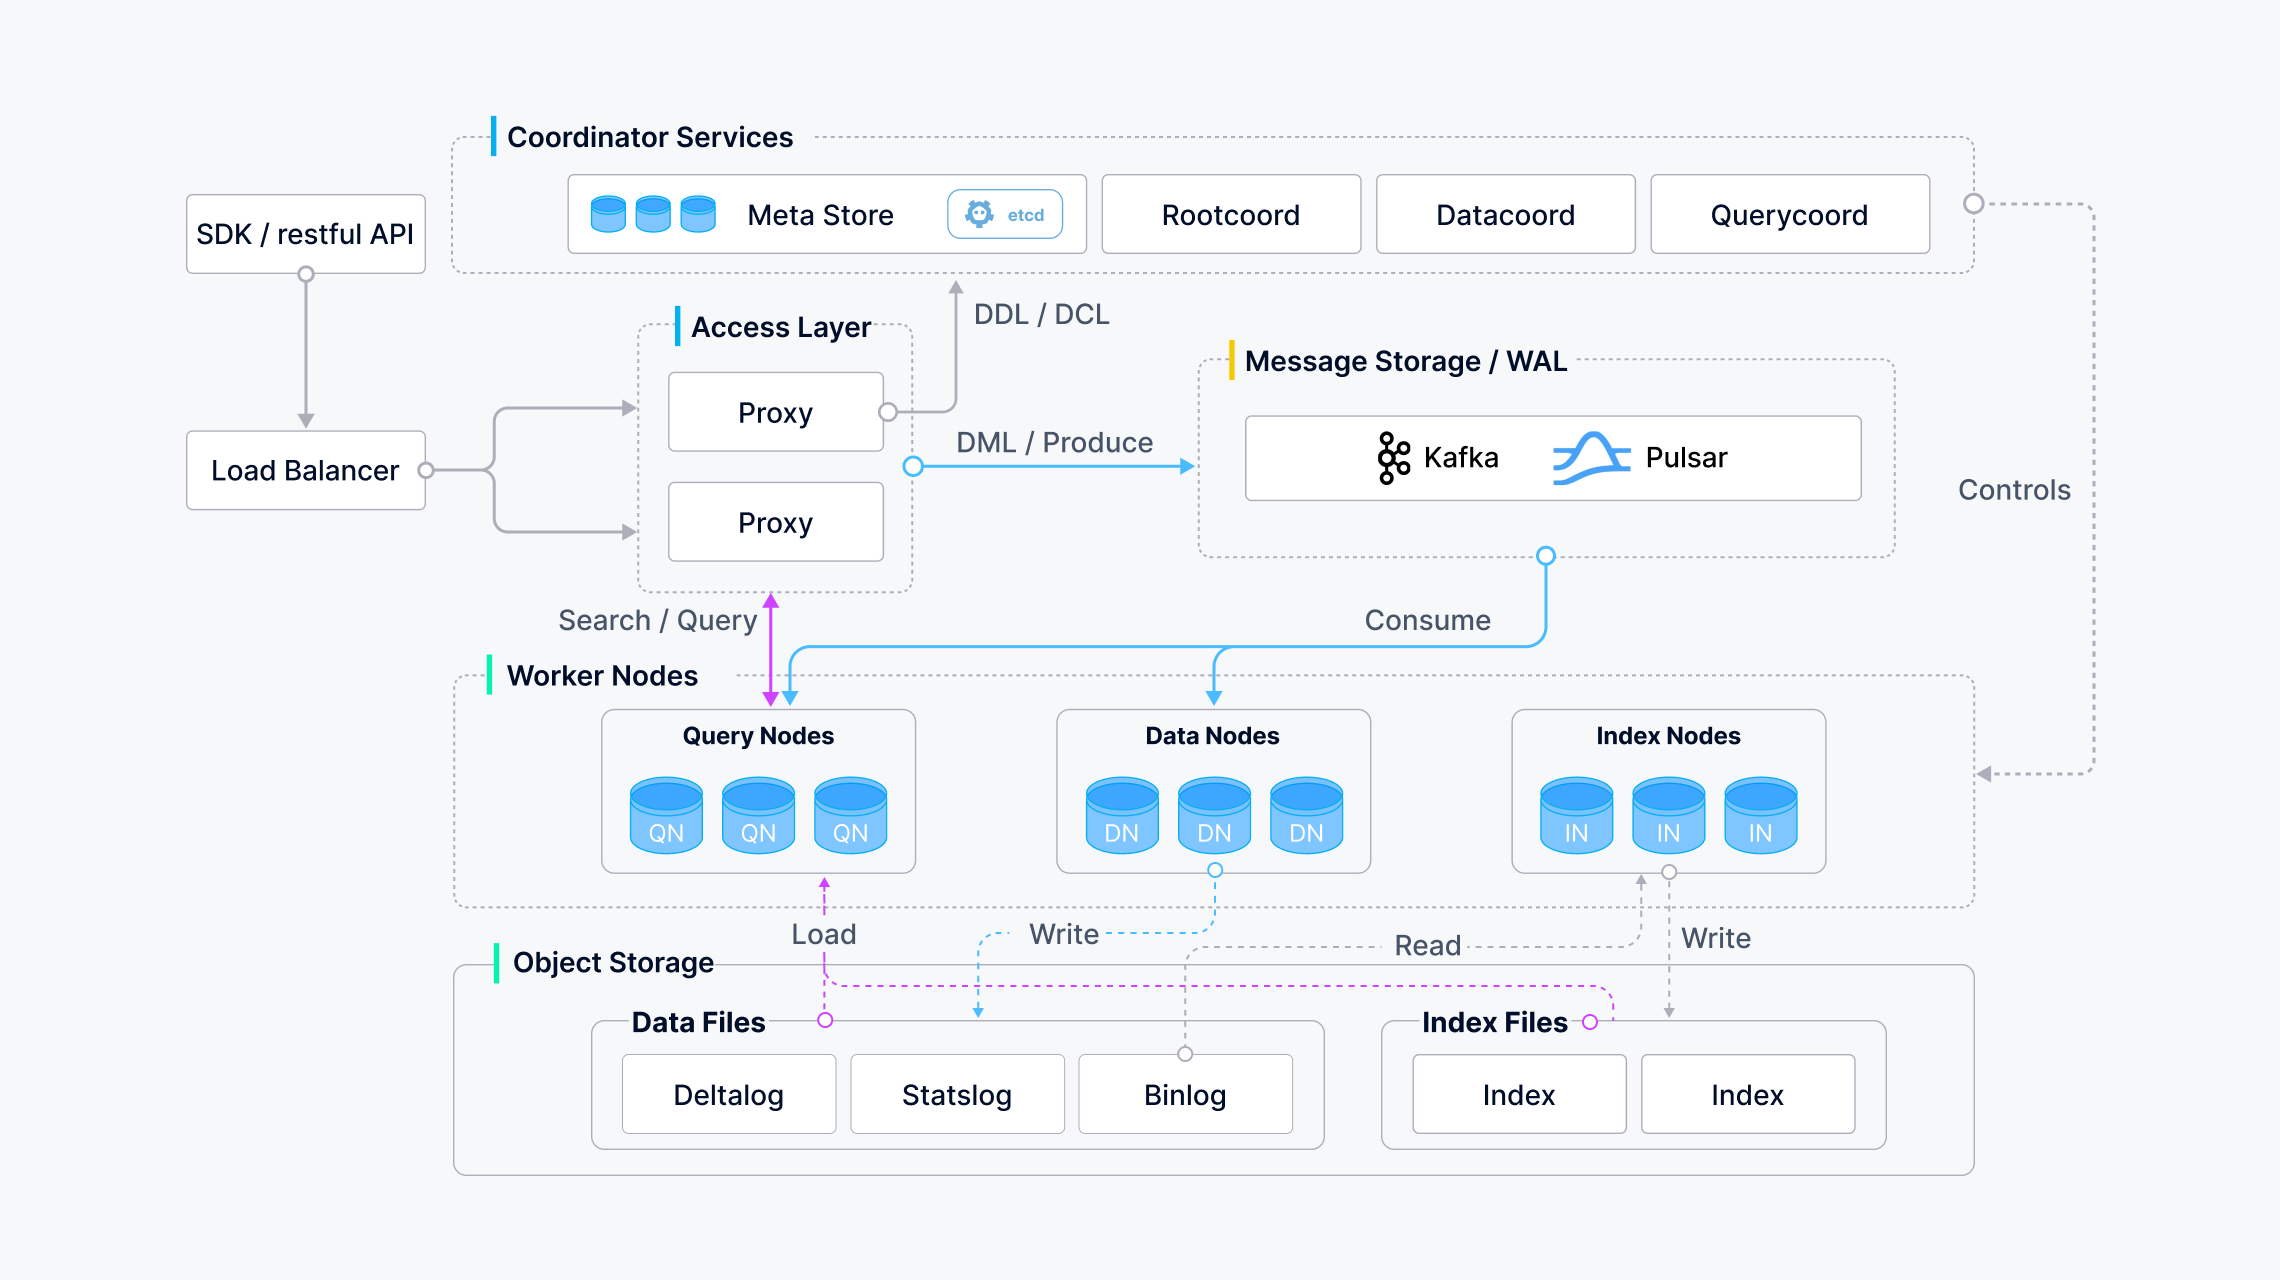
在服务端,Milvus 由 Milvus Core 和 Meta Store 两部分组成:
- Milvus Core 存储与管理向量和标量数据。
- Meta Store 存储与管理 SQLite 和 MySQL 中的元数据,分别用于测试和生产。
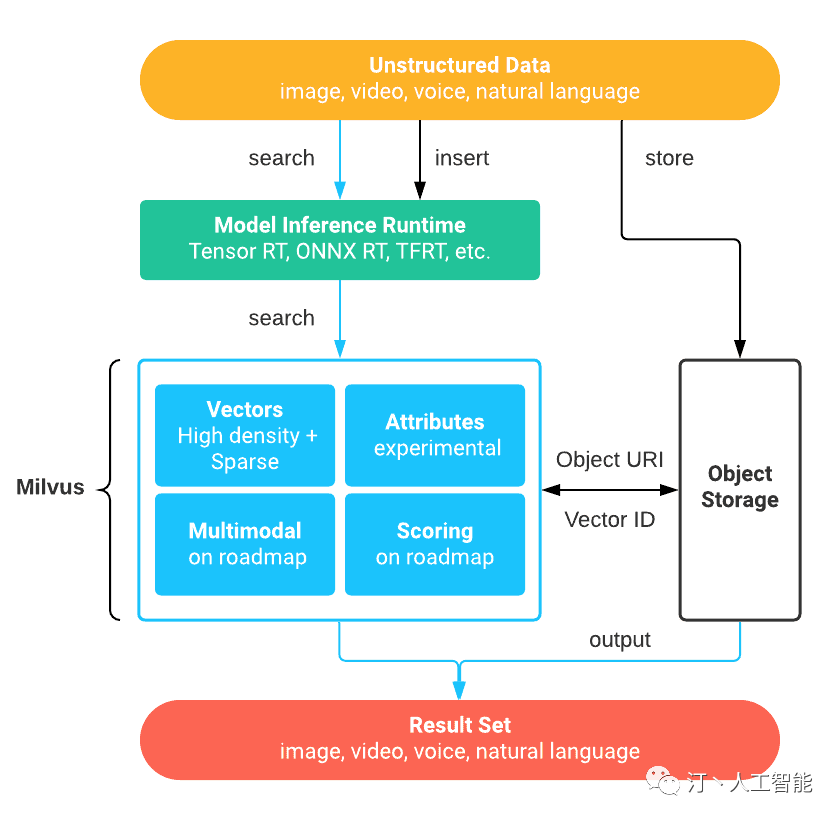
更多技术介绍:https://milvus.io/docs/zh/four_layers.md
简单介绍
Milvus 是一个开源的向量数据库,专为大规模人工智能应用设计,用于存储、索引和管理由深度神经网络和其他机器学习模型生成的大量嵌入向量。它支持从小型项目到服务数十亿用户的大规模搜索,可以在多种环境中高效运行,包括笔记本电脑到大规模分布式系统。
Milvus 提供了多种部署模式,以适应不同规模的数据需求:
- Milvus Lite:作为一个轻量级的 Python 库,适合快速原型开发和在资源有限的边缘设备上运行。
- Milvus Standalone:适合单机部署,所有组件都包含在一个 Docker 镜像中,方便部署。
- Milvus Distributed:可部署在 Kubernetes 集群上,采用云原生架构,专为处理十亿规模甚至更大的数据场景而设计。
Milvus 的特点包括:
- 高性能:Milvus 的性能在大多数情况下是其他向量数据库的 2-5 倍,支持多种内存和磁盘索引/搜索算法,包括 IVF、HNSW、DiskANN 等。
- 硬件感知优化:Milvus 针对多种硬件架构和平台进行了优化,包括 AVX512、SIMD、GPU 和 NVMe SSD。
- C++ 搜索引擎:Milvus 使用 C++ 语言处理搜索引擎这一关键组件,以实现高性能和底层优化。
- 面向列:Milvus 是面向列的向量数据库系统,只在执行查询时读取涉及的特定字段,减少数据访问量。
Milvus 支持各种类型的搜索功能,包括 ANN 搜索、过滤搜索、范围搜索、混合搜索、关键词搜索等。此外,Milvus 提供了 RESTful API 和多种语言的 SDK,包括 Python、Java、Go、C# 和 Node.js。
Milvus 也提供了一些工具和生态系统支持,例如 Attu(一个直观的图形用户界面,帮助管理 Milvus 及其数据)、Birdwatcher(调试工具)、Prometheus 和 Grafana 集成、Milvus 备份、Milvus Capture Data Change (CDC)、Milvus 连接器和向量传输服务(VTS)。
总的来说,Milvus 是一个功能丰富、高性能、可扩展的向量数据库,适用于处理大规模的非结构化数据,并且具有强大的社区和生态系统支持。
https://zhuanlan.zhihu.com/p/476025527
https://milvus.io/docs/quickstart.md
https://milvus.io/docs/install_standalone-docker.md
No comments yet.