目录
- 常用命令
- etcd、kube-api、kube-contro、kube-sche这几个服务之间的调用关系
- Liveness & Startup
- ingress
- 我启动docker的时候绑定了与9999端口的映射,然后我kill掉docker run,然后想重启拉起这个docker 结果发现端口仍然被占用这该怎么办?
- 某个pod处于podscheduled状态,但是containersReady状态为false,请问这是什么原因
知识与你分享:
k8s网络
https://wiki.yitu-inc.com/pages/viewpage.action?pageId=581215062
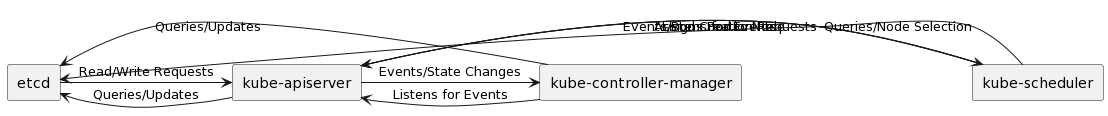
etcd、kube-api、kube-contro、kube-sche这几个服务之间的调用关系
- etcd:etcd 是一个分布式键值存储系统,用于持久化保存 Kubernetes 集群的状态信息。etcd 存储了集群的配置数据(如 Pod、Service、ConfigMap 等),并通过提供 RESTful API 进行访问。
- kube-api:kube-apiserver 是 Kubernetes API 服务器,作为集群中所有组件的接口和控制平面。其他组件通过与 kube-apiserver 的 API 通信来管理和操作 Kubernetes 资源。kube-apiserver 将请求转发给 etcd 来读取或修改集群状态,并返回响应给客户端。
- kube-controller-manager:kube-controller-manager 是 Kubernetes 控制器管理器,负责运行多个控制器进程来监控集群状态并采取相应的操作。这些控制器包括 Replication Controller、Namespace Controller、Node Controller、Service Account Controller 等。kube-controller-manager 通过 kube-apiserver 接收事件和状态变更的通知,并执行必要的操作来保持所期望的集群状态。
- kube-scheduler:kube-scheduler 是 Kubernetes 调度器,负责将新创建的 Pod 分配到合适的节点上运行。kube-scheduler 监听 kube-apiserver 上的事件,当有未调度的 Pod 创建请求时,它会考虑节点资源和调度策略,并选择一个合适的节点来部署该 Pod。
调用关系如下:
- 使用 HTTP GET 方法进行检查。
- 目标 URL 是
http://127.0.0.1:2381/health。 - 延迟时间(delay)为 10 秒,即容器启动后等待 10 秒开始进行第一次探测。
- 超时时间(timeout)为 15 秒,即在等待响应超过 15 秒后被视为失败。
- 探测周期(period)为 10 秒,即每隔 10 秒进行一次存活探测。
- 要求成功次数(#success)为 1,即连续成功探测的次数满足要求后才认定容器为存活。
- 允许失败次数(#failure)为 8,即连续失败探测的次数达到该值后容器将被认定为不存活。
- 使用 HTTP GET 方法进行检查。
- 目标 URL 是
http://127.0.0.1:2381/health。 - 延迟时间(delay)为 10 秒,即容器启动后等待 10 秒开始进行第一次探测。
- 超时时间(timeout)为 15 秒,即在等待响应超过 15 秒后被视为失败。
- 探测周期(period)为 10 秒,即每隔 10 秒进行一次启动探测。
- 要求成功次数(#success)为 1,即连续成功探测的次数满足要求后才认定容器已成功启动。
- 允许失败次数(#failure)为 24,即连续失败探测的次数达到该值后容器将被认定为启动失败。
- 重新启动Docker服务:
- 使用
netstat -ano或lsof -i :9999命令再次确认是否有其他进程占用了9999端口。
- 使用
- 更改Docker端口映射:
- 如果以上方法都无法解决问题,可以考虑重启系统来确保所有资源得到正确释放。
- 网络延迟或超时: 在某些情况下,特别是在网络环境不稳定或者Docker守护进程忙于处理其他任务时,释放端口的操作可能会因为网络延迟或超时而失败。
- 系统资源限制: 如果系统资源受限,例如文件描述符数达到上限,可能导致Docker守护进程无法正确释放端口。
- Docker守护进程问题: Docker守护进程本身可能出现了一些问题,导致它无法正确释放端口。
- 未记录的异常: 可能存在未知的异常情况,导致Docker守护进程没有按照预期方式释放端口。
- 容器启动时间过长:容器启动所需的时间可能比期望的时间更长。这可能是由于容器内部的初始化、依赖项下载或其他操作导致。
- 容器启动失败:容器可能遇到了启动时的错误,使它无法成功启动。这可能包括配置问题、资源不足、依赖项缺失等。
- 容器死锁:容器内部可能出现了死锁情况,导致容器无法初始化完成。
- 资源不足:可能由于节点资源不足,导致容器无法获得足够的资源来启动。
- 依赖项问题:容器可能需要访问外部服务或依赖项,在该容器所在的环境中这些依赖项不可用。
总结起来,etcd 是存储集群状态的后端,kube-apiserver 是集群的主要接口和控制平面,kube-controller-manager 负责运行各种控制器来维护集群状态,而 kube-scheduler 则负责为新的 Pod 进行调度选择。这四个组件相互配合,共同实现了 Kubernetes 集群的管理和调度功能。
@startuml

rectangle "etcd" as etcd
rectangle "kube-apiserver" as apiserver
rectangle "kube-controller-manager" as controller
rectangle "kube-scheduler" as scheduler

etcd -> apiserver : Read/Write Requests
apiserver -> etcd : Queries/Updates

apiserver -> controller : Events/State Changes
controller -> apiserver : Listens for Events
controller -> etcd : Queries/Updates

apiserver -> scheduler : Events/Pod Creation Requests
scheduler -> apiserver : Listens for Events
scheduler -> etcd : Queries/Node Selection
scheduler -> apiserver : Assigns Pod to Node

@enduml
Liveness & Startup
如:
Liveness(存活探测):
根据配置,Liveness 探测和 Startup 探测都是使用 HTTP GET 方法对 http://127.0.0.1:2381/health 进行检查。这些探测用于确保容器在运行期间或启动过程中处于健康状态。
您可以根据需要调整探测的 URL、延迟时间、超时时间、周期以及成功和失败的次数,以适配您的应用程序和部署环境。
ingress
在Kubernetes中,Ingress Pod 是一个负责将外部流量路由到集群内部服务的组件。它充当了一个入口点,允许外部用户访问集群中运行的服务。
具体来说,Ingress Pod 通过使用Ingress 资源对象定义的规则来管理流量路由。Ingress 资源对象定义了一组规则,这些规则指定了外部请求应该如何被转发到集群内部的不同服务。
Ingress Pod 与其他服务一样,是由Kubernetes管理的一个容器化应用程序。它通常与反向代理(例如NGINX或Traefik)结合使用,用于执行实际的流量路由操作。
通过使用Ingress Pod,您可以将不同的域名或路径映射到不同的后端服务,实现灵活的流量控制和负载均衡。它简化了在集群中暴露和管理服务的过程,并提供了可扩展性和弹性,以适应不同的应用需求。
我启动docker的时候绑定了与9999端口的映射,然后我kill掉docker run,然后想重启拉起这个docker 结果发现端口仍然被占用这该怎么办?
在这种情况下,如果你杀死了之前绑定了9999端口映射的Docker容器,但是发现端口仍然被占用,可能是因为Docker守护进程没有释放该端口。以下是一些解决方法:
通过上述方法,你应该能够解决Docker导致端口仍然被占用的问题,并成功重新拉起Docker容器。
杀死了之前绑定了9999端口映射的Docker容器,为什么Docker守护进程没有释放该端口?
通常情况下,当你杀死绑定了端口映射的Docker容器后,Docker守护进程会释放该端口。然而,有时候可能出现一些问题导致Docker没有正确释放端口。以下是一些可能的原因:
若发生这种情况,重新启动Docker服务、系统重启或者使用其他方法强制释放端口都可能是解决问题的办法。此外,检查系统日志以及Docker守护进程的日志也许可以帮助你找到更准确的原因。
某个pod处于podscheduled状态,但是containersReady状态为false,请问这是什么原因
当某个 pod 处于 "PodScheduled" 状态但 "containersReady" 状态为 false 时,通常意味着容器在 pod 内部尚未准备就绪。这可能由多种原因引起,例如:
要解决这个问题,可以进行以下操作:
No comments yet.