目录
[TOC]
它支持多种表引擎,每种引擎都有其特定的用途和优化场景。以下是一些ClickHouse中常用的表引擎类别及其特点:
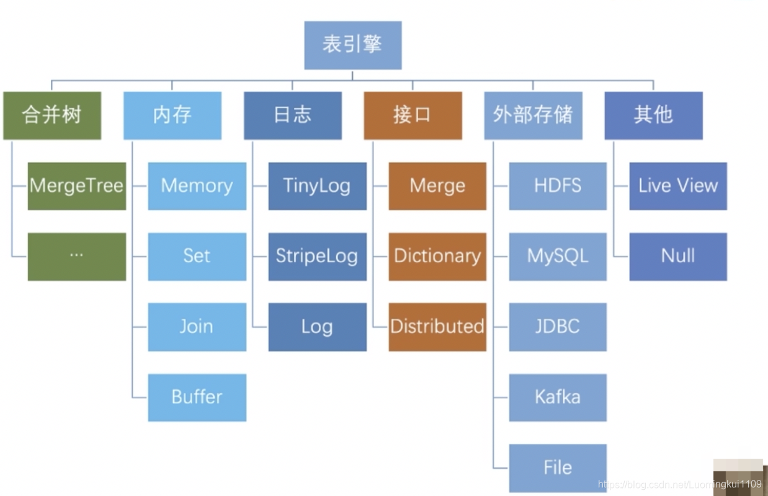

官方文档:https://clickhouse.com/docs/zh/engines/table-engines
1. MergeTree系列引擎
MergeTree系列引擎是ClickHouse中最强大的表引擎,适用于高负载任务和大数据量的快速写入。这些引擎支持数据分区、数据复制、数据合并等功能,适用于需要处理大量数据的在线分析场景
ClickHouse的MergeTree系列引擎是专为高性能数据插入和存储设计的,它们支持数据的分区、排序、索引和合并等功能。MergeTree系列引擎的子类包括但不限于以下几种:
- MergeTree:基础的MergeTree引擎,支持数据分区和排序。
- ReplacingMergeTree:在合并过程中删除具有相同主键的重复数据。
- SummingMergeTree:合并时自动对具有相同主键的记录进行数值聚合。
- AggregatingMergeTree:在同一数据分区下,可以将具有相同主键的数据进行聚合。
- CollapsingMergeTree:在同一数据分区下,对具有相同主键的数据进行折叠合并。
- VersionedCollapsingMergeTree:基于CollapsingMergeTree引擎,增加了数据版本信息字段配置选项。
- GraphiteMergeTree:专门用于存储时序数据库Graphite的数据。
MergeTree
可以参考:https://clickhouse.com/docs/zh/engines/table-engines/mergetree-family/mergetree
MergeTree 系列的引擎被设计用于插入极大量的数据到一张表当中。数据可以以数据片段的形式一个接着一个的快速写入,数据片段在后台按照一定的规则进行合并。相比在插入时不断修改(重写)已存储的数据,这种策略会高效很多。
主要特点:
存储的数据按主键排序。
这使得您能够创建一个小型的稀疏索引来加快数据检索。
如果指定了 分区键 的话,可以使用分区。
在相同数据集和相同结果集的情况下 ClickHouse 中某些带分区的操作会比普通操作更快。查询中指定了分区键时 ClickHouse 会自动截取分区数据。这也有效增加了查询性能。
支持数据副本。
ReplicatedMergeTree系列的表提供了数据副本功能。支持数据采样。
需要的话,您可以给表设置一个采样方法。
注意:merge引擎和MergeTree 不是一个东西
建表语句
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    name1 [type1] [DEFAULT|MATERIALIZED|ALIAS expr1] [TTL expr1],
    name2 [type2] [DEFAULT|MATERIALIZED|ALIAS expr2] [TTL expr2],
    ...
    INDEX index_name1 expr1 TYPE type1(...) GRANULARITY value1,
    INDEX index_name2 expr2 TYPE type2(...) GRANULARITY value2
) ENGINE = MergeTree()
ORDER BY expr
[PARTITION BY expr]
[PRIMARY KEY expr]
[SAMPLE BY expr]
[TTL expr [DELETE|TO DISK 'xxx'|TO VOLUME 'xxx'], ...]
[SETTINGS name=value, ...]
ENGINE- 引擎名和参数。ENGINE = MergeTree().MergeTree引擎没有参数。ORDER BY— 排序键。可以是一组列的元组或任意的表达式。 例如:
ORDER BY (CounterID, EventDate)。如果没有使用
PRIMARY KEY显式指定的主键,ClickHouse 会使用排序键作为主键。如果不需要排序,可以使用
ORDER BY tuple(). 参考 选择主键PARTITION BY— 分区键 ,可选项。大多数情况下,不需要使用分区键。即使需要使用,也不需要使用比月更细粒度的分区键。分区不会加快查询(这与 ORDER BY 表达式不同)。永远也别使用过细粒度的分区键。不要使用客户端指定分区标识符或分区字段名称来对数据进行分区(而是将分区字段标识或名称作为 ORDER BY 表达式的第一列来指定分区)。
要按月分区,可以使用表达式
toYYYYMM(date_column),这里的date_column是一个 Date 类型的列。分区名的格式会是"YYYYMM"。PRIMARY KEY- 如果要 选择与排序键不同的主键,在这里指定,可选项。默认情况下主键跟排序键(由
ORDER BY子句指定)相同。 因此,大部分情况下不需要再专门指定一个PRIMARY KEY子句。SAMPLE BY- 用于抽样的表达式,可选项。如果要用抽样表达式,主键中必须包含这个表达式。例如:
SAMPLE BY intHash32(UserID) ORDER BY (CounterID, EventDate, intHash32(UserID))。TTL- 指定行存储的持续时间并定义数据片段在硬盘和卷上的移动逻辑的规则列表,可选项。表达式中必须存在至少一个
Date或DateTime类型的列,比如:TTL date + INTERVAl 1 DAY规则的类型
DELETE|TO DISK 'xxx'|TO VOLUME 'xxx'指定了当满足条件(到达指定时间)时所要执行的动作:移除过期的行,还是将数据片段(如果数据片段中的所有行都满足表达式的话)移动到指定的磁盘(TO DISK 'xxx') 或 卷(TO VOLUME 'xxx')。默认的规则是移除(DELETE)。可以在列表中指定多个规则,但最多只能有一个DELETE的规则。SETTINGS— 控制MergeTree行为的额外参数,可选项:index_granularity— 索引粒度。索引中相邻的『标记』间的数据行数。默认值8192 。参考数据存储。index_granularity_bytes— 索引粒度,以字节为单位,默认值: 10Mb。如果想要仅按数据行数限制索引粒度, 请设置为0(不建议)。min_index_granularity_bytes- 允许的最小数据粒度,默认值:1024b。该选项用于防止误操作,添加了一个非常低索引粒度的表。参考数据存储enable_mixed_granularity_parts— 是否启用通过index_granularity_bytes控制索引粒度的大小。在19.11版本之前, 只有index_granularity配置能够用于限制索引粒度的大小。当从具有很大的行(几十上百兆字节)的表中查询数据时候,index_granularity_bytes配置能够提升ClickHouse的性能。如果您的表里有很大的行,可以开启这项配置来提升SELECT查询的性能。use_minimalistic_part_header_in_zookeeper— ZooKeeper中数据片段存储方式 。如果use_minimalistic_part_header_in_zookeeper=1,ZooKeeper 会存储更少的数据。更多信息参考[服务配置参数](Server Settings | ClickHouse Documentation)这章中的 设置描述 。min_merge_bytes_to_use_direct_io— 使用直接 I/O 来操作磁盘的合并操作时要求的最小数据量。合并数据片段时,ClickHouse 会计算要被合并的所有数据的总存储空间。如果大小超过了min_merge_bytes_to_use_direct_io设置的字节数,则 ClickHouse 将使用直接 I/O 接口(O_DIRECT选项)对磁盘读写。如果设置min_merge_bytes_to_use_direct_io = 0,则会禁用直接 I/O。默认值:10 * 1024 * 1024 * 1024字节。<a name="mergetree_setting-merge_with_ttl_timeout"></a>merge_with_ttl_timeout— TTL合并频率的最小间隔时间,单位:秒。默认值: 86400 (1 天)。write_final_mark— 是否启用在数据片段尾部写入最终索引标记。默认值: 1(不要关闭)。merge_max_block_size— 在块中进行合并操作时的最大行数限制。默认值:8192storage_policy— 存储策略。 参见 使用具有多个块的设备进行数据存储.min_bytes_for_wide_part,min_rows_for_wide_part在数据片段中可以使用Wide格式进行存储的最小字节数/行数。您可以不设置、只设置一个,或全都设置。参考:数据存储max_parts_in_total- 所有分区中最大块的数量(意义不明)max_compress_block_size- 在数据压缩写入表前,未压缩数据块的最大大小。您可以在全局设置中设置该值(参见max_compress_block_size)。建表时指定该值会覆盖全局设置。min_compress_block_size- 在数据压缩写入表前,未压缩数据块的最小大小。您可以在全局设置中设置该值(参见min_compress_block_size)。建表时指定该值会覆盖全局设置。max_partitions_to_read- 一次查询中可访问的分区最大数。您可以在全局设置中设置该值(参见max_partitions_to_read)。
表由按主键排序的数据片段(DATA PART)组成。
不同分区的数据会被分成不同的片段,ClickHouse 在后台合并数据片段以便更高效存储。不同分区的数据片段不会进行合并。合并机制并不保证具有相同主键的行全都合并到同一个数据片段中。
数据存储格式由 min_bytes_for_wide_part 和 min_rows_for_wide_part 表引擎参数控制。如果数据片段中的字节数或行数少于相应的设置值,数据片段会以 Compact 格式存储,否则会以 Wide 格式存储。
颗粒的大小通过表引擎参数 index_granularity 和 index_granularity_bytes 控制。颗粒的行数的在 [1, index_granularity] 范围中,这取决于行的大小。如果单行的大小超过了 index_granularity_bytes 设置的值,那么一个颗粒的大小会超过 index_granularity_bytes。在这种情况下,颗粒的大小等于该行的大小。
2. Log系列引擎
3. Integration系列引擎
4. Special系列引擎
Special系列引擎是为特定场景定制的,包括Memory、Buffer、File、Null等。这些引擎提供了键值存储、内存存储、文件存储等不同的数据管理方式
ClickHouse还提供了一些特殊用途的引擎,如Distributed用于分布式查询,MaterializedView用于聚合数据,Dictionary用于查询字典数据等.
Distributed
分布式引擎本身不存储数据, 但可以在多个服务器上进行分布式查询。 读是自动并行的。读取时,远程服务器表的索引(如果有的话)会被使用。
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster]
(
    name1 [type1] [DEFAULT|MATERIALIZED|ALIAS expr1],
    name2 [type2] [DEFAULT|MATERIALIZED|ALIAS expr2],
    ...
) ENGINE = Distributed(cluster, database, table[, sharding_key[, policy_name]])
[SETTINGS name=value, ...]
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster] AS [db2.]name2 ENGINE = Distributed(cluster, database, table[, sharding_key[, policy_name]]) [SETTINGS name=value, ...]
分布式引擎参数
cluster- 服务为配置中的集群名database- 远程数据库名table- 远程数据表名sharding_key- (可选) 分片keypolicy_name- (可选) 规则名,它会被用作存储临时文件以便异步发送数据
向集群写数据
一,自已指定要将哪些数据写入哪些服务器,并直接在每个分片上执行写入。换句话说,在分布式表上«查询»,在数据表上 INSERT。 这是最灵活的解决方案 – 你可以使用任何分片方案,对于复杂业务特性的需求,这可能是非常重要的。 这也是最佳解决方案,因为数据可以完全独立地写入不同的分片。
二,在分布式表上执行 INSERT。在这种情况下,分布式表会跨服务器分发插入数据。 为了写入分布式表,必须要配置分片键(最后一个参数)。当然,如果只有一个分片,则写操作在没有分片键的情况下也能工作,因为这种情况下分片键没有意义。
每个分片都可以在配置文件中定义权重。默认情况下,权重等于1。数据依据分片权重按比例分发到分片上。例如,如果有两个分片,第一个分片的权重是9,而第二个分片的权重是10,则发送 9 / 19 的行到第一个分片, 10 / 19 的行到第二个分片。
分片可在配置文件中定义 ‘internal_replication’ 参数。
此参数设置为«true»时,写操作只选一个正常的副本写入数据。如果分布式表的子表是复制表(*ReplicaMergeTree),请使用此方案。换句话说,这其实是把数据的复制工作交给实际需要写入数据的表本身而不是分布式表。
若此参数设置为«false»(默认值),写操作会将数据写入所有副本。实质上,这意味着要分布式表本身来复制数据。这种方式不如使用复制表的好,因为不会检查副本的一致性,并且随着时间的推移,副本数据可能会有些不一样。
选择将一行数据发送到哪个分片的方法是,首先计算分片表达式,然后将这个计算结果除以所有分片的权重总和得到余数。该行会发送到那个包含该余数的从’prev_weight’到’prev_weights + weight’的半闭半开区间对应的分片上,其中 ‘prev_weights’ 是该分片前面的所有分片的权重和,‘weight’ 是该分片的权重。例如,如果有两个分片,第一个分片权重为9,而第二个分片权重为10,则余数在 [0,9) 中的行发给第一个分片,余数在 [9,19) 中的行发给第二个分片。
分片表达式可以是由常量和表列组成的任何返回整数表达式。例如,您可以使用表达式 ‘rand()’ 来随机分配数据,或者使用 ‘UserID’ 来按用户 ID 的余数分布(相同用户的数据将分配到单个分片上,这可降低带有用户信息的 IN 和 JOIN 的语句运行的复杂度)。如果该列数据分布不够均匀,可以将其包装在散列函数中:intHash64(UserID)。
这种简单的用余数来选择分片的方案是有局限的,并不总适用。它适用于中型和大型数据(数十台服务器)的场景,但不适用于巨量数据(数百台或更多服务器)的场景。后一种情况下,应根据业务特性需求考虑的分片方案,而不是直接用分布式表的多分片。
SELECT 查询会被发送到所有分片,并且无论数据在分片中如何分布(即使数据完全随机分布)都可正常工作。添加新分片时,不必将旧数据传输到该分片。你可以给新分片分配大权重然后写新数据 - 数据可能会稍分布不均,但查询会正确高效地运行。
下面的情况,你需要关注分片方案:
- 使用需要特定键连接数据( IN 或 JOIN )的查询。如果数据是用该键进行分片,则应使用本地 IN 或 JOIN 而不是 GLOBAL IN 或 GLOBAL JOIN,这样效率更高。
- 使用大量服务器(上百或更多),但有大量小查询(个别客户的查询 - 网站,广告商或合作伙伴)。为了使小查询不影响整个集群,让单个客户的数据处于单个分片上是有意义的。或者 你可以配置两级分片:将整个集群划分为«层»,一个层可以包含多个分片。单个客户的数据位于单个层上,根据需要将分片添加到层中,层中的数据随机分布。然后给每层创建分布式表,再创建一个全局的分布式表用于全局的查询。
数据是异步写入的。对于分布式表的 INSERT,数据块只写本地文件系统。之后会尽快地在后台发送到远程服务器。发送数据的周期性是由distributed_background_insert_sleep_time_ms和distributed_background_insert_max_sleep_time_ms设置。分布式引擎会分别发送每个插入数据的文件,但是你可以使用distributed_background_insert_batch设置启用批量发送文件。该设置通过更好地利用本地服务器和网络资源来提高集群性能。你应该检查表目录/var/lib/clickhouse/data/database/table/中的文件列表(等待发送的数据)来检查数据是否发送成功。执行后台任务的线程数可以通过background_distributed_schedule_pool_size设置。
如果在 INSERT 到分布式表时服务器节点丢失或重启(如,设备故障),则插入的数据可能会丢失。如果在表目录中检测到损坏的数据分片,则会将其转移到«broken»子目录,并不再使用。
读取数据
当查询一个Distributed表时,SELECT查询被发送到所有的分片,不管数据是如何分布在分片上的(它们可以完全随机分布)。当您添加一个新分片时,您不必将旧数据传输到它。相反,您可以使用更重的权重向其写入新数据——数据的分布会稍微不均匀,但查询将正确有效地工作。
当启用max_parallel_replicas选项时,查询处理将在单个分片中的所有副本之间并行化。更多信息,请参见max_parallel_replicas。
常见问题
ClickHouse的Log系列引擎和MergeTree系列引擎在性能上有何区别?
性能差异
ClickHouse的Log系列引擎和MergeTree系列引擎在性能上的主要区别体现在数据的写入和查询操作上。
数据写入性能
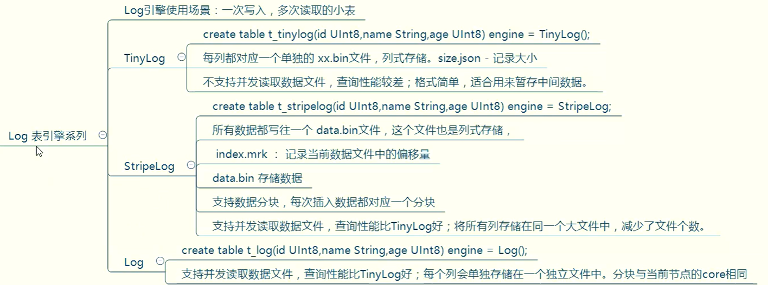
- Log系列引擎:这些引擎设计用于高性能的追加写入,适用于日志数据和其他追加写入场景。它们将数据按照追加顺序写入日志文件中,不涉及排序和聚合,因此在写入操作上表现出色,特别适合写密集型的应用场景。
- MergeTree系列引擎:这些引擎在写入数据时会根据指定的主键进行排序和聚合,并将数据写入多个数据文件。这种设计有助于提高查询性能,但相对于Log系列引擎,写入操作可能稍慢,因为涉及到排序和聚合过程。
查询性能
- Log系列引擎:由于数据存储方式的限制,查询大时间范围内的数据可能需要读取多个日志文件,这可能导致查询性能相对较低。
- MergeTree系列引擎:这些引擎提供了更高的查询性能,因为它们可以根据索引和数据文件的分布有效地定位和读取所需的数据。MergeTree引擎还支持数据分区和副本,进一步优化了查询性能。
综上所述,Log系列引擎在写入性能上优于MergeTree系列引擎,而MergeTree系列引擎在查询性能上更为优秀,尤其是在处理复杂的分析查询时。选择哪种类型的引擎取决于具体的应用场景和性能需求。
如何根据数据特性选择合适的ClickHouse表引擎?
考虑数据的特性、访问模式、写入要求、查询复杂度和数据冗余需求等因素
- 大数据量分析:对于需要存储和分析大量数据的场景,如用户行为分析、日志分析等,推荐使用MergeTree系列引擎。MergeTree引擎支持索引和数据分区,适用于大数据计算。
- 实时数据流:如果您需要处理实时数据流,可以考虑使用TinyLog引擎,它提供了简单的方式来存储数据,并且能够支持高并发的写入操作。
- 内存中数据处理:对于需要快速处理的数据,且数据量不大的情况,Memory引擎是一个不错的选择,因为它将数据存储在内存中,查询性能极佳,但数据在重启后会丢失。
- 分布式查询和跨集群数据复制:对于构建跨地域的数据分析系统或数据仓库,Distributed引擎可以将查询分发到多个ClickHouse集群中的节点上执行,并合并返回结果。
- 特殊用途:对于特定场景,如需要数据去重、汇总求和或聚合功能的场合,可以选择ReplacingMergeTree、SummingMergeTree或AggregatingMergeTree等引擎。
- 外部数据集成:如果您需要直接操作外部数据源,可以使用Integration系列引擎,如MySQL、HDFS等。
- 时间序列数据:对于时间序列数据,可以选择AggregatingMergeTree和SummingMergeTree,这些引擎提供了更好的聚合计算功能。
Distribute与mergeTree使用
上述 SQL 语句在 ClickHouse 中执行了两个不同的表创建操作,每个表在集群上具有不同的存储引擎和分片策略。以下是对每个表的详细解释:
1. 创建分片表
AppIdPhotoRecordTableShardCREATE TABLE IF NOT EXISTS opod_default_20220902_195522.AppIdPhotoRecordTableShard ON CLUSTER '{cluster}' (`timestamp` Int32, `dossier_id` String, `record_id` String) ENGINE = MergeTree PARTITION BY toYYYYMM(toDateTime(toUInt32(timestamp))) ORDER BY (timestamp, dossier_id) SETTINGS index_granularity = 8192;解释:
CREATE TABLE IF NOT EXISTS:如果表不存在则创建表。opod_default_20220902_195522.AppIdPhotoRecordTableShard:表的全名,包括数据库和表名。ON CLUSTER '{cluster}':指定在集群{cluster}上创建表。- 表结构:
timestamp:类型为Int32,存储时间戳。dossier_id:类型为String,存储文档ID。record_id:类型为String,存储记录ID。
- 存储引擎:
MergeTree,ClickHouse中常用的列存储引擎,适用于高性能的数据写入和查询。 - 分区:通过
PARTITION BY toYYYYMM(toDateTime(toUInt32(timestamp)))将数据按月分区。 - 排序键:
ORDER BY (timestamp, dossier_id),按timestamp和dossier_id排序,有助于高效的查询。 - 设置:
index_granularity = 8192,设置索引粒度为8192行。
2. 创建分布式表 AppIdPhotoRecordTable
CREATE TABLE IF NOT EXISTS opod_default_20220902_195522.AppIdPhotoRecordTable
ON CLUSTER '{cluster}' (`timestamp` Int32, `dossier_id` String, `record_id` String) ENGINE = Distributed('{cluster}', opod_default_20220902_195522, AppIdPhotoRecordTableShard, xxHash64(record_id));
解释:
CREATE TABLE IF NOT EXISTS:如果表不存在则创建表。opod_default_20220902_195522.AppIdPhotoRecordTable:表的全名,包括数据库和表名。ON CLUSTER '{cluster}':指定在集群{cluster}上创建表。- 表结构:
timestamp:类型为Int32,存储时间戳。dossier_id:类型为String,存储文档ID。record_id:类型为String,存储记录ID。
- 存储引擎:
Distributed,分布式引擎,用于将数据分布到多个节点上。 - 分布策略:使用
{cluster}作为集群名称,将数据分布到opod_default_20220902_195522数据库中的AppIdPhotoRecordTableShard表中,数据分布策略使用xxHash64(record_id)进行散列。
总结:
AppIdPhotoRecordTableShard表是一个实际存储数据的分片表,使用MergeTree引擎进行高效存储和查询。AppIdPhotoRecordTable表是一个分布式表,使用Distributed引擎,将数据分布到多个AppIdPhotoRecordTableShard分片表中,以实现数据的分布式存储和处理。
No comments yet.