目录
一、语法
main函数执行之前,主要就是初始化系统相关资源:
初始化静态 static 变量和 global 全局变量,即 .data 段的内容
为 NULL 等等,即 .bss 段的内容
将main函数的参数 argc , argv 等传递给 main 函数,然后才真正运行 main 函数
main函数执行之后:
可以用 atexit 注册一个函数,它会在main 之后执行;
2、alignof计算出类的对齐方式
typedef struct info {
    uint8_t a;
    uint16_t b;
    uint8_t c;
} info;


int main() {
    info in;
    cout << sizeof(in) << endl;     // 6
    cout << alignof(in) << endl;    // 2
    return 0;
}
alignof(in) = 2说明是按照2字节对齐。
字节对齐的准则:
1、结构体变量的首地址能被其最宽数据类型成员的大小整除
2、结构体每个成员相对于结构体首地址的偏移量都是该成员本身大小的整数倍,多的填充字节
3、结构体变量所占总空间的大小必定是最宽数据类型大小的整数倍。多的在末尾填充字节。
可以参考一下:
1、指针有自己空间,引用是一个别名
2、sizeof指针为4,引用是被引用对象的大小
3、指针可以初始化为NULL,引用被初始化必须是一个已有对象的引用
4、指针可以指向其他对象,引用只能是一个对象的引用,不能被改变(初始化之后不可再改变)
5、指针可以多级,引用只有1级
6、返回动态内存分配的对象,使用指针。4、常量指针与指针常量
- 指针常量是一个指针,读成常量的指针,指向一个只读变量。如int const *p或const int *p。
- 常量指针是一个不能给改变指向的指针。指针是个常量,不能中途改变指向,如int *const p。
5、数组名和指针(这里为指向数组首元素的指针)区别
数组名不是真正意义上的指针,可以理解为常指针,所以数组名没有自增、自减等操作
作,但sizeof运算符不能再得到原数组的大小了
6、野指针和悬空指针
int main(void) {

    int* p;     // 未初始化
    std::cout<< *p << std::endl; // 未初始化就被使用

    return 0;
}
悬空指针,指针最初指向的内存已经被释放了的一种指针。继续使用该指针,行为不可预料。
c++引入了智能指针,C++智能指针的本质就是避免悬空指针的产生。
7、static关键字的作用
8、const与static区别
static
- 不考虑类的情况
隐藏。所有不加static的全局变量和函数具有全局可见性,可以在其他文件中使用,加了之后
只能在该文件所在的编译模块中使用
默认初始化为0,包括未初始化的全局静态变量与局部静态变量,都存在全局未初始化区
静态变量在函数内定义,始终存在,且只进行一次初始化,具有记忆性,其作用范围与局部
变量相同,函数退出后仍然存在,但不能使用
- 考虑类的情况
static成员变量:只与类关联,不与类的对象关联。定义时要分配空间,不能在类声明中初始
化,必须在类定义体外部初始化,初始化时不需要标示为static;可以被非static成员函数任
意访问。
static成员函数:不具有this指针,无法访问类对象的非static成员变量和非static成员函数;
不能被声明为const、虚函数和volatile;可以被非static成员函数任意访问
const
- 不考虑类的情况
- const常量在定义时必须初始化,之后无法更改
- const形参可以接收const和非const类型的实参,例如
- 考虑类的情况
const成员变量:不能在类定义外部初始化,只能通过构造函数初始化列表进行初始化,并且
必须有构造函数;不同类对其const数据成员的值可以不同,所以不能在类中声明时初始化
const成员函数:const对象不可以调用非const成员函数;非const对象都可以调用;不可以
改变非mutable(用该关键字声明的变量可以在const成员函数中被修改)数据的值
正确的在C++代码中调用C语言的代码:在程序中加上extern "C"后,相当于告诉编译器这部分代码是C语言写的,因此要按照C语言进行编译,而不是C++
#ifndef __MY_HANDLE_H__
#define __MY_HANDLE_H__
extern "C"{
  typedef unsigned int result_t;
  typedef void* my_handle_t;
  my_handle_t create_handle(const char* name);
  result_t operate_on_handle(my_handle_t handle);
  void close_handle(my_handle_t handle);
}
c++调用c函数时:
c调用c++函数时:
// xx.h extern "C"{ int add(); } // xx.cpp int add(){ } // xx.c extern int add();10、inline与宏定义区别
数可以直接嵌入到目标代码中。
- 使用宏定义的地方都可以使用inline函数
- 作为类成员接口函数来读写类的私有成员或者保护成员,会提高效率
内联函数以代码复杂为代价,它以省去函数调用的开销来提高执行效率。所以一方面如果内联函数体内
代码执行时间相比函数调用开销较大,则没有太大的意义;另一方面每一处内联函数的调用都要复制代
码,消耗更多的内存空间,因此以下情况不宜使用内联函数:
主要区别
内联函数直接嵌入到目标代码中,宏是简单的做文本替换
内联函数是函数,宏不是
内联函数代码是被放到符号表中,使用时像宏一样展开,没有调用的开销,效率很高;
因为inline同register一样,只是个建议,编译器并不一定真正的内联
11、inline对于构造函数、析构函数、虚函数是否有意义
编译器并不真正对声明为inline的构造和析构函数进行内联操作,因为编译器会在构造和析构函数中添加额外的 操作(申请/释放内存,构造/析构对象等),致使构造函数/析构函数并不像看上去的那么精简。其次class中的函数默认是inline型的,编译器也只是有选择性的inline,将构造函数和析构函数声明为内联函数是没有什么意义的。
有的人认为虚函数被声明为inline,但是编译器并没有对其内联,他们给出的理由是inline是编译期决定
上述观点看似正确,其实不然,如果虚函数在编译器就能够决定将要调用哪个函数时,就能够内联,那
时,就内联展开.
12、volatile、mutable、explicit关键词用法
volatile
volatile 指针和 const 修饰词类似,const 有常量指针和指针常量的说法,volatile 也有相应的概念
const char* cpch;
volatile char* vpch;
指针自身的值——一个代表地址的整数变量,是 const 或 volatile 的
可以把一个非volatile int赋给volatile int,但是不能把非volatile对象赋给一个volatile对象。
C++中一个有volatile标识符的类只能访问它接口的子集,一个由类的实现者控制的子集。用户只
员。
用volatile声明,该关键字的作用是防止优化编译器把变量从内存装入CPU寄存器中。如果变量被装入
执行。volatile的意思是让编译器每次操作该变量时一定要从内存中真正取出,而不是使用已经存在寄
mutable
mutable的中文意思是“可变的,易变的”,跟constant(既C++中的const)是反义词。在C++中,
mutable也是为了突破const的限制而设置的。被mutable修饰的变量,将永远处于可变的状态,即使在
一个const函数中。我们知道,如果类的成员函数不会改变对象的状态,那么这个成员函数一般会声明
成const的。但是,有些时候,我们需要在const函数里面修改一些跟类状态无关的数据成员,那么这个
函数就应该被mutable来修饰,并且放在函数后后面关键字位置.
explicit关键字用来修饰类的构造函数,被修饰的构造函数的类,不能发生相应的隐式类型转换,只能以
explicit 关键字只能用于类内部的构造函数声明上
被explicit修饰的构造函数的类,不能发生相应的隐式类型转换
13、const作为成员函数的修饰符
const int func() {} int func() const {}第一个情况:返回值为const int类型的成员函数。返回值是一个常量,不能被修改。
第二个情况:不会修改对象的状态,常量成员函数可以被常量对象和非常量对象调用。因此常量成员函数可以用于读取对象的状态,但不能修改对象的非
mutable成员变量。在这个函数中,const修饰符表示这个函数是一个常量成员函数,不能修改对象的状态。二、内存分布
1、类的对象存储空间
- 非静态成员的数据类型大小之和。
- 编译器加入的额外成员变量(如指向虚函数表的指针)。
- 为了边缘对齐优化加入的padding。
空类(无非静态数据成员)的对象的size为1.
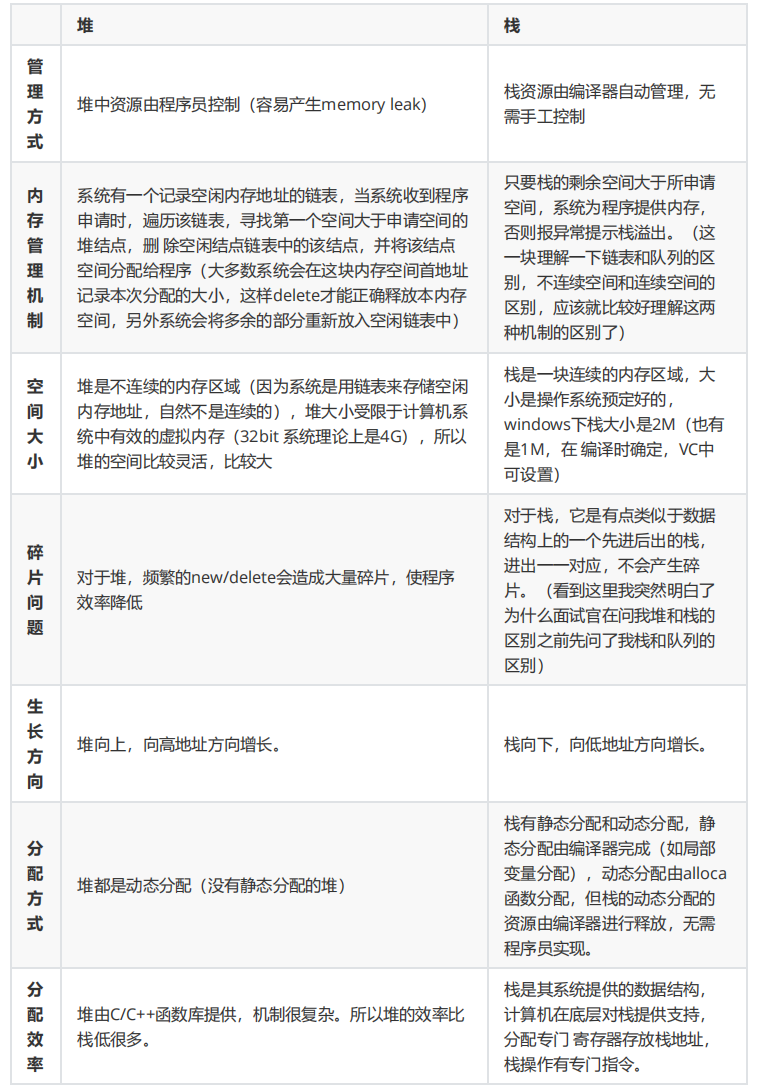
4、堆、栈区别
5、C/C++内存分布
虚拟内存被分为代码段、数据段、bss段、堆区、文件映射区、栈区。
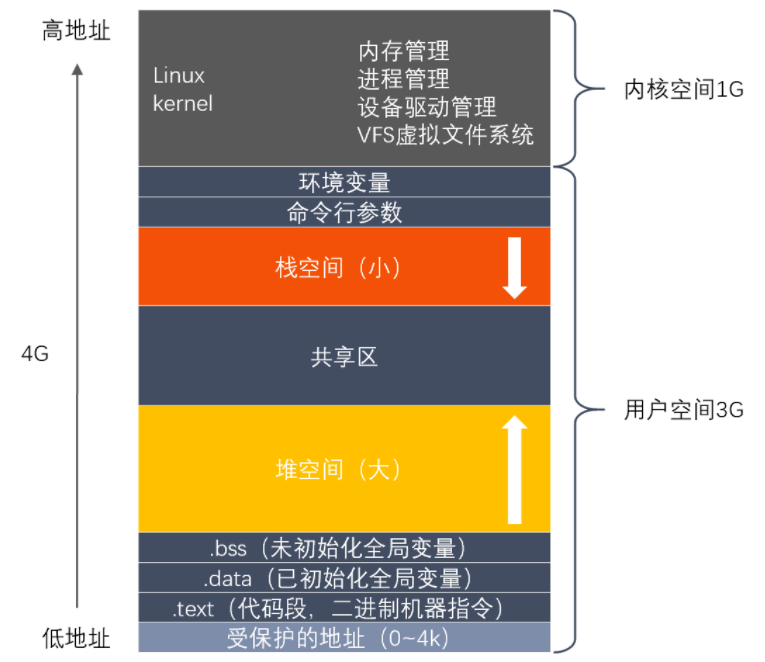
栈:存储函数的返回地址、参数、局部变量、返回值
映射区:存储动态链接库以及调用mmap函数进行文件映射
堆区:程序员动态分配内存,并由程序员手动释放
bss段:存储未初始化的全局变量和静态变量
数据段:存储程序中已经初始化的全局变量和静态变量
代码段:只读存储区、文本区。只读存储区存储字符串常量、文本区存储程序的代码
6、虚函数表、虚函数指针、虚函数的内存分布
首先整理一下虚函数表的特征:
虚函数表是全局共享的元素,即全局仅有一个,在编译时就构造完成
虚函数表类似一个数组,类对象中存储vptr指针,指向虚函数表,即虚函数表不是函数,不是程序
代码,不可能存储在代码段
虚函数表存储虚函数的地址,即虚函数表的元素是指向类成员函数的指针,而类中虚函数的个数在编
译时期可以确定,即虚函数表的大小可以确定,即大小是在编译时期确定的,不必动态分配内存空
间存储虚函数表,所以不在堆中
虚函数表类似于类中的静态成员变量,静态成员也是全局共享,大小确定的。
虚函数表vtable在Linux/Unix中存放在可执行文件的只读数据段中(rodata)
由于虚表指针vptr跟虚函数密不可分,对于有虚函数或者继承于拥有虚函数的基类,对该类进行实例化
时,在构造函数执行时会对虚表指针进行初始化,并且存在对象内存布局的最前面。
C++中虚函数表位于只读数据段(.rodata),也就是C++内存模型中的常量区;而虚函数则位于代码段
(.text),也就是C++内存模型中的代码区。
7、new/delete 与malloc与free区别
都可用于内存的动态申请和释放
前者是C++运算符,后者是C/C++语言标准库函数
new自动计算要分配的空间大小,malloc需要手工计算
new是类型安全的,malloc不是
new调用名为operator new的标准库函数分配足够空间并调用相关对象的构造函数,delete对指
针所指对象运行适当的析构函数;然后通过调用名为operator delete的标准库函数释放该对象所
用内存。后者均没有相关调用
后者需要库文件支持,前者不用
new是封装了malloc,直接free不会报错,但是这只是释放内存,而不会析构对象
详情可以参见:
8、如何代码判断大小端存储
32bit的数字0x12345678
大端存储:字数据的高字节存储在低地址中

小端存储:字数据的低字节存储在低地址中
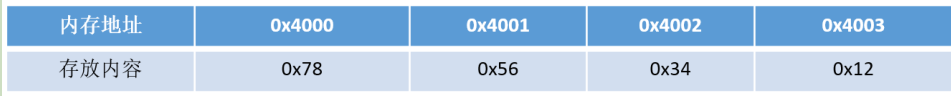
在Socket编程中,往往需要将操作系统所用的小端存储的IP地址转换为大端存储,这样才能进行网
络传输
下面介绍两种方法:
我们可以根据联合体来判断该系统是大端还是小端。因为联合体变量总是从低地址存储。
随意找一个2字节的十六进制数值,如0x1234
bool isNetByteOrder() { unsigned short mode = 0x1234; char* pmode = (char*) &mode; // 如果将低字节放在低位,则是小端字节序 return (*pmode != 0x34); }9、给一个类,里面有static、virtual,说一下内存分布
给一个类,里面有static、virtual,说一下内存分布
三、类&对象
其他
https://blog.csdn.net/QcloudCommunity/article/details/126188178
四、STL容器
new、placement new、operator new
五、modern c++
六、模板
七、常见数据结构的简单实现
八、多线程
volatile关键字和原子变量(std::atomic)在多线程编程中的作用一、 **
volatile**的作用与局限性核心功能:防止编译器优化
volatile的主要作用是告知编译器不要对被修饰的变量进行优化。具体表现为:• 禁止缓存:每次访问变量时都从内存中读取最新值,而非使用寄存器中的缓存。
• 禁止移除操作:即使看似冗余的读写操作也不会被优化掉。
• 限制指令重排:编译器不会对
volatile变量的访问顺序进行重排。典型应用场景
• 硬件交互:访问内存映射的硬件寄存器或I/O设备时,确保每次读写直接作用于硬件。
• 信号处理:在信号处理函数中修改变量时,避免编译器优化导致主程序无法感知变化。
• 调试辅助:临时禁用优化以便观察变量变化。
多线程中的局限性
• 不保证原子性:对
volatile变量的复合操作(如++)可能被分解为多个步骤,导致数据竞争。• 无同步机制:无法确保多线程间的操作顺序一致性,可能导致线程间数据不一致。
• 缺乏内存屏障:无法阻止处理器级别的指令重排,可能导致不可预测的行为。
二、原子变量的优势与替代原因
原子性保证
std::atomic确保对变量的操作(如读、写、自增等)是原子的,即不会被其他线程中断。例如:内存顺序控制
counter.store(true, std::memory_order_release); // 写入操作的内存顺序控制线程同步机制
• 可见性:原子变量的修改对所有线程立即可见,无需依赖
volatile的强制内存访问。• 避免忙等待:原子变量可与条件变量结合,替代
volatile的忙等待循环。性能与安全性的平衡
• 无锁设计:原子操作通常比互斥锁更高效,且避免死锁风险。
• 编译器优化友好:原子变量允许编译器在保证线程安全的前提下进行合理优化。
三、为什么现代多线程编程优先使用原子变量?
**
volatile**不解决线程安全问题即使变量声明为
volatile,多线程下的复合操作仍可能引发竞态条件。例如:原子变量是C++标准的多线程解决方案
适用场景明确分工
• 原子变量:专为多线程设计,解决数据竞争、原子操作和内存可见性问题。
总结
• 使用原子变量的场景:多线程共享变量、需要原子操作或内存顺序控制的场景。
现代C++中,原子变量因其安全性、性能和标准化支持,已成为多线程编程的首选工具,而
volatile仅在特定底层场景中保留其价值。
No comments yet.